Rutube تنتقل من تجربة أولية على Whisper إلى منصة خاصة للترجمة النصية والتعرّف على الكلام
أوضحت Rutube لماذا لم يكن تشغيل Whisper وحده كافيًا لإنتاج ترجمات نصية لمقاطع المستخدمين. فبعد التجربة الأولية، كان على الخدمة أن تتعامل مع ملايين المقاطع الجديدة، وتسجيلات تصل مدتها إلى 24 ساعة، وصوت مشوَّش، ولغات متعددة. وفي النهاية انتقل الفريق إلى بنية الخدمات المصغّرة ونظام ASR خاص، وحقق أداءً يبلغ نحو 1200 فيديو في الساعة لكل نظام ASR.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News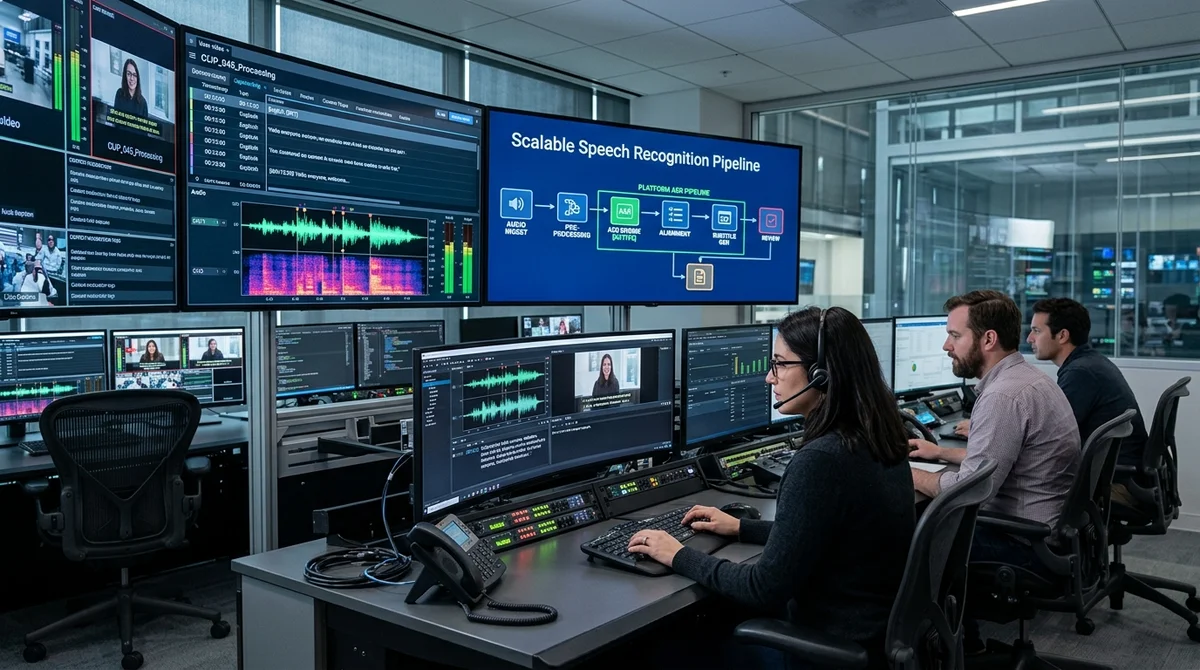
وصفت Rutube كيف أطلقت الترجمة النصية التلقائية لمقاطع المستخدمين: بدأت بتجربة أولية سريعة على Whisper، ثم انتقلت إلى منصة ASR خاصة بها. وجاء هذا الانتقال بعد أن اتضح للفريق أن التعرّف على الكلام في عرض تجريبي ومعالجة التدفق الكامل من المحتوى بثبات مهمتان مختلفتان تمامًا.
لماذا لم يكفِ Whisper
في البداية كان Whisper خيارًا مناسبًا لاختبار الفرضية. فقد أتاح بناء أول خدمة بسرعة، وإطلاق الترجمات النصية في بيئة الإنتاج، والتأكد من أن المستخدمين يحتاجون هذه الميزة فعلًا. لكن بعد الإطلاق ظهرت قيود يصعب رصدها في مرحلة التجربة الأولية: فالمنصة تستقبل ملايين المقاطع الجديدة، ويمتد بعضها إلى 24 ساعة، وقد يكون الصوت مشوَّشًا، واللغة غير معروفة مسبقًا. يضاف إلى ذلك متطلبات جودة النص وحدود صارمة لسرعة المعالجة، لأن الترجمات النصية يجب أن تظهر ضمن إيقاع عمل الخدمة، لا في وقت لاحق غير محدد.
بين «التعرّف على الكلام» و«إنتاج ترجمات نصية لكل المحتوى» تقع مساحة
ضخمة من العمل.
وهذه الفجوة بالذات كانت الخلاصة الرئيسية للفريق. فمع مقاطع المستخدمين لا يكفي تمرير المسار الصوتي عبر نموذج جاهز وحفظ النتيجة. المطلوب هو المنظومة المحيطة بعملية التعرّف كلها: معالجة الملفات الطويلة، والصمود أمام رداءة الصوت، ومراقبة جودة النص، وإدارة الطوابير، وأداء متوقَّع تحت تدفق كبير. وبدون ذلك يتحول حتى نموذج ASR جيد إلى عنق زجاجة لا يتحمل الأحمال الصناعية.
إلى ماذا تطوّر النظام
في النهاية لم تعد المهمة «خدمة أخرى قائمة على ASR»، بل أصبحت منصة متكاملة للترجمات النصية. وتذكر Rutube أنها اضطرت لهذا الغرض إلى الانتقال إلى بنية الخدمات المصغّرة ونظام تعرّف على الكلام خاص بها. ولم يكن هذا النهج اتباعًا لموضة تقنية، بل من أجل فصل المسؤوليات: جزء من النظام يتولى استقبال الفيديو وتجهيزه، وجزء ثانٍ يتولى التعرّف نفسه، وثالث يتولى تجميع النتيجة وتسليمها. وعلى الأحجام الكبيرة يصبح ذلك حاسمًا، لأنه يتيح توسيع كل مكوّن على حدة، ولا يُعطّل خط المعالجة كله بسبب ضغط زائد في نقطة واحدة.
وتتطلب منصة كهذه عدة شروط في آنٍ واحد:
- استقبال تدفق من ملايين المقاطع الجديدة دون تدخل يدوي
- معالجة مقاطع تصل مدتها إلى 24 ساعة دون انهيار خط المعالجة
- التعامل مع لغة غير معروفة وصوت مستخدمين مشوَّش
- الحفاظ على جودة النص بمستوى يكفي للنشر
- الالتزام بقيود السرعة وتكلفة المعالجة
ويبدو الانتقال إلى نظام ASR خاص منطقيًا في هذا السياق. فحين يعمل المنتج على محتوى المستخدمين الضخم (UGC)، يساعد النموذج الخارجي العام على الانطلاق، لكنه لا يناسب كثيرًا الضبط الدقيق وفق البيانات الحقيقية وقيود البنية التحتية والمقاييس المستهدفة. أما النظام الخاص فيمنح تحكمًا أكبر في السرعة والجودة والموارد، وفي كيفية تصرف التعرّف في الحالات الصعبة التي تُعدّ على منصة الفيديو هي القاعدة لا الاستثناء.
كيف تحققت السرعة
أبرز رقم في قصة Rutube هو الأداء البالغ نحو 1200 فيديو في الساعة لكل نظام ASR. وهو مؤشر مهم، لأن جودة التعرّف في بيئة الإنتاج لا يمكن النظر إليها بمعزل عن الطاقة الاستيعابية. فإذا أنتج النظام نصًا جيدًا لكنه راكم طابورًا من آلاف المقاطع، فلن يفيد المستخدم ذلك كثيرًا. وإن كان خط المعالجة سريعًا لكنه غير مستقر مع الفيديوهات الطويلة أو الصوت الرديء، فسيبدأ المنتج بالتعطل مجددًا في التشغيل الفعلي. لذلك فإن البنية هنا لا تقل أهمية عن النموذج نفسه.
ولا يقف خلف هذا الرقم خوارزمية واحدة ناجحة، بل سلسلة من القرارات الهندسية: كيفية تقطيع الصوت وتغذية النظام به، وكيفية توزيع المهام، وكيفية تجنب إضاعة الوقت في مراحل غير فعّالة، وكيفية إبقاء الموارد تحت السيطرة. وهناك أيضًا الجانب الاقتصادي. فكلما ارتفع الإنتاجية (throughput) لكل نسخة ASR، سهل توسيع الخدمة دون ارتفاع حاد في تكاليف البنية التحتية. وبالنسبة للمنصات ذات التدفق المستمر من محتوى المستخدمين، لم يعد هذا مسألة راحة، بل هو الاقتصاد الأساسي للمنتج.
ماذا يعني ذلك
تُظهر قصة Rutube بوضوح الحدّ الفاصل بين النموذج الأولي السريع للذكاء الاصطناعي والمنتج الناضج. فالنموذج الجاهز مثل Whisper يساعد على الانطلاق بسرعة، لكن الخدمة الجماهيرية تتطلب بنية خاصة بها، ومراقبة للجودة، وتحسينًا وفق الأحمال الفعلية. وهذه إشارة مباشرة لكل من يبني ميزات ذكاء اصطناعي فوق محتوى المستخدمين: فعنق الزجاجة لا يكمن عادةً في نموذج واحد، بل في خط المعالجة كله المحيط به.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا لم يكفِ Whisper؟
في البداية كان Whisper خيارًا مناسبًا لاختبار الفرضية. فقد أتاح بناء أول خدمة بسرعة، وإطلاق الترجمات النصية في بيئة الإنتاج، والتأكد من أن المستخدمين يحتاجون هذه الميزة فعلًا. لكن بعد الإطلاق ظهرت قيود يصعب رصدها في مرحلة التجربة الأولية: فالمنصة تستقبل ملايين المقاطع الجديدة، ويمتد بعضها إلى 24 ساعة، وقد يكون الصوت مشوَّشًا، واللغة غير معروفة مسبقًا. يضاف إلى ذلك متطلبات جودة النص وحدود صارمة لسرعة المعالجة، لأن الترجمات النصية يجب أن تظهر ضمن إيقاع عمل الخدمة، لا في وقت لاحق غير محدد. بين «التعرّف على الكلام» و«إنتاج ترجمات نصية لكل المحتوى» تقع مساحة ضخمة من العمل. وهذه
ما أبرز التفاصيل حول إلى ماذا تطوّر النظام؟
في النهاية لم تعد المهمة «خدمة أخرى قائمة على ASR»، بل أصبحت منصة متكاملة للترجمات النصية. وتذكر Rutube أنها اضطرت لهذا الغرض إلى الانتقال إلى بنية الخدمات المصغّرة ونظام تعرّف على الكلام خاص بها. ولم يكن هذا النهج اتباعًا لموضة تقنية، بل من أجل فصل المسؤوليات: جزء من النظام يتولى استقبال الفيديو وتجهيزه، وجزء ثانٍ يتولى التعرّف نفسه، وثالث يتولى تجميع النتيجة وتسليمها. وعلى الأحجام الكبيرة يصبح ذلك حاسمًا، لأنه يتيح توسيع كل مكوّن على حدة، ولا يُعطّل خط المعالجة كله بسبب ضغط زائد في نقطة واحدة. وتتطلب منصة كهذه عدة شروط في آنٍ واحد: استقبال تدفق من ملايين المقاطع الجديدة د
ما أبرز التفاصيل حول كيف تحققت السرعة؟
أبرز رقم في قصة Rutube هو الأداء البالغ نحو 1200 فيديو في الساعة لكل نظام ASR. وهو مؤشر مهم، لأن جودة التعرّف في بيئة الإنتاج لا يمكن النظر إليها بمعزل عن الطاقة الاستيعابية. فإذا أنتج النظام نصًا جيدًا لكنه راكم طابورًا من آلاف المقاطع، فلن يفيد المستخدم ذلك كثيرًا. وإن كان خط المعالجة سريعًا لكنه غير مستقر مع الفيديوهات الطويلة أو الصوت الرديء، فسيبدأ المنتج بالتعطل مجددًا في التشغيل الفعلي. لذلك فإن البنية هنا لا تقل أهمية عن النموذج نفسه. ولا يقف خلف هذا الرقم خوارزمية واحدة ناجحة، بل سلسلة من القرارات الهندسية: كيفية تقطيع الصوت وتغذية النظام به، وكيفية توزيع المهام، و
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.