PageIndex من VectifyAI تقترح بحثًا بلا تضمينات (Embeddings) في المستندات الطويلة
تقترح PageIndex من VectifyAI نهجًا مختلفًا للتعامل مع المستندات الطويلة: فبدلًا من الأجزاء النصية (chunks) وقاعدة البيانات المتجهية، يبني النظام فهرسًا هرميًا مع ملخصات، ثم يمرّر إلى LLM الصفحات المطلوبة فقط. الفكرة قوية في ملفات PDF المالية والقانونية والتقنية، لكن الدقة لها ثمن: استهلاك أكبر للرموز (tokens)، وبطء في الاستجابة، وضعف في التوسع على مجموعات المستندات الكبيرة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News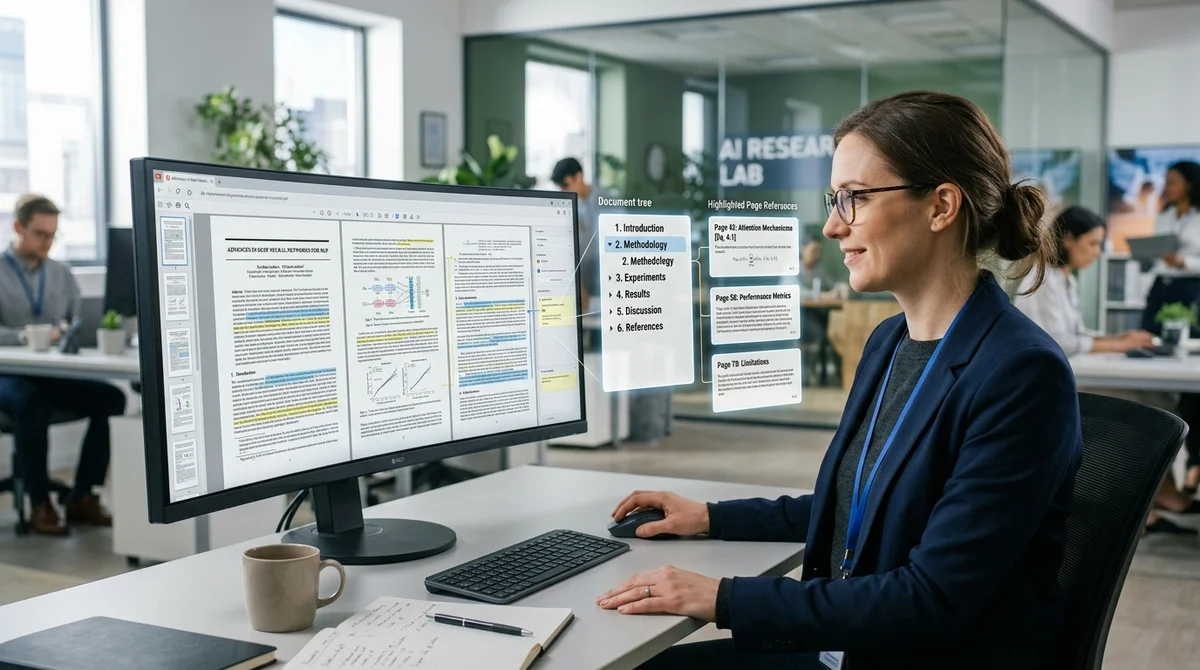
يُعدّ PageIndex من أبرز المنافسين الجدد على لقب «RAG بلا قاعدة بيانات متجهية». فبدلًا من المخطط المعتاد القائم على التضمينات والأجزاء النصية (chunks)، يبني النظام للمستند فهرسًا هرميًا مع أوصاف موجزة للأقسام، ثم يطلب من LLM أن يختار منطقيًا العُقد ذات الصلة والصفحات المرتبطة بها. يبدو هذا النهج جديدًا، وقد يعمل في ملفات PDF الطويلة المنظَّمة جيدًا بصورة أقرب إلى الطريقة التي يقرأ بها الإنسان المستند.
كيف يعمل PageIndex
آلية PageIndex بسيطة نسبيًا. يُقسَّم المستند أولًا إلى صفحات، ثم يجمع النموذج مع شيفرة مساعدة فهرس محتويات (TOC) موسّعًا، وهو شجرة أقسام تضم العناوين ونطاقات الصفحات وملخصًا لكل عقدة. وعند وصول سؤال، لا يُرسَل إلى الموجِّه (prompt) المستند كاملًا ولا مجموعة مقتطفات عشوائية من النص، بل هذه البنية تحديدًا. يختار LLM فروع الشجرة ذات الصلة، ثم لا يُضاف إلى الطلب النهائي إلا الصفحات المرتبطة بها. والنتيجة نظام يستغني عن التضمينات، وعن المخزن المتجهي، وعن التقطيع الاصطناعي الذي كثيرًا ما يُفسد المعنى عند حدود المقاطع.
لماذا يثير المشروع الاهتمام
لهذا السبب تحديدًا يحظى PageIndex بهذا القدر من الاهتمام. ففي التقارير المالية الطويلة، والمستندات القانونية، والأدلة التقنية، والمواد التعليمية، يبدو هذا النهج طبيعيًا: فالإنسان أيضًا يبدأ عادةً بالفهرس، ولا يتصفح النص مقطعًا بعد مقطع. وفي مستودع المشروع، يضع مطورو VectifyAI النظام صراحةً ضمن فئة reasoning-based retrieval، ويؤكدون أنه ساعد في بلوغ دقة 98,7% على FinanceBench. وبالنسبة إلى الفرق التي تعمل على مستند واحد كبير أو على مجموعة صغيرة من ملفات PDF المعقدة، يبدو ذلك بديلًا قويًا لمسار RAG المعتاد، خصوصًا إذا كان الهدف بحثًا أكثر قابلية للتفسير مع إحالات واضحة إلى الأقسام والصفحات.
أين حدود هذا النهج
لكن السؤال الرئيس ليس ما إذا كان بالإمكان استبدال البحث المتجهي بـ PageIndex، بل أين تقع حدود هذا النهج. والانتقادات هنا واقعية إلى حد بعيد. أولًا، يحتاج فهرس المحتويات (TOC) أيضًا إلى مكان يُخزَّن فيه، خاصة إذا زاد عدد المستندات على واحد، لذا فالحديث عن «غياب الفهرس كليًا» فيه شيء من المبالغة.
ثانيًا، لا تزال استراتيجية مقنعة لاختيار المستندات في المجموعات الكبيرة غائبة: فالبيانات الوصفية (metadata) والبحث بالكلمات المفتاحية وTF-IDF وBM25 لا تختفي، وكثيرًا ما تبقى مرشِّحًا أول زهيد الكلفة. ثالثًا، يكون الاسترجاع القائم على الاستدلال (reasoning retrieval) شبه حتمًا أغلى من حيث الرموز (tokens) وأبطأ من حيث زمن الاستجابة. وإذا كان RAG المتجهي الجيد يمنح بالفعل نحو 90% من الجودة، فقد تكلّف النسب الإضافية من الدقة أضعافًا مضاعفة، وليس هذا التبادل معقولًا لكل منتج.
القيود العملية والتشغيل
وتُظهر التجربة العملية قيودًا أيضًا. يشير أحد التحليلات إلى أن PageIndex تعامل بصورة سيئة مع النص الأدبي الخالي من بنية واضحة: فإن لم تكن في المستند أقسام وعناوين، فلا يوجد ما يُبنى عليه «فهرس ذكي». أما مع النص الأكاديمي فكانت النتائج أفضل، لأن فيه تسلسلًا هرميًا سليمًا للأقسام. ويمكن تشغيل النظام محليًا عبر المستودع المفتوح: تثبيت التبعيات، وتحديد مفتاح API لـ LLM متوافق عبر LiteLLM، ثم تمرير ملف PDF أو markdown عبر run_pageindex.py. لكن هنا أيضًا بعض التفاصيل: إذ يحذّر المؤلف تحديدًا من إصدار LiteLLM، وينصح بعدم تثبيت حزمة pageindex السحابية من pip للعمل المحلي، ويذكر أن جودة الشجرة تتراجع بوضوح مع النماذج المحلية الضعيفة، وأن العملية قد تستغرق عشرات الدقائق حتى لمستند صغير نسبيًا.
ماذا يعني ذلك عمليًا
ماذا يعني ذلك عمليًا؟ لا يبدو PageIndex قاتلًا للبحث المتجهي، لكنه يبدو طبقة جديدة مفيدة في معمارية RAG. والأنسب النظر إليه لا بوصفه بديلًا مباشرًا، بل أداة متخصصة للمستندات الطويلة المنظَّمة، حيث تهم القابلية للتفسير ودقة التنقل والعمل على مستوى الصفحات. والسيناريو الأكثر واقعية هو الهجين: بحث زهيد الكلفة أولًا عبر البيانات الوصفية أو المتجهات، ثم PageIndex للاختيار الدقيق للأقسام. وهذا الحل الوسط يعكس الواقع على نحو أفضل: لم يظهر بعد بديل شامل لـ RAG المتجهي، لكن للمقاربات التي تنطلق من بنية المستند، مثل PageIndex، موقعًا واضحًا خاصًا بها.
باختصار:
- PageIndex من VectifyAI هو «RAG بلا قاعدة بيانات متجهية»: يبني فهرسًا هرميًا ويطلب من LLM اختيار العُقد والصفحات ذات الصلة.
- يستغني النظام عن التضمينات والتقطيع؛ ويعلن المطورون دقة 98,7% على FinanceBench.
- الأقرب إلى الواقع النظر إلى PageIndex بوصفه طبقة للمستندات الطويلة المنظَّمة ضمن مخطط هجين، لا بديلًا لـ RAG المتجهي.
- 28 أكتوبر 2026Anthropic تكشف كيف تبني Claude بواسطة Claude: الدماغ منفصل عن الأيدي
- 28 أكتوبر 2026Bayer تطلق محركًا متعدد الوكلاء على AgentCore: 80% من الأسئلة دون مهندسين
- 28 أكتوبر 2026Liquid AI تطلق LFM2.5-24B-A2B: وكيل ذكي بمعاملات نشطة لا تتجاوز 2B
- 28 أكتوبر 2026AgentOrch: الخطة المُعدَّة مسبقاً لوكيل الذكاء الاصطناعي تتراجع بمقدار 8.5 نقطة فقط أمام النهج التدريجي
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف يعمل PageIndex؟
آلية PageIndex بسيطة نسبيًا. يُقسَّم المستند أولًا إلى صفحات، ثم يجمع النموذج مع شيفرة مساعدة فهرس محتويات (TOC) موسّعًا، وهو شجرة أقسام تضم العناوين ونطاقات الصفحات وملخصًا لكل عقدة. وعند وصول سؤال، لا يُرسَل إلى الموجِّه (prompt) المستند كاملًا ولا مجموعة مقتطفات عشوائية من النص، بل هذه البنية تحديدًا. يختار LLM فروع الشجرة ذات الصلة، ثم لا يُضاف إلى الطلب النهائي إلا الصفحات المرتبطة بها. والنتيجة نظام يستغني عن التضمينات، وعن المخزن المتجهي، وعن التقطيع الاصطناعي الذي كثيرًا ما يُفسد المعنى عند حدود المقاطع.
ما أبرز التفاصيل حول لماذا يثير المشروع الاهتمام؟
لهذا السبب تحديدًا يحظى PageIndex بهذا القدر من الاهتمام. ففي التقارير المالية الطويلة، والمستندات القانونية، والأدلة التقنية، والمواد التعليمية، يبدو هذا النهج طبيعيًا: فالإنسان أيضًا يبدأ عادةً بالفهرس، ولا يتصفح النص مقطعًا بعد مقطع. وفي مستودع المشروع، يضع مطورو VectifyAI النظام صراحةً ضمن فئة reasoning-based retrieval، ويؤكدون أنه ساعد في بلوغ دقة 98,7% على FinanceBench. وبالنسبة إلى الفرق التي تعمل على مستند واحد كبير أو على مجموعة صغيرة من ملفات PDF المعقدة، يبدو ذلك بديلًا قويًا لمسار RAG المعتاد، خصوصًا إذا كان الهدف بحثًا أكثر قابلية للتفسير مع إحالات واضحة إلى ال
ما أبرز التفاصيل حول أين حدود هذا النهج؟
لكن السؤال الرئيس ليس ما إذا كان بالإمكان استبدال البحث المتجهي بـ PageIndex، بل أين تقع حدود هذا النهج. والانتقادات هنا واقعية إلى حد بعيد. أولًا، يحتاج فهرس المحتويات (TOC) أيضًا إلى مكان يُخزَّن فيه، خاصة إذا زاد عدد المستندات على واحد، لذا فالحديث عن «غياب الفهرس كليًا» فيه شيء من المبالغة. ثانيًا، لا تزال استراتيجية مقنعة لاختيار المستندات في المجموعات الكبيرة غائبة: فالبيانات الوصفية (metadata) والبحث بالكلمات المفتاحية وTF-IDF وBM25 لا تختفي، وكثيرًا ما تبقى مرشِّحًا أول زهيد الكلفة. ثالثًا، يكون الاسترجاع القائم على الاستدلال (reasoning retrieval) شبه حتمًا أغلى من
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.