كيف تبني خط معالجة Netflix Void لإزالة الكائنات من الفيديو باستخدام CogVideoX
يعرض تحليل جديد كيفية بناء خط معالجة Void لإزالة الكائنات من الفيديو استناداً إلى CogVideoX. ويغطي المقال إعداد البيئة، وتنزيل النموذج الأساسي ونقطة الحفظ (checkpoint)، وتجهيز المدخلات التجريبية (sample inputs)، وتشغيل سلسلة الاستدلال (inference) الكاملة مع موجّهات (prompts) مخصصة. وتكمن فائدة ذلك لفرق المعالجة اللاحقة للفيديو في أن الأمر لا يتعلق بعرض توضيحي، بل بسير عمل قابل لإعادة الإنتاج محلياً.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News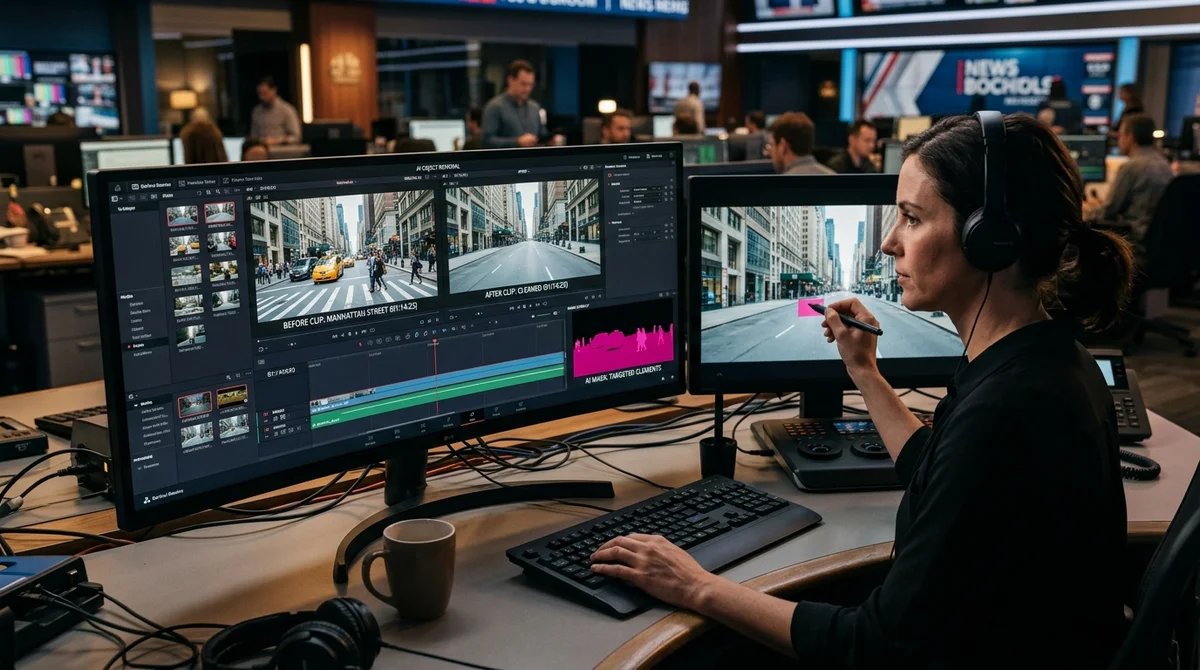
يعرض تحليل جديد بالتفصيل كيفية بناء خط معالجة عملي لإزالة الكائنات من الفيديو استناداً إلى نموذج Void من Netflix: من تثبيت الاعتماديات وتنزيل الأوزان إلى تشغيل سلسلة الاستدلال الكاملة مع موجّهات مخصصة وأمثلة جاهزة. وبالنسبة إلى الفرق العاملة في المعالجة اللاحقة والمونتاج التوليدي وتحرير الفيديو، فإن الأهم هنا ليس عرض جودة النتائج بحد ذاته، بل العملية القابلة لإعادة الإنتاج، التي يمكن تشغيلها محلياً واختبارها على بيانات تجريبية وتكييفها مع بيئة الإنتاج الخاصة بكل فريق.
يتمحور المقال حول نموذج Void المصمم لمهام إزالة الكائنات من الفيديو (video object removal) وإعادة الرسم (inpainting)، أي حذف الكائنات غير المرغوب فيها من الإطار ثم إكمال الخلفية والحركة بحيث تبدو النتيجة طبيعية من إطار إلى آخر. وفي مثل هذه السيناريوهات لا يكفي ترميم إطار واحد منفصل: فإذا اهتزت الخلفية، وتمايلت الملمسات، وتغيّرت الإضاءة بقفزات مفاجئة، لاحظ المشاهد التدخل فوراً. ولهذا السبب يعتمد التحليل على الجمع بين CogVideoX ونقطة حفظ (checkpoint) مستقلة. فنموذج الفيديو الأساسي يتولى الديناميكية العامة للمشهد، بينما يساعد الضبط المتخصص على حل مهمة التعديل الموضعي بدقة أكبر دون إفساد بقية الفيديو.
من الناحية العملية، هذا دليل هندسي متكامل. يقترح المقال أولاً تجهيز البيئة وتثبيت جميع الاعتماديات المطلوبة واستنساخ المستودع. ثم يجب تنزيل النموذج الأساسي الرسمي ونقطة حفظ Void، وبعدها تجهيز المدخلات التجريبية (sample inputs) للتشغيل الاختباري: الفيديو الأصلي، والقناع (mask) أو أي مدخلات أخرى توضح أي كائن ينبغي حذفه. وهذا الترتيب ليس شكلياً، بل له مبرر عملي. ففي الاستدلال على الفيديو، تحدث معظم الأعطال لا في بنية النموذج نفسها، بل عند تقاطع إصدارات المكتبات وبنية المجلدات وصيغ الملفات وقيود ذاكرة الفيديو (VRAM) وأخطاء مسارات الأوزان.
ويُسلَّط الضوء بصورة خاصة على الموجّهات المخصصة وعلى الاستدلال التجريبي الكامل من البداية إلى النهاية (end-to-end sample inference). وهذا أمر حاسم، لأن جودة الفيديو النهائي لا تتوقف على القناع وحده، بل أيضاً على كيفية تفسير النموذج للمشهد بعد التعديل: أي خلفية ينبغي أن تظهر مكان الكائن المحذوف، وكيف ستستمر حركة الكاميرا، وما العناصر التي يجب الإبقاء عليها دون تغيير، ومدى دقة استعادة التفاصيل الصغيرة.
ويؤكد المقال كذلك طريقة أكثر عملية للتعامل مع خط المعالجة، عبر إدخال المعاملات بأسلوب سطر الأوامر (terminal-style) الآمن. وهذا يعني للفريق الهندسي عمليات تشغيل أكثر قابلية للتنبؤ، وروتيناً يدوياً أقل، وأتمتة أسهل في مهام المونتاج المتكررة.
ولا ينمو الاهتمام بهذه الأنظمة من فراغ. فقد أصبح الفيديو الصيغة المحورية للتسويق والتدريب والإعلام والعروض التوضيحية للمنتجات، وارتفع معه الطلب على أدوات تتيح إزالة الكائنات الزائدة والانعكاسات والشعارات والمارة العرضيين أو العيوب التقنية من الإطار بسرعة، دون تنقيح يدوي إطاراً بإطار.
والأهم من ذلك أن النماذج التوليدية تنتقل تدريجياً من مرحلة العروض التوضيحية المبهرة إلى مرحلة أدوات الإنتاج. وفي هذا السياق لا تقتصر الأهمية على جودة المخرجات، بل تشمل أيضاً قابلية تكرار النتيجة، ووضوح التثبيت، وشفافية الإعدادات، وإمكانية دمج الحل في خط معالجة المحتوى القائم. وهذه التعليمات تحديداً تسرّع التبنّي أكثر من الإعلانات الصاخبة.
والخلاصة الرئيسية أن هذا التحليل لا يعرض فكرة بحثية مجردة، بل مخططاً إنتاجياً شبه جاهز لتحرير الفيديو بالذكاء الاصطناعي. فعندما تُوصف معاً خطوات التثبيت والاعتماديات والأوزان ومنطق التشغيل والأمثلة التجريبية، تقترب التقنية بوضوح من الاستخدام الفعلي. وإذا واصلت المنظومة المحيطة بـ Void وCogVideoX تطورها، فسينخفض حاجز الدخول إلى إزالة الكائنات من الفيديو بجودة عالية أمام الاستوديوهات وفرق المنتجات وخدمات المونتاج الآلي. وهذه إشارة واضحة للسوق: فإعادة رسم الفيديو (video inpainting) تتحول بوتيرة متسارعة من ميزة تجريبية إلى أداة عمل.
- 31 أكتوبر 2026Freefield: استوديو مفتوح على ComfyUI يضم 120 تطبيقًا للصور والفيديو والصوت
- 31 أكتوبر 2026تشغيل نموذج فيديو بـ22 مليار معامل على RTX 3080 بذاكرة 10 غيغابايت
- 30 أكتوبر 2026128 وكيل ذكاء اصطناعي بلا قائد اجتازوا اختبارات أكثر بنسبة 49% من وكيل واحد
- 30 أكتوبر 2026Pika تتيح أوزان نموذج الفيديو H3 Flex: 15 ثانية بصوت مدمج في 6 خطوات
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.