Claude Code و11 وكيلًا: كيف أتمتت فرقة ضمان الجودة ما يصل إلى 80% من روتين الاختبار
بدلًا من توظيف مختبِرَين إضافيين، بنت فرقة ضمان الجودة منظومة من 11 وكيلًا على Claude Code. تحلل المنظومة Jira وConfluence، وتبني السيناريوهات وفق معايير ISTQB، وتكتب اختبارات آلية لواجهات API والواجهات الرسومية (UI)، وتفتح طلب دمج (Merge Request) بنفسها. في المرحلة التجريبية التي استمرت شهرًا ونصف الشهر، ارتفع عدد حالات اختبار الانحدار (regression) من 50 إلى 400، وانخفض زمن فحص الميزات الجديدة من أيام إلى ساعات.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News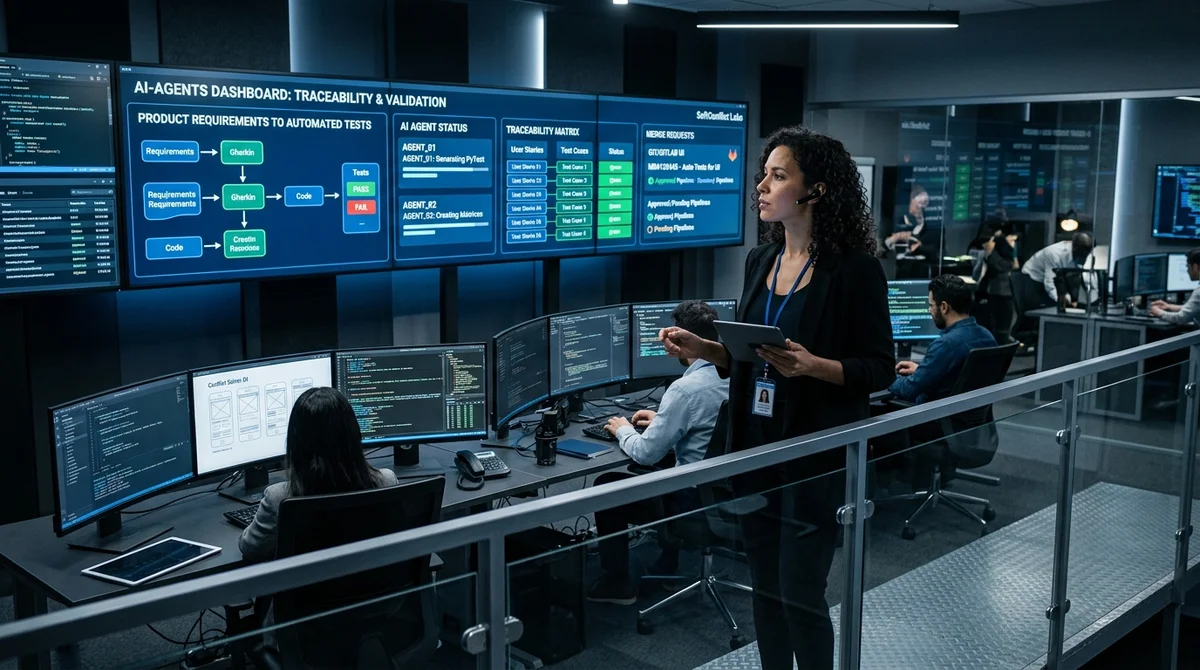
أظهرت فرقة ضمان الجودة (QA) أن وكلاء الذكاء الاصطناعي باتوا قادرين على تولّي الجزء الأكبر من روتين الاختبار: من قراءة المتطلبات وتصميم السيناريوهات إلى رفع حالات الاختبار إلى نظام إدارة الاختبارات (TMS) وفتح طلب دمج (Merge Request) يتضمن اختبارات آلية جاهزة. وبدلًا من توسيع الفريق بمختبِرَين إضافيين، بنت الفرقة على Claude Code «هيكلًا خارجيًا» (exoskeleton) من 11 وكيلًا متخصصًا، وتزعم أنه يغطي ما يصل إلى 80% من العمل التشغيلي لمهندس ضمان الجودة.
انطلقت الفرقة من مشكلة مألوفة في فرق المنتجات: التطوير يُصدر الميزات الجديدة أسرع مما يستطيع الاختبار تحويل المتطلبات إلى سيناريوهات وبيانات وأتمتة. وبحسب التقدير الداخلي، يذهب نحو 20% من وقت مهندس ضمان الجودة إلى تحليل المتطلبات وتصميم الاختبارات، و15% إلى إنشاء الحالات في TMS، و10% إلى إعداد البيانات، و25% إلى الأتمتة، ثم تأتي الفحوص نفسها واختبارات الانحدار والتقارير. والمحصلة أن ما يصل إلى 80% من الحمل يمكن وصفه بقواعد وتقسيمه إلى مراحل قابلة للتكرار.
ومن هنا جاءت الفكرة: لا استبدال المهندس، بل تحويله إلى مشغّل لخط المعالجة (pipeline) يحدد المهمة ويراقب المخرجات ولا يتدخل إلا حيث ينقص المنظومة سياق أو حيث يلزم اتخاذ قرار ملتبس.
تقوم البنية على سلسلة معيارية من 11 مهارة (skills) ومنسّق (orchestrator) مستقل. يسحب أحد الوكلاء المهمة من Jira والمواد المرتبطة بها من Confluence، ويفكك آخر المتطلبات إلى قصص مستخدم (User Stories) ومهام، ويولّد ثالث سيناريوهات الاختبار وفق قواعد ISTQB. أما الوكلاء التالون فيتولون البيانات الناقصة والتناقضات ومحددات DOM والاختبارات الآلية لواجهات API والواجهات الرسومية، ومقارنة السيناريوهات بالشيفرة، ورفع الحالات إلى Zephyr Scale، وإنشاء Merge Request في GitLab. ويُعتمد في ذلك على سيناريوهات بصيغة JSON كمصدر وحيد للحقيقة، مع تتبّع كامل يصل إلى المتطلبات ومعايير القبول، بينما تُبنى بالتوازي مصفوفة التغطية RTM. وفي جزء الواجهة الأمامية تتصل المنظومة بـFigma عبر MCP، فتستخرج بنية الواجهة وحالاتها وقيود عناصرها، لا مجرد لقطات الشاشة.
وأُولي اهتمام خاص للجودة والحماية من نقاط الضعف المعتادة في نماذج LLM. فبعد توليد السيناريوهات، يمرّر المنسّق نقاط تحقق للجودة: يتحقق من مخطط JSON واكتمال الخطوات والأولويات وخلو السيناريوهات من التكرار وتغطية المتطلبات. وبعد توليد الاختبارات الآلية يزداد التحقق صرامة: إذ تُفحص شيفرة Python والتجهيزات (fixtures) وتشغيل الاختبارات نفسه.
ويُعتمد في تصحيح الأخطاء مخطط من مرحلتين. أولًا تشغّل المنظومة كل اختبار على حدة وتفصل مشكلات شيفرة الاختبار عن العيوب الفعلية في المنتج. ثم يبدأ اختبار الطفرات (mutation testing): يُقلب assert في اختبار ناجح أصلًا، فإذا بقي أخضر مع ذلك عُدّ اختبارًا فارغًا ويحتاج إلى تحسين.
وثمة طبقة مهمة أخرى هي بروتوكول التناقضات بين Jira وFigma ونص المتطلبات والسلوك الفعلي للواجهة. تُحسم التعارضات الواضحة تلقائيًا وفق تسلسل أولويات المصادر، أما الحالات الخلافية فتُرفع إلى المهندس.
وعمليًا قدّمت المرحلة التجريبية، التي استمرت شهرًا ونصف الشهر، الأرقام التي تُطلق مثل هذه التجارب من أجلها عادةً. فقد ارتفع عدد حالات اختبار الانحدار من نحو 50 إلى 400، وأصبحت تفاصيل السيناريوهات كاملة، واقتربت تغطية الانحدار بالأتمتة من 100%. وانخفض زمن الانحدار نفسه من نحو يوم واحد إلى عشرات الدقائق، وانخفض الوقت من انتهاء التطوير إلى اعتماد QA من عدة أيام إلى عدة ساعات، وصار ربط الاختبار بمشروع جديد يستغرق نحو أربع ساعات من الإعداد بدلًا من أشهر للتوظيف والتأهيل. كما بدأت المنظومة تكشف تناقضات خفية في المتطلبات وأخطاء أكثر مما كشفته العملية اليدوية.
وتعمل النسخة التجريبية باشتراك Claude Pro بسعر 100 دولار شهريًا، وهي، وفق ما يُذكر، قادرة على خدمة 2–3 مشاريع بحجم يتجاوز 100 اختبار شهريًا لكل مشروع.
والخلاصة الرئيسية من هذه الحالة أن دور مهندس ضمان الجودة بدأ فعلًا ينتقل من التنفيذ اليدوي إلى إدارة السياق والقواعد وجودة القرارات التي يتخذها الذكاء الاصطناعي. لكن هذا لا ينجح إلا بشروط عدة: أن تكون المتطلبات مكتملة بقدر كافٍ، وأن يتوافر للمشروع مصدر سياق جيد مثل عقود API وبيانات الاختبار، وألا يكون خط المعالجة نفسه «صندوقًا أسود». فالقيمة هنا لا تكمن في توليد سحري للاختبارات، بل في سلسلة خطوات شفافة يمكن إعادة تشغيلها وفحصها وتقويتها تدريجيًا.
وإذا نجح هذا النهج خارج نطاق التجارب التجريبية، فقد يحصل سوق الاختبار لا على بديل للمهندسين، بل على صيغة عمل أكثر إنتاجية وقابلية للتوسع بكثير.
Build & Ship Production AI Apps with Vibe Coding
Join Zhemal Khamidun's hands-on Vibe Coding Intensive at hamidun.com/vibecoding — master Claude Code, Cursor, and autonomous agentic workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.