Qwen 3.5 على MacBook Pro: مقارنة بين ثمانية خوادم محلية للعمل الجماعي
قارن الاختبار بين ثمانية خوادم MLX محلية لتشغيل Qwen 3.5 35B على MacBook Pro M2 Max بذاكرة 64 غيغابايت. في حالة الطلب الواحد تتقارب نتائج المتصدرين، لكن عند وصول طلبين متزامنين يتحول معظم الحلول إلى طابور انتظار أو يفقد جزءًا من أدائه. وكشفت الاختبارات تفاصيل غير سارة أيضًا: attention تربيعي، ومقاييس مضخَّمة بسبب محلل SSE، وعملية «زومبي» تستهلك 20 غيغابايت من ذاكرة RAM.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News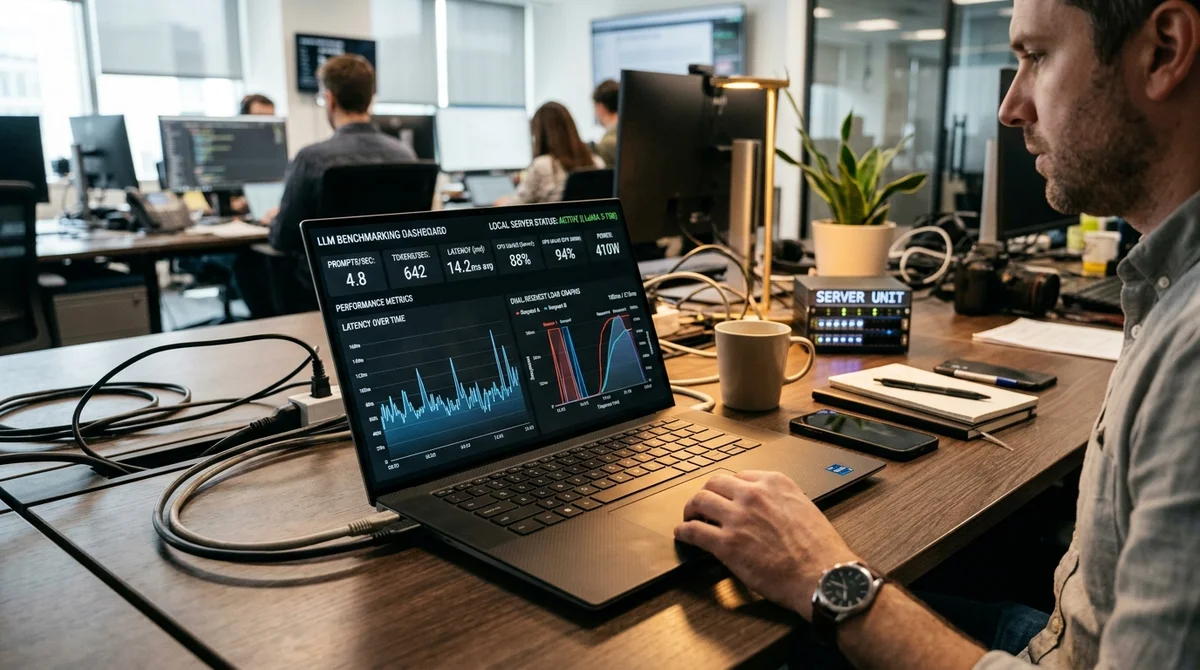
لم يعد تشغيل النماذج الكبيرة محليًا على Mac مجرد لعبة للهواة، لكن تجربة Qwen 3.5 35B تُظهر أن المسافة بين «يعمل» و«يصلح لواجهة API جماعية» ما زالت كبيرة. استخدم المؤلف جهاز MacBook Pro M2 Max بذاكرة 64 غيغابايت، ولم يختبر النموذج نفسه، بل البنية التحتية المحيطة به: أي خادم MLX يتحمل عبء عمل حقيقيًا، ولا يعرض أرقامًا جميلة في السجلات، ولا ينهار بمجرد أن يصل إليه مستخدمان في وقت واحد.
لأجل الاختبار، بُنيت أداة اختبار (harness) مستقلة بلغة Python، وشُغّلت عبرها ثمانية خوادم محلية تُقدَّم بوصفها طريقة سريعة لإنشاء API فوق نماذج MLX على macOS. لم يقتصر الفحص على سؤال واحد مريح، بل شمل ثمانية prompts متنوعة النوع والطول، بينها مسائل بمستوى AIME ومدخلات طويلة تصل إلى 52 ألف token. وجرى تشغيل كل سيناريو خمس مرات لاستبعاد القفزات العشوائية والحصول على صورة أكثر إنصافًا لزمن الاستجابة وسرعة التوليد والسلوك العام تحت الحمل. وكان التركيز على تقييم السلوك في ظروف قريبة من العمل الفعلي، لا السرعة القصوى المخبرية: مع بث الإجابة تدريجيًا (streaming)، وطبقة الشبكة، وشروط قياس قابلة للتكرار.
في وضع المستخدم الواحد لم تكن هناك مفاجآت تُذكر: أظهرت الخوادم الثلاثة المتصدرة نتائج متقاربة، وفي الجلسات القصيرة يبدو الفارق بينها شكليًا أكثر منه جوهريًا. ولهذا السبب تضلّل الوعود التسويقية في ملفات README القارئ بسهولة. فإذا نظرنا إلى الطلب الفردي وحده، يبدو أن أي خادم MLX حديث تقريبًا جيد بما يكفي للاستخدام اليومي. لكن هذا الاستنتاج يسقط فور تحوّل النموذج المحلي من أداة شخصية إلى خدمة لفريق، حيث تتداخل الطلبات زمنيًا.
أكثر مراحل الاختبار دلالة هي الحمل المتوازي المؤلف من طلبين، وهنا ظهرت الفجوة الحقيقية بين الحلول. فقد تحولت أربعة أطر من أصل ستة فعليًا إلى طابور انتظار، وراحت تخدم الطلبات بشكل شبه تسلسلي، مع أنها تبدو من الخارج متعددة المسارات. وحافظ خادم آخر على التوازي شكليًا فقط، وتراجع إلى معامل 0,85x، أي أن الطلب الثاني عرقل الأداء بدل أن يساعد في استغلال العتاد. ولم يحقق تسريعًا حقيقيًا بمعامل 2,17x سوى مشارك واحد في الاختبار، وهو سلوك يمكن اعتباره صالحًا لواجهة API جماعية محلية، حيث لا يكفي الرد بسرعة على مستخدم واحد، بل يجب تحمّل عدة طلبات دون تراجع حاد في الأداء.
وخلال الاختبار ظهرت مشكلات أهم من الأرقام الجافة في الجدول. ففي أحد المواضع اصطدم المؤلف بـ attention تربيعي، لا يزال في عام 2026 قادرًا على تدهور الأداء بشكل حاد مع السياقات الطويلة. وفي موضع آخر واجه 14 000 tokens/sec وهمية، لم تنشأ عن تحسين سحري، بل عن سطر واحد في محلل SSE شوّه القياس. كما يُذكر بشكل منفصل وجود عملية «زومبي» تترك وراءها نحو 20 غيغابايت من الذاكرة العشوائية مشغولة، بينما تفضّل ملفات README الصمت حيال هذا الخطر. وبالنسبة لمن يخطط لتشغيل محلي في بيئة إنتاج، فهذه ليست تفاصيل ثانوية: فمثل هذه الأخطاء تضرب قابلية التنبؤ بالخدمة والمراقبة وتكلفة الصيانة أكثر مما يفعل فارق بضعة بالمئة في السرعة الخام.
تكمن القيمة العملية لهذا العمل في أنه ينقل التركيز من الوعود الجميلة إلى سيناريوهات الاستخدام. فإذا كان النموذج مطلوبًا لمطوّر واحد يرسل طلبات متقطعة، فيمكن الاكتفاء بالنظر إلى سهولة التشغيل والسرعة الأساسية. أما إذا كان الحديث عن API جماعي يتطلب التوازي والسياقات الطويلة والتعافي السريع من الأعطال، فإن اختيار الخادم استنادًا إلى README بات أمرًا محفوفًا بالمخاطر. ويُظهر هذا الاختبار حقيقة بسيطة: يجب تقييم حزمة Qwen 3.5 المحلية بوصفها بنية تحتية، لا نسخة تجريبية للعرض. وإلا فقد ينتهي الأمر بنظام يبدو «سريعًا» في اختبارات الطلب الواحد، لكنه في العمل الفعلي يحوّل جهاز MacBook القوي إلى طابور طلبات مكلف.
- 30 أكتوبر 2026Claude Enterprise يحصل على تقارير ذكية: من يستخدم الذكاء الاصطناعي وكيف وبكم
- 29 أكتوبر 2026Mistral تنشر أوزان Large 4: نموذج مفتوح بتريليون معامل للبرمجة
- 29 أكتوبر 2026مطوّر يبني نظام RAG بالاعتماد على نماذج محلية ويرفع دقة البحث من 20% إلى 53%
- 29 أكتوبر 2026Qwen 3.5 4B تحمل داخل أوزانها معالج RISC-V بذاكرة قائمة على DeltaNet
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.