Scikit-LLM تُظهر كيفية دمج تلخيص النصوص في مسار تعلّم الآلة على scikit-learn
أظهرت Scikit-LLM كيف يمكن دمج التلخيص مباشرة في pipeline المألوف في scikit-learn. في المثال، تُضغط المراجعات الطويلة أولًا عبر نموذج DistilBART المجاني من Hugging Face، ثم تمر عبر TF-IDF وLogisticRegression. ويساعد هذا النهج على تقليص حجم النص وتبسيط إعداد الخصائص، ويُبقي العملية كلها، من المدخلات الخام إلى التصنيف، داخل مسار واحد قابل لإعادة الإنتاج.
معالج بواسطة الذكاء الاصطناعي من Machine Learning Mastery؛ بتحرير Hamidun News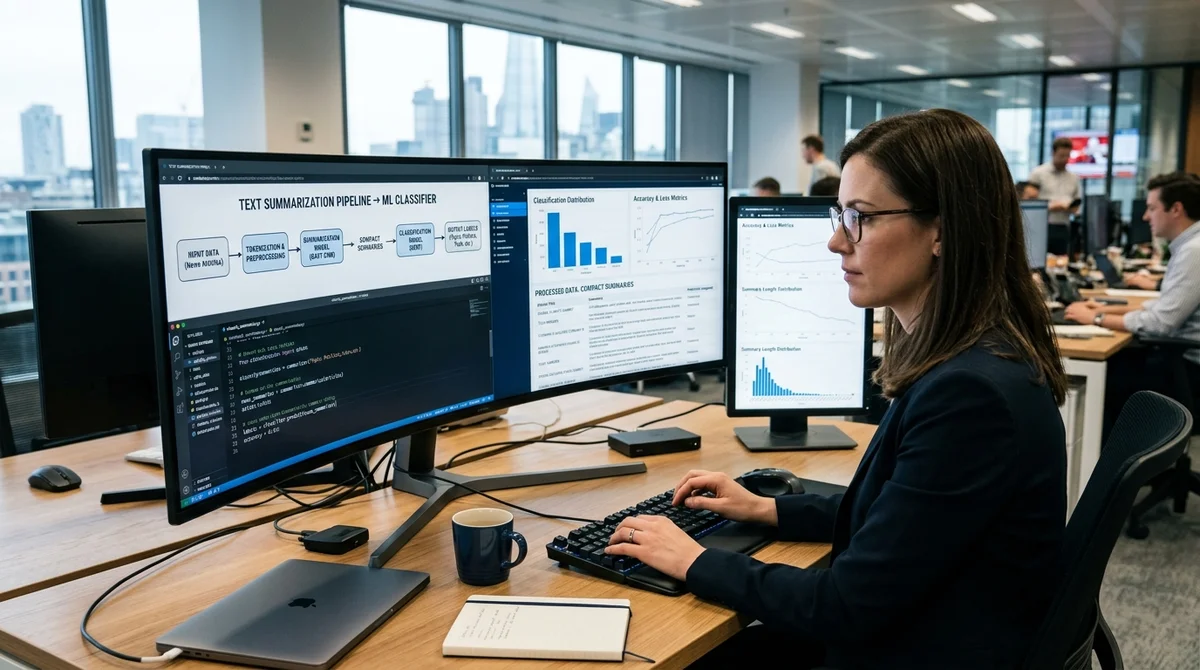
قدّمت Scikit-LLM طريقة عملية لدمج تلخيص النصوص مباشرة في مسار تعلّم الآلة الكلاسيكي على scikit-learn. الفكرة بسيطة: يضغط نموذج LLM المستندات الطويلة أولًا إلى ملخصات قصيرة، ثم تُحوَّل هذه الملخصات إلى خصائص عددية وتُرسل إلى المصنِّف. يتيح هذا النهج التعامل مع النصوص الكبيرة دون مرحلة معالجة مسبقة يدوية منفصلة، ويجعل المسار كله موحّدًا، من النص الخام إلى التنبؤ النهائي.
في هذا الشرح، يستخدم المؤلف Scikit-LLM حلقة وصل بين أدوات تعلّم الآلة التقليدية ونماذج اللغة الحديثة. تعتمد المكتبة افتراضيًا على نماذج OpenAI، لكن المثال يختار بديلًا مجانيًا عبر Hugging Face، هو نموذج sshleifer/distilbart-cnn-12-6. ولهذا الغرض تُثبَّت مكتبة transformers بإصدارها 4.
37.2 بشكل إضافي. وهذا الاختيار مهم، فقد يُستدعى التلخيص مرات كثيرة، وتصبح تكلفة الاستدلال ملحوظة بسرعة إذا شُغِّل على واجهات API تجارية.
العنصر الأساسي في المثال هو فئة HuggingFaceSummarizer المخصصة والمتوافقة مع scikit-learn. ترث هذه الفئة من BaseEstimator وTransformerMixin، ولذلك يمكن إدراجها في Pipeline عادي مثل أي محوّل آخر. في الدالة fit تحمّل الفئة النموذج المدرَّب مسبقًا إلى الذاكرة، وفي transform تستقبل قائمة نصوص، وتشغّل summarization pipeline، وتعيد ملخصات قصيرة جاهزة.
ويؤخذ العتاد في الاعتبار أيضًا: إذا توفّرت GPU يعمل النموذج عليها، وإلا يُستخدم CPU. بعد ذلك يصبح هذا التلخيص الخطوة الأولى في مسار تعلّم الآلة. يلي ذلك TfidfVectorizer الذي يحوّل النصوص المختصرة إلى خصائص عددية، ثم يُدرَّب LogisticRegression على هذه التمثيلات.
يستخدم العرض التوضيحي مثالين فقط: مراجعة إيجابية عن مكنسة كهربائية، ومراجعة سلبية عن حقيبة ظهر تتضمن تأخر التسليم ومشكلة في السحّاب. وبالطبع لا تكفي هذه المجموعة لنموذج حقيقي، لكن المقصود هنا أمر آخر: إثبات أن النص الطويل غير المنظَّم يمكن ضغطه تلقائيًا وتغذية مخطط التصنيف القياسي به مباشرة. ومن المفيد أيضًا أن العملية كلها تعمل باستدعاء fit عادي.
في هذه الخطوة ينزّل المسار النموذج، ويلخّص النصوص الطويلة، ثم يحوّل النسخ المختصرة إلى متجهات، ثم يدرّب المصنِّف. ويعرض المؤلف الملخصات الوسيطة نفسها: ففي المراجعة الإيجابية تبقى الفكرة أن الجهاز جيد عمومًا، رغم أنه ثقيل بعض الشيء وإعداده ليس واضحًا من أول وهلة؛ وفي المراجعة السلبية تبقى الشكاوى من تأخر التسليم والسحّاب العالق والقماش الرديء. أي إن حتى النموذج المدمج قادر على استخلاص الإشارة الأساسية التي يمكن استخدامها لاحقًا في تعلّم الآلة التقليدي.
وكما هو متوقع، يقوم هذا النهج البسيط على حل وسط. يشير المؤلف صراحة إلى أن جودة الملخصات القصيرة أدنى بوضوح مما يمكن الحصول عليه من ChatGPT أو Google Gemini. فنموذج DistilBART الخفيف والمجاني يستخرج الأفكار الرئيسية، لكنه يفعل ذلك بخشونة ودقة أقل.
في المقابل، يوضّح المثال البنية نفسها جيدًا: يتحول التلخيص من أداة خارجية إلى جزء مدمج في عملية التدريب. وهذا مفيد خصوصًا في المهام التي تكثر فيها المستندات وتطول، ويكون فيها النموذج اللاحق (downstream) حسّاسًا لأبعاد النص وضجيجه. تكمن الفائدة العملية لهذا المخطط في أن المطوّر يحصل على pipeline واحد قابل لإعادة الإنتاج لإعداد النصوص وتدريب النموذج.
فبدلًا من عدة سكربتات متفرقة، يوجد مسار واحد يمكن تدريبه واختباره ونقله إلى بيئة الإنتاج وفق قواعد scikit-learn القياسية. وإذا استُبدل النموذج الخفيف بنموذج أقوى، ترتفع جودة التلخيص، وقد ترتفع معها جودة التصنيف. وتعمل Scikit-LLM هنا جسرًا بين حزمة تعلّم الآلة المألوفة ونُهج LLM، ويمكن اعتماده دون إعادة بناء كاملة للبنية التحتية.
وهذا مثير للاهتمام خصوصًا للفرق التي تعمل أصلًا ضمن منظومة scikit-learn وتريد إضافة وظائف LLM في نقاط محددة، دون إعادة كتابة المسارات بالكامل أو بنية التدريب التحتية أو إجراءات التحقق.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.