AMI Labs تراهن على نماذج العالم بعد LLM وترى طريق المنتجات عبر VLA
تروّج AMI Labs، المشروع الذي يقوده يان لوكون، لنماذج العالم بوصفها الخطوة التالية بعد LLM: فبدلًا من التنبؤ بالرموز (التوكنات) تسعى إلى فهم البيئة وعواقب الأفعال. يقوم النهج على JEPA والتمثيلات الكامنة، فيما ترى الشركة مخرجها العملي في ربطه بـVLA. تبرز أهمية هذه الفكرة خصوصًا في الروبوتات والأتمتة الصناعية والطب، حيث تكون كلفة الخطأ أعلى بكثير مما هي عليه في روبوتات الدردشة المعتادة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News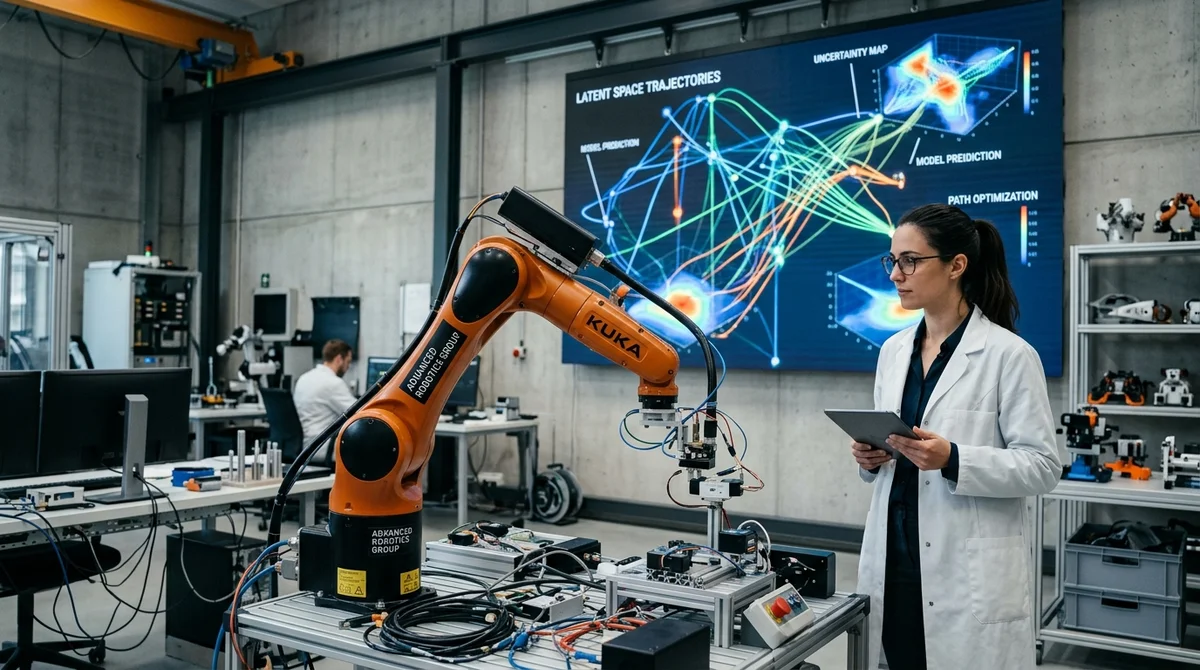
بعد طفرة LLM، تقترح شركة AMI Labs نقل مركز الثقل في الذكاء الاصطناعي من اللغة إلى فهم البيئة المادية: فلا يكفي أن تجيد الآلة مواصلة النص إذا كان عليها أن تتصرف بأمان في العالم الحقيقي، وأن تخطط خطواتها وتقيّم مسبقًا عواقب قراراتها. AMI Labs شركة أبحاث أسّسها يان لوكون، أحد أبرز رواد التعلم العميق. جمع المشروع 1.03 مليار دولار بتقييم قدره 3.5 مليار دولار قبل الاستثمار، وهو ما يدل على أن الاهتمام بـworld models تجاوز حدود النقاش الأكاديمي.
تنطلق الشركة من فكرة بسيطة: البيانات القادمة من الكاميرات والمستشعرات تختلف في طبيعتها عن النص. فهي متصلة ومشوّشة ومتعددة الأبعاد، ولا تنسجم جيدًا مع منطق «تنبّأ بالرمز (التوكن) التالي». لذلك، بدلًا من تكييف LLM مع كل سيناريو، تراهن AMI على طبقة أساسية مختلفة هي نموذج العالم.
لا يُقصد بنموذج العالم هنا مولّد فيديو، ولا مجرد نظام متعدد الوسائط يستقبل الصور والنصوص والأفعال كمدخلات. المقصود نموذج يبني تمثيلًا داخليًا كامنًا للبيئة، ويستخلص الروابط الثابتة، ويستبعد التفاصيل العشوائية. فالمهم ليس كل بكسل في الإطار المستقبلي، بل بنية ما يحدث: أين تقع الأجسام، وكيف تتحرك، وما القيود المفروضة على البيئة، وما الذي سيتغير بعد فعل الوكيل. ينبغي لهذه البنية أن تجيب لا عن سؤال «ماذا أرى؟» فحسب، بل عن سؤال «ماذا سيحدث إن فعلتُ هذا؟».
ولهذا يتصدّر JEPA، أي Joint Embedding Predictive Architecture، مركز هذا النهج. ففي هذا المنطق لا يتنبأ النموذج بالبيانات الخام ولا بتسلسل الرموز (التوكنات)، بل بالحالة في فضاء التمثيلات. وهذا يتيح عدم إهدار الحوسبة على الضجيج والتباينات العشوائية، والتعلم بدلًا من ذلك من السمات المهمة فعلًا في المشهد.
ظهرت حجة عملية تدعم هذا النهج في أبحاث V-JEPA 2: فقد جرى أولًا تدريب النظام مسبقًا على أكثر من مليون ساعة من الفيديو المأخوذ من الإنترنت، ثم أُجري تدريب إضافي لنسخة action-conditioned على أقل من 62 ساعة من فيديوهات الروبوتات غير الموسومة. وبعد ذلك استطاع النموذج، في وضع zero-shot، العمل على أذرع Franka في مختبرات جديدة، فنفّذ الإمساك بالأجسام ونقلها دون جمع بيانات منفصل لكل بيئة بعينها ودون دالة مكافأة.
لكن نموذج العالم وحده ليس وكيلًا جاهزًا. فهو قادر على التنبؤ بتطور الموقف، غير أن جهة أخرى يجب أن تحوّل هذا الفهم إلى فعل محدد. وهنا يظهر VLA، أي مستوى visual-language-action الذي يربط الإدراك بهدف المستخدم والأمر اللغوي والأفعال المسموح بها للنظام. ومن الأطروحات المهمة لدى AMI والأعمال المرتبطة بها أن VLA ونموذج العالم لا يتنافسان. بل على العكس، فمن دون تنبؤ داخلي تظل VLA ردّ فعلية أكثر مما ينبغي: قد تقدّم الفعل الصحيح «للحظة الراهنة»، لكنها أضعف في السيناريوهات الطويلة والهشّة والحسّاسة فيزيائيًا، التي يتعين فيها محاكاة عواقب اللمس أو الحركة أو الاصطدام أو الخطأ ذهنيًا.
ولذلك فإن أبرز الأسواق لهذا النهج ليست واجهات الدردشة، بل القطاعات التي ترتفع فيها كلفة الخطأ: الأتمتة الصناعية والروبوتات والأجهزة القابلة للارتداء والرعاية الصحية. فإذا أخطأ نموذج نصي في تلخيص مقال، يبقى الضرر محدودًا. أما إذا أساء نظام ذكي تفسير حالة معدات، أو قيّم المخاطر الطبية تقييمًا خاطئًا، أو لم يحسب مسار روبوت بدقة، فالعواقب تصبح مادية.
ومن اللافت أن الشريك الأول لـAMI هو Nabla العاملة في الطب الرقمي. وهذا لا يعني أن الشركة حلّت بالفعل مسألة الذكاء الاصطناعي الموثوق للبيئة السريرية، لكنه يشير إلى الاتجاه: تركيز أقل على العروض التوضيحية اللافتة، وأكبر على قابلية التحكم وإمكانية التنبؤ والمحاكاة الداخلية للبيئة قبل تنفيذ الفعل.
الخلاصة الرئيسية أن الحديث عن الذكاء الاصطناعي بعد عصر LLM يتحول تدريجيًا من الوصف اللغوي للعالم إلى نمذجته داخليًا. ويظل نهج AMI حتى الآن برنامجًا بحثيًا لا بديلًا جاهزًا للنماذج اللغوية الكبيرة: فمصطلح «نموذج العالم» بدأ يفقد دقته، ولا يزال نقل النهج إلى بيئات جديدة بحاجة إلى إثبات. لكن إن نجح هذا الخط، فقد لا يأتي الاختراق العملي التالي في الذكاء الاصطناعي من روبوت دردشة آخر، بل من أنظمة تفهم الواقع المادي أولًا ثم تتصرف فيه.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.