نهاية عصر الذكاء الاصطناعي المكلف: Google وNVIDIA تخفضان كلفة الاستدلال بشكل حاد
ظلت المشكلة الرئيسية في تطور الذكاء الاصطناعي حتى الآن هي تشغيل النماذج يوميًا، لا كلفة تدريبها. وفي مؤتمر Google Cloud Next قدمت Google وNVIDIA حلًا مشتركًا قد يغيّر جذريًا اقتصاديات الحوسبة السحابية. وتَعِد مثيلات A5X الجديدة، العاملة على أنظمة الرفوف المتكاملة NVIDIA Vera Rubin NVL72، بخفض كلفة استدلال الذكاء الاصطناعي عشرة أضعاف. وقد تحقق هذا المؤشر بفضل تكامل غير مسبوق في عمقه على مستوى العتاد والبرمجيات. ومن شأن خفض كلفة الحوسبة بهذا الحجم أن يجعل الذكاء الاصطناعي المتقدم متعدد الوسائط في متناول الخدمات الاستهلاكية الواسعة.
معالج بواسطة الذكاء الاصطناعي من AI News؛ بتحرير Hamidun News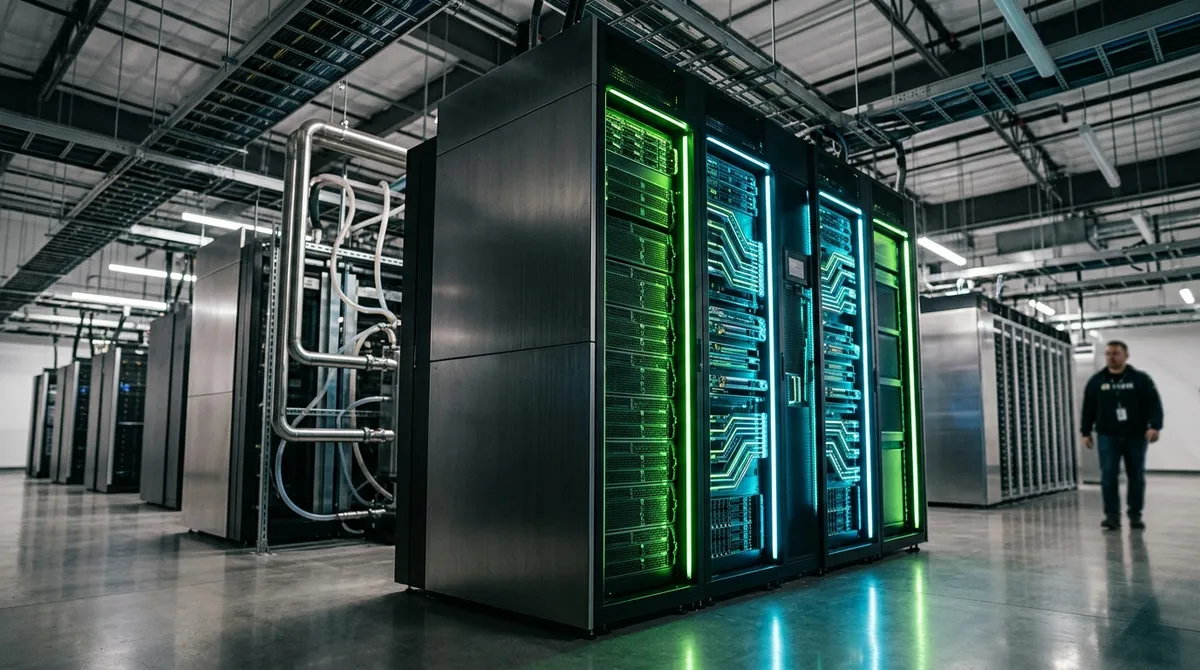
ظلت صناعة الذكاء الاصطناعي طويلًا رهينة طموحها، إذ أخفت مشكلاتها الاقتصادية الجوهرية خلف إصدارات مدوّية. فالأنظار تتجه عادةً إلى الكلفة الهائلة للتدريب الأولي للنماذج اللغوية الجديدة، لكن الثقب الأسود المالي الحقيقي يكمن في تشغيلها اليومي. إذ تتطلب عملية توليد الإجابات عن ملايين طلبات المستخدمين يوميًا، وتُعرف في القطاع باسم الاستدلال (inference)، عملًا متواصلًا لعناقيد حوسبة ضخمة تستهلك طاقة هائلة. وهذا العامل تحديدًا جعل النشر الواسع للذكاء الاصطناعي المتقدم حقًا ومتعدد الوسائط غير مجدٍ اقتصاديًا لدى الغالبية العظمى من الشركات حتى الآن. وخلال مؤتمر Google Cloud Next الذي انعقد مؤخرًا، أعلنت العملاقتان التقنيتان Google وNVIDIA انتهاء هذه المرحلة من شحّ البنية التحتية، وقدمتا بنية مشتركة جديدة تَعِد بخفض كلفة الاستدلال عشرة أضعاف دفعة واحدة.
وقام هذا الاختراق التقني اللافت على مثيلات الحوسبة الجديدة A5X التي تُقدَّم على «العتاد المجرد» (bare metal). ويلغي الاستغناء عن المحاكاة الافتراضية التقليدية أي خسارة في الأداء ناجمة عن الطبقات البرمجية الوسيطة، فتصل كامل القدرة الحاسوبية مباشرة إلى الخوارزميات. وتعتمد هذه المثيلات على بنية NVIDIA Vera Rubin الضخمة، وهي نقلة جيلية طال انتظارها تخلف بنية Blackwell. وكان العنصر الأساسي في البنية التحتية الجديدة أنظمة الرفوف NVL72. ففي النهج المعياري التقليدي تُجمَّع وحدات معالجة الرسوميات المنفصلة في خوادم قياسية، مع اختناقات لا مفر منها في نقل البيانات. أما NVL72 فهو نظام حوسبة متكامل بحجم خزانة كاملة. وداخل هذا الرف تعمل اثنتان وسبعون وحدة معالجة رسوميات من الجيل الجديد كحاسوب خارق واحد عملاق، تربط بينها وصلات بصرية فائقة السرعة.
ويعالج هذا النهج الجذري في تصميم عتاد الخوادم المشكلة الرئيسية للاستدلال الحديث، وهي عرض نطاق الذاكرة. فباتت النماذج اللغوية الأضخم، التي تضم مئات المليارات من المعاملات، قادرة على التحميل كاملةً في الذاكرة المشتركة للنظام. وهذا يعفي العنقود من النقل المستمر البطيء والمستهلك للطاقة لكتل البيانات بين العقد المنفصلة. ولا يتحقق الخفض المعلن لكلفة توليد الرموز (tokens) بمقدار عشرة أضعاف بفضل القوة الخام لرقائق Rubin وحدها، بل أيضًا بفضل مستوى غير مسبوق من التصميم المشترك العميق بين العتاد والبرمجيات. ومن اللافت أن Google، التي تملك معالجات TPU الخاصة فائقة القدرة، مضت في تكامل بهذا العمق مع NVIDIA، معترفةً بالحاجة إلى نهج هجين لتلبية الطلب الهائل من المطورين.
وأعاد مهندسو الشركتين كتابة حزمة إدارة الحوسبة الأساسية حرفيًا، وحسّنوها لاحتياجات التوليد واسع النطاق للمحتوى. وباتت خوارزميات توزيع الحمل الجديدة على مستوى البرمجيات تراعي البنية الفيزيائية لرف Vera Rubin، فتقلل تأخر الإشارة إلى مستوى الميكروثانية. وبالتوازي مع ذلك، أتاح استخدام تبريد سائل متقدم ووحدات تحكم ذكية جديدة في الطاقة خفضًا جذريًا لاستهلاك الكهرباء عن كل ميغابايت من البيانات المولَّدة. وبالنسبة لمراكز البيانات الحديثة، حيث تتجاوز فاتورة الكهرباء كثيرًا كلفة الخوادم نفسها، يُعد هذا عاملًا حاسمًا للربحية.
يصعب المبالغة في تقدير تبعات هذا الإعلان على سوق التقنية، لأنه يكسر حاجزًا جوهريًا في اقتصاديات الوحدة للخدمات المبنية على الذكاء الاصطناعي. فحتى اليوم، اضطر المطورون المستقلون والشركات الكبرى إلى تقديم تنازلات مستمرة: تقييد وظائف منتجاتهم اصطناعيًا باستخدام نماذج أقل قدرة لكنها أرخص، أو فرض حدود صارمة على عدد الطلبات تفاديًا للإفلاس بسبب فواتير السحابة. ويعني خفض التكاليف عشرة أضعاف أن نماذج أعمال بدت بالأمس خيالًا محضًا بسبب الكلفة الباهظة للحوسبة، باتت اليوم مجدية تمامًا.
وفي المستقبل القريب، سيقود انخفاض كلفة الاستدلال إلى ثورة هادئة لكنها عظيمة في تجربة المستخدم. فتحليل الفيديو المعقد في الزمن الحقيقي، والتوليد المخصص لعوالم ثلاثية الأبعاد في ألعاب الفيديو أثناء اللعب، ووكلاء الذكاء الاصطناعي الذكيون الذين يعملون في الخلفية على مدار الساعة ويحللون كامل تدفق المعلومات الواردة، كل ذلك قد يصبح معيارًا شائعًا لا خدمة مميزة باهظة الثمن. وبالنسبة لسوق مزودي الخدمات السحابية، يضع تحالف Google وNVIDIA سقفًا مخيفًا في ارتفاعه للكفاءة.
فالنهج التقليدية في بناء مراكز البيانات تتقادم بسرعة، وتفسح المجال لحلول مفرطة التحسين على مستوى الرفوف الكاملة. وتمثل هذه الشراكة تحولًا بالغ الأهمية في النموذج السائد: فالقطاع ينتقل نهائيًا من سباق إنشاء أذكى ذكاء اصطناعي إلى سباق عملي لإيصاله إلى كل مستخدم على الكوكب بأقل كلفة وأعلى سرعة وكفاءة.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.