كيف يقيّم مدير المنتج جودة منتج الذكاء الاصطناعي: دليل إلى evals
أصبحت evals، أي تقييم جودة منتج الذكاء الاصطناعي، فجأة المهارة الأهم لمديري المنتجات. ويقول مسؤولون تنفيذيون في Anthropic وOpenAI صراحةً إن أحدًا لم يكن يعرف هذا المصطلح قبل عامين، أما اليوم فهو كفاءة إلزامية. وفي بودكاست ليني راتشيتسكي، شرح الباحثان هاميل حسين وشريا شانكار العملية خطوة بخطوة: من تحديد معايير النجاح وبناء «المجموعة الذهبية» من الأمثلة، وصولًا إلى بناء خط أنابيب (pipeline) آلي للتقييم.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News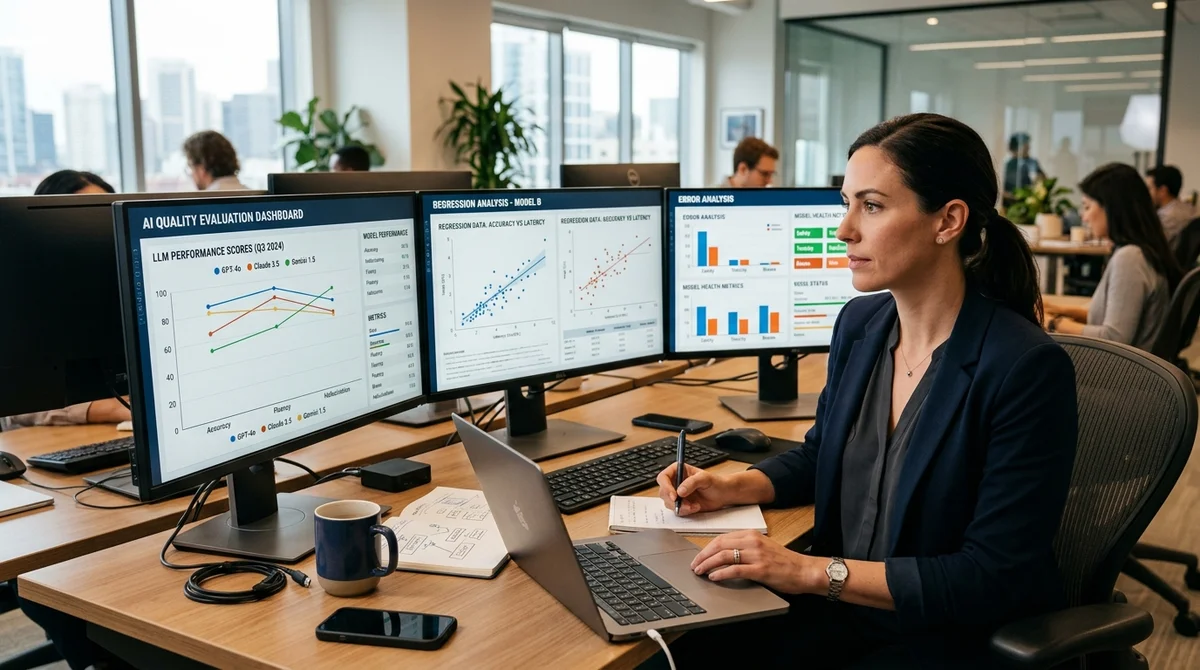
أصبحت evals، أي تقييم جودة منتجات LLM، فجأة المهارة الأكثر تداولًا بين مديري المنتجات في شركات الذكاء الاصطناعي. ويصف مسؤولون تنفيذيون في Anthropic وOpenAI علنًا القدرة على بناء أنظمة التقييم بأنها الكفاءة الأساسية لأي مدير منتج يعمل مع النماذج اللغوية. وفي بودكاست ليني راتشيتسكي، شرح الباحثان هاميل حسين وشريا شانكار كيف ينبغي لمدير المنتج (PM) أن يقارب تقييم منتج الذكاء الاصطناعي، ولماذا لا تجدي الحدس نفعًا في هذا المجال.
ما هو eval ولماذا نحتاج إليه
الـ eval هو فحص منهجي لمدى جودة أداء النموذج اللغوي في مهمة محددة وضمن سياق منتجك تحديدًا. وعلى عكس اختبار البرمجيات الكلاسيكي، حيث تكون الإجابة إما صحيحة أو خاطئة، تقع الإجابة في منتجات LLM في الغالب في منطقة وسطى. فالطلب الواحد قد يُنتج عشرات الإجابات المختلفة التي تتساوى في مقبوليتها، ومهمة مدير المنتج أن يحدد أيها الأفضل لمستخدم بعينه في موقف بعينه.
تقيّم معظم الفرق النماذج في البداية تقييمًا ذاتيًا: تطّلع على بضعة أمثلة ثم تستخلص نتيجة. ينجح ذلك مع الوظائف البسيطة، لكنه ينهار تمامًا عند التوسع. فحين يتلقى المنتج مليون طلب يوميًا، يصبح الفحص اليدوي مستحيلًا، ويلزم نظام يعمل تلقائيًا وبصورة قابلة للتكرار.
ثلاثة مستويات لتقييم منتج الذكاء الاصطناعي
يقترح الخبراء بناء eval على ثلاث طبقات متعاقبة.
الأول هو تحديد معايير النجاح. قبل قياس أي شيء، على مدير المنتج أن يجيب عن السؤال: ماذا تعني «الإجابة الجيدة» في منتجنا؟ قد تكون دقة الوقائع، أو الاتساق مع نبرة العلامة التجارية، أو الطول، أو البنية، أو خلو الإجابة من السمية، أو السلامة. ومن دون هذه الخطوة تفقد أي مقاييس معناها، إذ ستقيس ما لا يهم المستخدم.
المستوى الثاني هو بناء «المجموعة الذهبية». وهي مجموعة من أمثلة الطلبات مع إجابات مثالية، تُنشأ يدويًا أو تُنتقى من بيانات حقيقية. وفي مقابل هذه المجموعة يُختبر النموذج عند كل تحديث. وتحدد جودة المجموعة الذهبية جودة نظام التقييم بأكمله، وهنا تكمن الصعوبة الرئيسية والمسؤولية الرئيسية لمدير المنتج.
المستوى الثالث هو أتمتة التقييم. في هذه المرحلة يبني الفريق خط أنابيب (pipeline): تُمرَّر النسخة الجديدة من النموذج أو من الـ prompt عبر المجموعة الذهبية، وتُقارن النتائج بالمرجعيات، إما تلقائيًا وإما بمساعدة نموذج حَكَم (judge model)، أي LLM آخر يقيّم الإجابات. وبذلك يظهر التراجع (regression) فورًا في الأرقام، بدلًا من اكتشافه في آراء المستخدمين بعد أسبوع من الإطلاق.
لماذا لا يستطيع مدير المنتج تفويض هذا الأمر للمهندسين
الإغراء كبير في إسناد evals إلى الفريق التقني، لكنه خطأ. فـ evals قرارات منتج: ما المهم للمستخدم، وما الذي يعدّه إجابة جيدة، وما التنازلات التي نقبل بها مقابل السرعة أو التكلفة. المهندس لا يعرف لماذا يفضّل المستخدم الإجابة المختصرة على المطوّلة، ولا لماذا تكون نبرة «ودية لكن مهنية» أهم من إجابة أدق بثلاثة بالمئة.
ومدير المنتج هو من يربط بين مقاييس evals والنتائج التجارية الفعلية. فإذا صار النموذج أدق بخمسة بالمئة ولم يتغير رضا المستخدمين، فثمة خلل في معيار التقييم نفسه. واكتشاف هذا التباين وإصلاحه مهمة منتج، لا مهمة هندسية.
ماذا يعني ذلك للسوق والمسار المهني
قبل عامين، كانت كلمة «evals» ترد غالبًا في الأوراق الأكاديمية. أما اليوم فهي جزء قياسي من خارطة الطريق (roadmap) لأي منتج ذكاء اصطناعي جاد. والشركات التي تعلّمت قياس جودة حلول LLM لديها بصورة منهجية تحصل على ميزة تنافسية مستدامة: فهي تكتشف التراجعات أسرع، وتقارن النماذج بعضها ببعض بدقة أكبر، وتتخذ قرارات التحديث استنادًا إلى البيانات لا إلى انطباعات الفريق الذاتية.
أما بالنسبة إلى المسار المهني لمدير المنتج، فالخلاصة مباشرة: إذا كنت تعمل مع منتجات الذكاء الاصطناعي ولا تجيد بناء evals، فأنت متأخر عن زملائك الذين يجيدونه. لقد صارت هذه المهارة إلزامية مثل القدرة على العمل مع قمع المبيعات أو إجراء اختبارات A/B.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.