شبكة عصبية لفحص النصوص: كاشف هلوسات مبني على 6 نماذج
جمع الفريق كاشف هلوسات لا يحتاج إلى تدريب (training-free) من 6 نماذج لغوية جاهزة. وقد صنّف جميع المحكّمين بالإجماع عددًا من الأمثلة على أنها صحيحة، بينما كان التوسيم المرجعي يصفها بأنها «هلوسة». وعندما راجع الباحثون التصنيفات المتنازع عليها يدويًا، تبيّن أن معظمها خاطئ. أي أن المحكّمين من نماذج LLM كانوا على صواب طوال الوقت، بينما أخطأ معيار التقييم نفسه.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News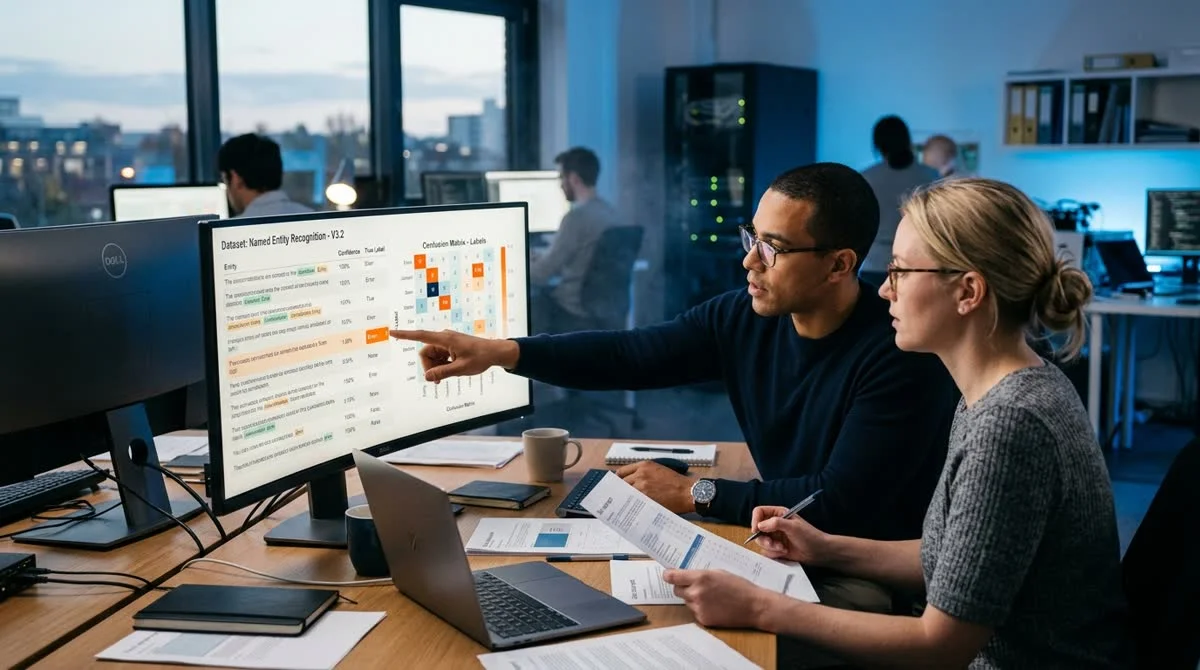
أنشأ باحثون شبكة عصبية لفحص النصوص، وهي كاشف هلوسات يعتمد على ست نماذج لغوية جاهزة تفحص كل إجابة بشكل مستقل.
كيف يعمل كاشف LLM الجماعي
بدلًا من تدريب نموذج متخصص، جمع الباحثون ست نماذج لغوية جاهزة تؤدي دور «محكّمين» مستقلين. يقيّم كل نموذج بمفرده ما إذا كانت الإجابة تتضمن هلوسة، ثم يصدر الحكم النهائي وفق مبدأ الإجماع: إذا اتفقت غالبية المحكّمين، يُعدّ الناتج موثوقًا.
يخفض نهج training-free عتبة الدخول بصورة جوهرية: فلا حاجة إلى جمع مجموعة بيانات متخصصة بالهلوسات، ولا إلى إعادة تدريب النموذج لنطاق محدد. وهذا يجعل الكاشف سهل النقل بين المهام. وجاءت المقاييس على معايير التقييم القياسية مرتفعة، وهو ما لفت انتباه المؤلفين إلى مجموعة من الأمثلة الشاذة.
- ست نماذج LLM محكّمة مستقلة دون إعادة تدريب (zero-shot)
- الحكم وفق مبدأ إجماع أغلبية الأصوات
- لا حاجة إلى بيانات موسومة متخصصة
- سهولة النقل بين المجالات والمهام
- دقة عالية على معايير التقييم القياسية
لماذا اختلف المحكّمون مع التوسيم المرجعي
للوهلة الأولى، بدا الوضع كأنه نقطة عمياء منهجية في نهج LLM-as-judge: فقد «أخفق» الكاشف باستمرار في رصد الهلوسات حيث سجّلها المرجع. ولو تأكد ذلك، لكان الأمر ثغرة خطيرة في النهج الجماعي، أي أن النماذج الست كلها تشترك في نقطة عمياء واحدة.
«هذه الورقة ليست عن الكاشف بقدر ما هي ليست عن النقطة العمياء المفترضة،
بل عن إجراء التحقق الذي أوقعنا نحن أنفسنا في النهاية»، يكتب المؤلفون.
أطلق الباحثون إجراء تحقق خاصًا بهم: قارنوا التصنيفات المتنازع عليها يدويًا بالمصادر الأصلية. وجاءت النتيجة معاكسة تمامًا. فقد احتوت معظم الأمثلة «الإشكالية» على أخطاء في التوسيم المرجعي؛ إذ كانت الإجابات فيها صحيحة فعلًا، بينما وصفها الموسِّمون أو التوسيم الآلي خطأً بأنها هلوسة. وكان محكّمو LLM على صواب طوال الوقت.
ماذا يقول ذلك عن موثوقية معايير التقييم
مشكلة الضجيج في البيانات الموسومة (label noise) معروفة جيدًا في تعلّم الآلة، لكنها تكتسب أهمية خاصة عند تقييم النماذج اللغوية. فمجموعات البيانات المرجعية للهلوسات يُنشئها بشر أو تُنشأ بصورة شبه آلية؛ والأخطاء فيها حتمية، وهي بالذات ما يشوّه المقاييس النهائية.
وكشفت الدراسة نمطًا متناقضًا: كلما ارتفع الاتساق الداخلي للكاشف، أبرز بوضوح أكبر الأخطاء في المعيار نفسه. وتبيّن أن الإجماع بين ستة محكّمين مستقلين إشارة أكثر موثوقية من توسيم منفرد جرى اعتماده كحقيقة مطلقة. وهذا يضع إجراء التقييم القياسي لأنظمة LLM موضع تساؤل.
والخلاصة للمهنيين مباشرة: قبل الإعلان عن «نقطة عمياء» مكتشفة أو خطأ منهجي في نموذج ما، ينبغي التحقق من جودة المرجع نفسه. فالتحقق من التوسيم ليس خطوة اختيارية، بل جزء إلزامي من الإجراء البحثي.
ماذا يعني ذلك
تذكّر الدراسة بأن الثقة في «المعيار الذهبي» للتوسيم ليست مطلقة، حتى لو كانت مجموعة البيانات مستخدمة على نطاق واسع في الصناعة. وبالنسبة إلى الفرق التي تبني أنظمة تقييم LLM، فهذه إشارة إلى ضرورة اعتماد إجراء للتحقق من المرجع، خاصةً حيث يختلف عدة محكّمين مستقلين معه بصورة ثابتة. أحيانًا يكون المحكّمون هم المصيبين، لا التوسيم.
كيف يعمل كاشف الهلوسات؟
جمع الباحثون ست نماذج لغوية جاهزة تؤدي دور محكّمين مستقلين؛ يفحص كل منها الإجابة ويصوّت على ما إذا كانت صحيحة.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.