LangSmith يتيح مقارنة نماذج LLM مفتوحة المصدر المُدرَّبة بالضبط الدقيق مع تقييم تلقائي
عرضت LangChain كيفية اختبار النماذج مفتوحة المصدر المضبوطة بدقة (fine-tuned) في LangSmith، دون سكربتات يدوية ودون تخمين. تُشغَّل عدة نماذج LLM مضبوطة بدقة بالتوازي على مجموعة البيانات نفسها، ويمنح LLM-judge التقييمات تلقائيًا، ويُظهر الجدول النهائي النموذج الفائز. تفيد هذه الآلية بصورة خاصة الفرق التي تضبط Llama أو Mistral أو نماذج أخرى لمهامها الخاصة، وتريد اختيار أفضل نقطة حفظ (checkpoint) بصورة موضوعية قبل النشر.
معالج بواسطة الذكاء الاصطناعي من LangChain Blog؛ بتحرير Hamidun News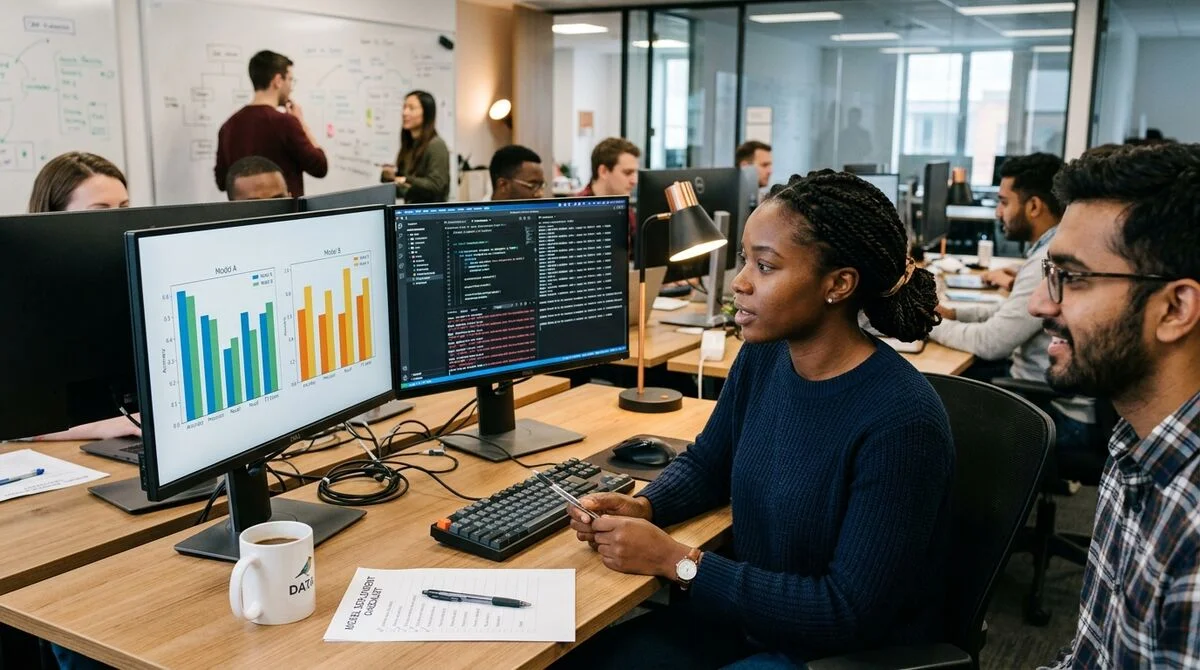
نشرت LangChain دليلًا لاختبار النماذج اللغوية مفتوحة المصدر المضبوطة بدقة ومقارنتها في LangSmith، وهي منصة لتقييم تطبيقات LLM ومراقبتها وتصحيح أخطائها. يشرح الدليل كيفية تشغيل عدة نماذج مضبوطة بدقة (fine-tuned) بالتوازي، وأتمتة تقييم النتائج، واختيار أفضل نسخة للنشر استنادًا إلى البيانات.
لماذا نختبر النماذج المضبوطة بدقة
الضبط الدقيق (fine-tuning) هو إعادة ضبط النموذج الأساسي على بيانات متخصصة. وفي عام 2025 تضبط الفرق بنشاط نماذج Llama وMistral وFalcon وPhi وغيرها من النماذج مفتوحة المصدر لمهام محددة: البحث المؤسسي، وتوليد الشيفرة البرمجية، وتصنيف طلبات العملاء، والإجابة في مجالات موضوعية ضيقة.
المشكلة أن نتيجة الضبط الدقيق ليست مضمونة. فقد يُفرِط النموذج في التكيّف مع أمثلة التدريب ويفقد كفاءته العامة. وقد لا يتفوق على النموذج الأصلي المزوَّد بموجّه نظام (system prompt) جيد. كما أن تشغيلين على البيانات نفسها بمعاملات فائقة (hyperparameters) مختلفة قد يعطيان جودة مختلفة جذريًا، ولا يمكن معرفة ذلك دون اختبار.
يُضاف إلى ذلك أن تدريب النموذج يستغرق ساعات ويكلّف عشرات أو مئات الدولارات. وبلا نظام تقييم، إما أن تخمّن الفرق النموذج الفائز، وإما أن تنفق الموارد نفسها على فحص الإجابات يدويًا. ويقدّم LangSmith طريقًا ثالثًا.
ما الذي يقدّمه LangSmith
تنظّم المنصة الاختبار في خط معالجة (pipeline) واحد:
- مجموعات البيانات — حمّل مجموعة من أمثلة الاختبار تتضمن الاستعلامات والإجابات المرجعية
- التشغيل المتوازي — تُشغَّل عدة نماذج على مجموعة البيانات نفسها في وقت واحد
- التقييم التلقائي — عبر LLM-judge أو دالة مقياس مخصصة: الدقة، وF1، ومطابقة الصيغة، ومؤشرات غير قياسية
- تقرير المقارنة — جدول موحّد بالنتائج وفق جميع المقاييس
- التتبّع (Tracing) — تظهر لكل استدعاء البيانات المُدخلة ومخرجات النموذج والتقييم الذي حصل عليه
إلى جانب المقارنة المباشرة «النموذج A مقابل النموذج B»، يتيح LangSmith مقارنة نقاط حفظ مختلفة من التدريب نفسه، ونسخًا مختلفة من مجموعة بيانات التدريب، واستراتيجيات ضبط دقيق مختلفة ضمن التجربة الواحدة.
مثال: ثلاث نقاط حفظ على مجموعة بيانات واحدة
السيناريو المعتاد: تضبط الفرقة نموذج Llama 3.1 8B على أسئلة شائعة مؤسسية (FAQ) بثلاث نسخ تختلف في عدد الحقب (epochs) ومعدل التعلّم (learning rate). تُنشأ في LangSmith مجموعة بيانات من 200 سؤال حقيقي للمستخدمين. تُشغَّل النسخ الثلاث بالتوازي، ويقيّم LLM-judge كل إجابة على مقياس من 1 إلى 5. ويُظهر الجدول النهائي فورًا أي نقطة حفظ تعطي أفضل جودة بسرعة استجابة مقبولة.
أما دون LangSmith فتتطلب هذه العملية سكربتات مخصصة لكل تشغيل وجمعًا يدويًا للنتائج. ويضيف التتبّع المدمج ميزة أخرى: يمكن لكل إجابة «سيئة» فتح تتبّعها ومعرفة ما الذي حدث بالضبط — هل لم يفهم النموذج السؤال، أم أجاب بصيغة خاطئة، أم أخطأ المقيِّم في منح الدرجة. ويكتسب هذا النهج أهمية خاصة عند تحسين مجموعة بيانات التدريب بصورة تكرارية، إذ إن متابعة تطور الجودة بعد كل تغيير في البيانات هي أساس التحسينات السريعة والمدروسة.
ماذا يعني ذلك
يتحول الضبط الدقيق للنماذج مفتوحة المصدر من ممارسة ضيقة لباحثي ML إلى أداة معيارية لدى فرق المنتجات. ويسدّ LangSmith فجوة أساسية: أصبحت هناك الآن مرحلة تقييم منظّمة بمقاييس رقمية بين التدريب والنشر. وهذا يقلّل خطر إطلاق نسخة أسوأ من الأصلية في بيئة الإنتاج، ويجعل عملية اتخاذ القرار شفافة — فبدل «يبدو أنها أفضل» تصبح «هذه هي الأرقام».
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.