NVIDIA TensorRT يوسّع استدلال الذكاء الاصطناعي التوليدي ليعمل على عدة وحدات GPU
حدّثت NVIDIA محرّك TensorRT ليدعم الاستدلال على عدة وحدات GPU في آن واحد. وتبقى التحسينات الأساسية، ومنها دمج النوى وإدارة الذاكرة والتكميم، فعّالة عند توزيع الحمل. يأتي هذا التحديث ردًّا مباشرًا على نموّ النماذج التوليدية التي لم تعد تتسع منذ فترة طويلة في ذاكرة مسرّع واحد.
معالج بواسطة الذكاء الاصطناعي من NVIDIA Developer Blog؛ بتحرير Hamidun News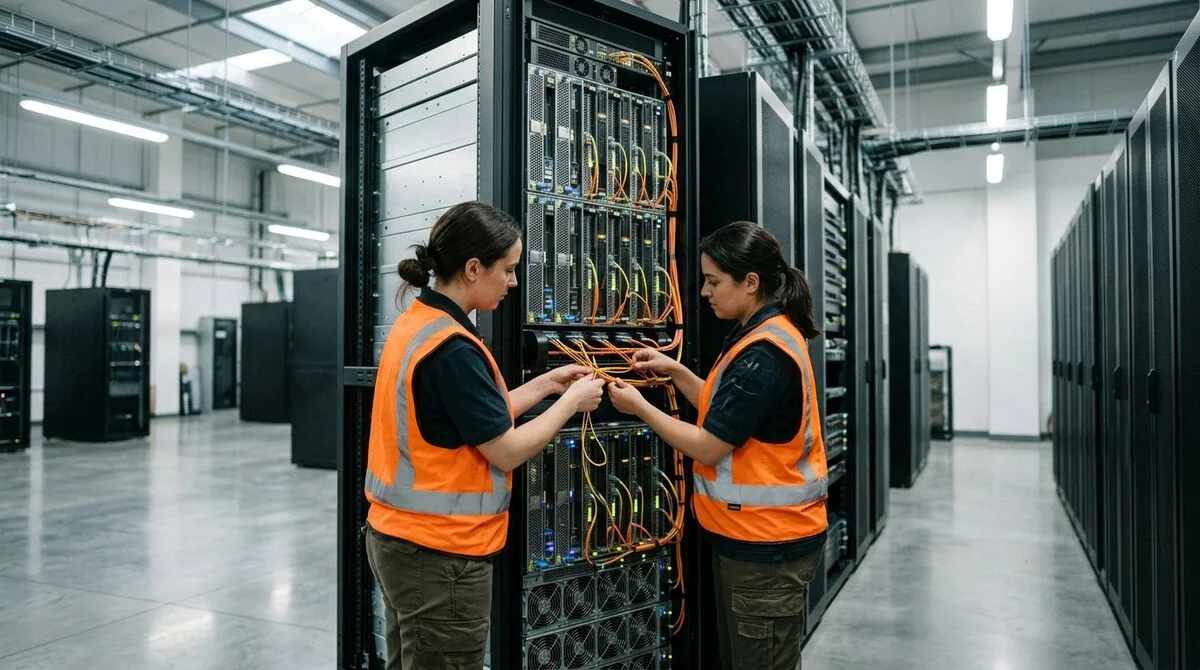
حدّثت NVIDIA محرّك TensorRT وأضافت إليه دعمًا أصليًا للاستدلال على عدة وحدات GPU في آن واحد، بحيث يمكن الآن تشغيل النماذج التوليدية الكبيرة في بيئات الإنتاج دون تقسيم يدوي (sharding) ودون فقدان التحسينات الأساسية للمحرّك.
لماذا لم تعد وحدة GPU واحدة كافية
تنمو النماذج التوليدية الحديثة بوتيرة أسرع من نموّ حجم ذاكرة الفيديو. فالشبكات الانتشارية (Diffusion) لتوليد الفيديو، ونماذج LLM متعددة الوسائط ذات السياق الممتد، وخطوط المعالجة المعقّدة للمحتوى الإعلامي، تجاوزت منذ فترة طويلة حاجز 80 غيغابايت، وهو الحدّ الأقصى لمسرّع H100 الرائد. ووجد مطوّرو أنظمة الاستدلال أنفسهم أمام خيار صعب: إمّا تقسيم الرسم البياني الحسابي يدويًا وخسارة تحسينات TensorRT، وإمّا الانتقال إلى أطر عمل خارجية بإنتاجية أقل.
يُعدّ TensorRT المعيار الفعلي لنشر النماذج في بيئات الإنتاج على عتاد NVIDIA. يحسّن المحرّك الرسوم البيانية الحسابية على مستوى النوى: فيدمج العمليات، ويخطّط لاستخدام الذاكرة، ويطبّق التكميم، وبذلك يوفّر أقل زمن تأخير وأعلى إنتاجية بين الخيارات المتاحة. لكن المشكلة أن هذه التحسينات كانت تعمل سابقًا ضمن وحدة GPU واحدة فقط.
ما الذي يقدّمه الاستدلال متعدد الأجهزة (multi-device inference)
تتيح الميزة الجديدة لـ TensorRT توزيع النموذج تلقائيًا على عدة وحدات GPU مع الحفاظ على كامل ترسانة التحسينات:
- Kernel fusion — دمج العمليات لتقليل النفقات الإضافية عند نقل البيانات بين الأجهزة
- Memory planning — إدارة ذكية لذاكرة VRAM بين وحدات GPU دون نسخ زائد للمصفوفات (tensors)
- تكميم INT8/FP8 — يُطبَّق على الرسم البياني الحسابي بأكمله، لا على أجزاء منه فقط
- Tensor parallelism — تقسيم أوزان النموذج تلقائيًا بين الأجهزة دون تعديل الشيفرة يدويًا
- Pipeline parallelism — تعمل طبقات الشبكة المختلفة بالتوازي على بطاقات مختلفة، ما يرفع الإنتاجية الإجمالية
وكان تحقيق نتيجة مماثلة يتطلب سابقًا ربطًا معقّدًا بين TensorRT وأدوات خارجية، مثل TensorRT-LLM أو Triton Inference Server، إضافة إلى عدة أسابيع من الضبط الهندسي. أمّا الآن فقد أصبح دعم الأجهزة المتعددة مدمجًا في المحرّك نفسه.
من يحتاج إلى هذا اليوم
أكثر المستفيدين من هذه الميزة هي الفرق التي تبني خطوط استدلال لتوليد المحتوى الإعلامي: أنظمة text-to-video، والتكيّف الفوري للمحتوى، والأفاتارات التفاعلية، والمساعدات متعددة الوسائط. فكل هذه المهام تتطلب نموذجًا كبيرًا (أي ذاكرة كبيرة) وأدنى زمن تأخير ممكن (أي دون تنازلات في التحسين) في آن واحد.
كما تغيّر الميزة الجديدة اقتصاديات الاستدلال في السحابة. فبدلًا من التعامل يدويًا مع تقسيم الأوزان على عنقود من وحدات GPU وصيانة منطق مزامنة مكتوب داخليًا، تستطيع الفرق استخدام واجهة TensorRT API القياسية، والحصول على الأداء نفسه بتكاليف تطوير وصيانة أقل.
ويستحق الشريحة المتوسطة إشارة خاصة: الشركات التي تملك وحدتي GPU إلى أربع، لكن ليس لديها فريق مستقل للبنية التحتية لـ ML. وبالنسبة إلى هذه الشركات تحديدًا، يمثّل إزالة عائق الدخول إلى الاستدلال متعدد الأجهزة التحوّل العملي الأبرز.
ماذا يعني ذلك
ينتقل توسيع استدلال الذكاء الاصطناعي على عدة أجهزة من خانة «مهمة للمتخصصين الضيّقين» إلى خانة «ميزة مدمجة في المحرّك». وحين يتولى TensorRT إدارة التوزيع بنفسه، تتقلّص المسافة بين النموذج المدرَّب والخدمة الإنتاجية القابلة للتوسع بشكل كبير، وهذا ينعكس مباشرة على نوع منتجات الذكاء الاصطناعي التي تستطيع الفرق متوسطة الحجم تحمّل إطلاقها.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.