مختبر ذكاء اصطناعي منزلي بتكلفة 200 ألف روبل
كان سعر بطاقة Tesla V100 قبل خمس سنوات ثمانية آلاف دولار، أما اليوم فتُباع بألف وخمسمئة دولار. وبهذا انقلبت اقتصاديات معالجات GPU السحابية رأساً على عقب: أصبح شراء العتاد الخاص أرخص من دفع إيجار شهر واحد لمزوّد السحابة. نستعرض في هذا المقال النماذج التي تعمل بكفاءة على V100، والمواضع التي تتعثر فيها البطاقة، وهل يؤتي استثمار بقيمة 200 ألف روبل ثماره.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News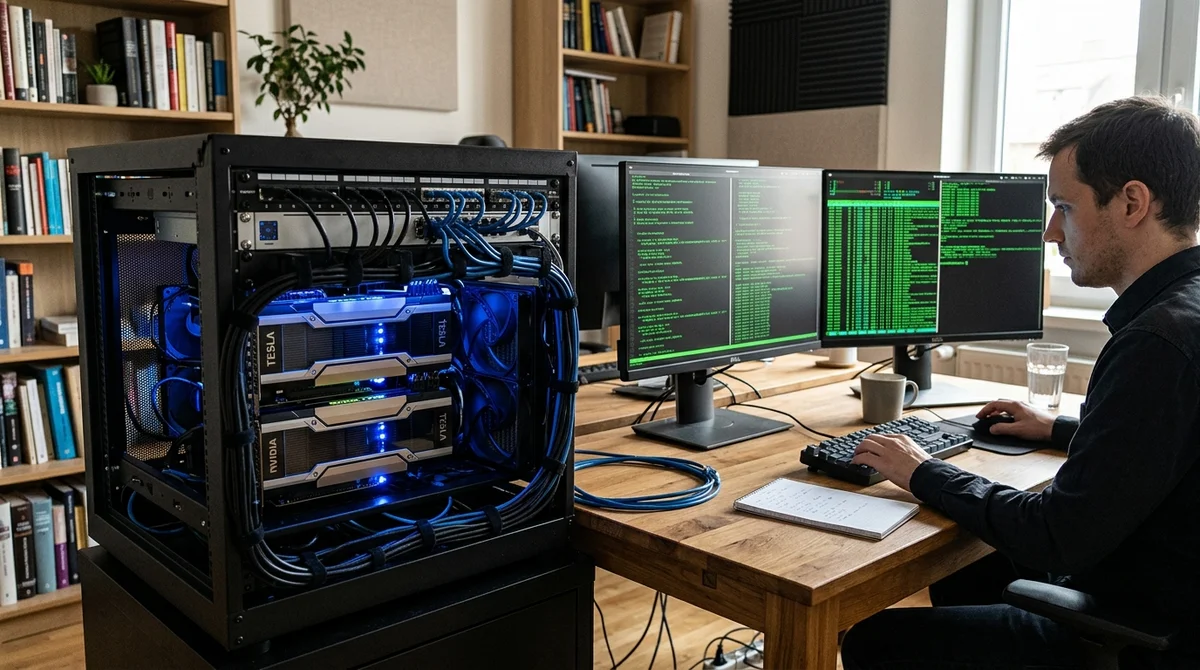
كان سعر بطاقة Tesla V100 ثمانية آلاف دولار في عام 2017. أما اليوم فتُباع في السوق المستعملة بألف وخمسمئة دولار. هذا الرقم قلب اقتصاديات معالجات GPU السحابية. فعلى Amazon أو Vast.ai يبلغ إيجار V100 ما بين 0,40 و0,80 دولار في الساعة، أي ما بين 300 و600 دولار شهرياً. اشترِ بطاقتي V100 وركّب خادماً بتكلفة 200 ألف روبل، وسيسترد المبلغ نفسه خلال ستة أشهر. وقد اشترى صاحب الاختبار هذا التجهيز بالضبط، واختبر عليه 128 شبكة عصبية مختلفة، من نماذج LLM الصغيرة إلى مولّدات الفيديو. وهذه هي النتائج.
لماذا V100 رخيصة إلى هذا الحد؟
بطاقة Tesla V100 بطاقة احترافية لمراكز البيانات، صدرت في عام 2017. تأتي بذاكرة سعتها 32 غيغابايت، وأداء 235 TFLOPS بدقة half-precision، واستهلاك حراري TDP قدره 125 واط. صُنعت بكميات ضخمة، ثم صدرت A100. وباعت مزارع الحوسبة السحابية بطاقات V100 القديمة بأسعار زهيدة، واشترى المعدِّنون الأفراد والشركات الناشئة ما تبقّى منها. واليوم امتلأ السوق المستعمل بهذه البطاقات، فانخفض السعر أكثر. الشريحة قديمة من حيث قدراتها، لكنها مثالية لمهام inference.
أين تتعثر V100؟
لنكن صريحين: تتعثر V100 مع TensorFlow (إذ إن تحسين العمليات الحسابية المقيّدة بالمعالج CPU ضعيف). وتستغرق عملية توليد الفيديو خمس دقائق على Flux.1، وهو انتظار طويل ومرهق. أما توليد النصوص فمقبول لكنه ليس سريعاً: يولّد Llama 2 70B نحو 80 توكن في الثانية بدقة int4. وللمقارنة، تقدّم A100 السحابية أكثر من 300. وهناك قيود تتعلق بالذاكرة: 32 غيغابايت تكفي لمعظم النماذج، لكن تشغيل نموذجين من فئة 70 مليار معامل في وقت واحد غير ممكن.
قياسات الأداء الفعلية
- Mistral 7B: 200 توكن/ثانية (int4)
- Llama 2 70B: 80 توكن/ثانية (int4)
- Stable Diffusion 1.5: 0.8 ثانية للصورة الواحدة
- Stable Diffusion XL: 2.5 ثانية
- Whisper Large: 0.3 من الزمن الحقيقي (ملف صوتي مدته 60 دقيقة في 18 دقيقة)
- Flux.1: 300 ثانية لصورة بدقة 1024×1024
الاقتصاديات: السحابة أم العتاد الخاص؟
تبلغ تكلفة معالجات GPU السحابية (Lambda وVast.ai) على V100 ما بين 0,40 و0,80 دولار في الساعة. أما الإيجار الشهري فيتراوح بين 300 و600 دولار. ويسترد خادمنا تكلفته خلال 4 إلى 6 أشهر من التشغيل. من مزايا الحل المحلي أن الكهرباء أرخص من حركة البيانات نحو السحابة، وأنك تملك تحكماً كاملاً، ولا تواجه أي زمن تأخير. أما عيوبه فهي أن المسؤولية عن العتاد والتبريد والترقيات تقع كلها عليك.
ماذا يعني ذلك
الخادم المحلي للذكاء الاصطناعي ليس بديلاً عن السحابة، بل مكمّل لها. فإذا كنت تشغّل النماذج يومياً، وجرّبت فكرتك، وتعرف أي الشبكات العصبية تحتاج إليها، فإن خادماً بقيمة 200 ألف روبل يوفّر عشرات الآلاف سنوياً، ويمنحك تحكماً كاملاً بالبنية التحتية.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.