عندما تُفشل البيانات القديمة نشر الذكاء الاصطناعي: المخاطر والحلول
تتسابق الشركات إلى استخدام البيانات القديمة عند نشر أنظمة الذكاء الاصطناعي. فما كان يُعدّ غبار أرشيف تحوّل فجأة إلى ذهب لتدريب النماذج. غير أن أحدًا لم يفحص ما تخفيه هذه البيانات من مخاطر أمنية وثغرات. والنتيجة أن مشاريع الذكاء الاصطناعي تتعثر عندما يكتشف المدققون مشكلات في البيانات.
معالج بواسطة الذكاء الاصطناعي من ZDNet AI؛ بتحرير Hamidun News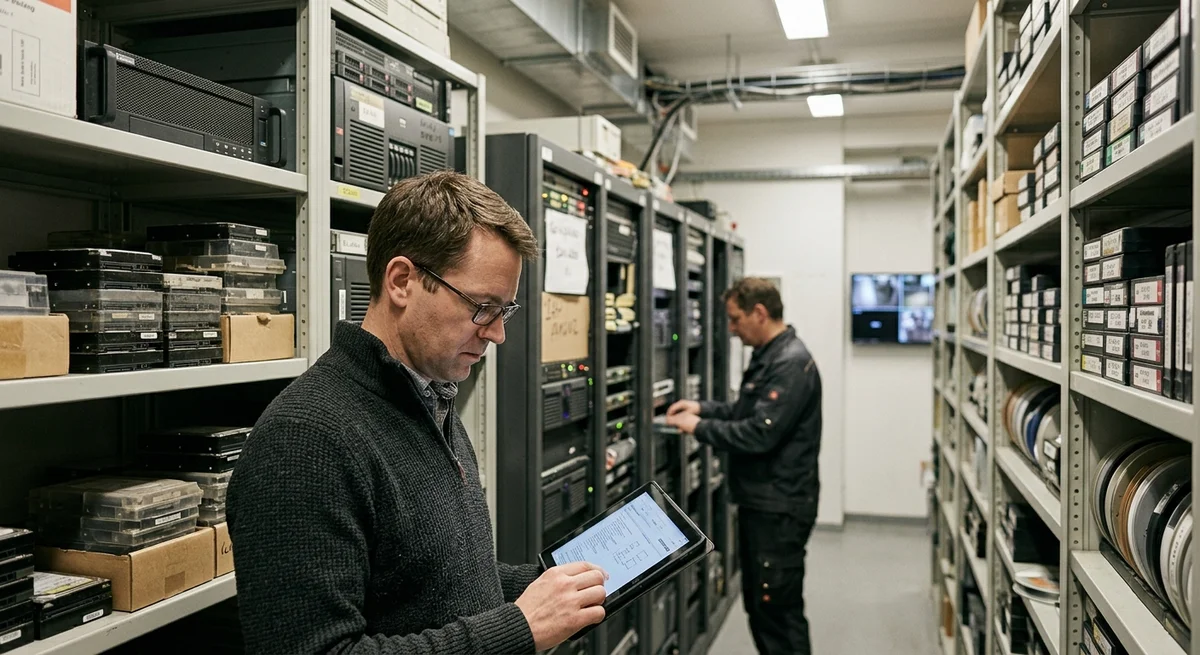
تتعجّل الشركات نشر أنظمة الذكاء الاصطناعي، وتأخذ في خضم هذا التسرّع كل البيانات المتاحة لتدريب النماذج، بما في ذلك أرشيفات يبلغ عمرها عدة سنوات أو أكثر. وهناك تنتظرها مفاجآت كثيرة غير سارة، قد تُفشل المشروع بأكمله في المرحلة الأخيرة.
لماذا أصبحت البيانات القديمة ذهبًا فجأة
حتى وقت قريب، كانت الشركات تحتفظ بالبيانات التاريخية بلا غاية محددة، انطلاقًا من مبدأ «ربما تفيد يومًا ما». لكن مع الطفرة في الذكاء الاصطناعي، تحوّلت هذه الأرشيفات فجأة إلى مورد ثمين. فالنماذج تحتاج إلى بيانات بكميات هائلة، والأرشيفات تضم أصلًا ملايين السجلات. فما الداعي إلى جمع بيانات جديدة على مدى سنوات إذا كانت القاعدة التاريخية جاهزة؟
كما أن البيانات القديمة غالبًا ما تعكس أنماطًا طويلة الأمد، مثل الاتجاهات التي تتكرر عامًا بعد عام، والاستثناءات التي تعلّم النموذج العمل الصحيح في الحالات الحدّية (edge-cases). وهذا يقصّر زمن التطوير ويخفض تكاليف جمع بيانات جديدة.
المنطق مغرٍ، لكن الأرشيفات التي يعود تاريخها إلى 5–10 سنوات لم تُفحص قط وفق معايير الأمان والخصوصية الحديثة.
المخاطر الخفية في الأرشيفات
عندما يبدأ المدققون بفحص البيانات القديمة بدقة، يعثرون على ما يلي:
- أسماء كاملة وأرقام وثائق وأرقام ضمان اجتماعي بصيغة مكشوفة
- سجلات لموظفين فُصلوا قبل 5 سنوات لكنها لم تُحذف من القاعدة
- كلمات مرور ومفاتيح API ورموز (tokens) سُجّلت يومًا بصيغة مكشوفة
- بيانات أشخاص من دول أخرى، وهو ما يشكّل انتهاكًا للائحة GDPR والقوانين المحلية
- بيانات موسومة بشكل غير صحيح، مثل معاملات صُنّفت خطأً وأخطاء في التسميات
- سجلات مكررة ومتناقضة تعلّم النموذج الضوضاء بدلًا من الإشارة
وحين يُنشر نموذج كهذا، يكتشف المنظّمون والمحامون المشكلات بسرعة. فيتجمّد العمل كله، ويلزم إعادة إعداد البيانات وإعادة تدريب النموذج وإجراء الفحص من جديد. ومشروع كان يُفترض أن يستغرق 3 أشهر يمتد إلى عام.
كيف تُدار المخاطر عمليًا
ثمة طريق بسيط: قبل استخدام البيانات القديمة، تُجرى ثلاث مراحل.
الأولى تدقيق أمني شامل للأرشيف: من أنشأ البيانات، ولأي غرض، ومتى، وهل تحتوي على معلومات سرية، وهل تتوافق مع المعايير الحديثة؟
المرحلة الثانية هي التنظيف. تُحذف سجلات الأشخاص الذين لم يعودوا موافقين على إعادة استخدامها، وتُزال المعلومات الحساسة، وتُصحَّح أخطاء الوسم.
المرحلة الثالثة هي التوثيق: من أين جاءت البيانات، وكم استغرق جمعها، ومن قام بوسمها، وما الافتراضات المضمّنة فيها.
كثيرًا ما تتخطى الشركات هذه الخطوات الثلاث في عجلتها، فتدفع الثمن
تأخيرات تمتد أشهرًا وأعمال إعادة.
ماذا يعني ذلك
نشر الذكاء الاصطناعي ليس مسألة هندسة وخوارزميات فحسب، بل هو إدارة البيانات بوصفها أصلًا. فالبيانات القديمة تتطلب من العناية بالأمان والجودة ما تتطلبه البيانات الجديدة (أو أكثر). والتسرّع في النشر يكلّف في الغالب أكثر من الوقت الذي يُصرف على التحضير والفحص.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا أصبحت البيانات القديمة ذهبًا فجأة؟
حتى وقت قريب، كانت الشركات تحتفظ بالبيانات التاريخية بلا غاية محددة، انطلاقًا من مبدأ «ربما تفيد يومًا ما». لكن مع الطفرة في الذكاء الاصطناعي، تحوّلت هذه الأرشيفات فجأة إلى مورد ثمين. فالنماذج تحتاج إلى بيانات بكميات هائلة، والأرشيفات تضم أصلًا ملايين السجلات. فما الداعي إلى جمع بيانات جديدة على مدى سنوات إذا كانت القاعدة التاريخية جاهزة؟ كما أن البيانات القديمة غالبًا ما تعكس أنماطًا طويلة الأمد، مثل الاتجاهات التي تتكرر عامًا بعد عام، والاستثناءات التي تعلّم النموذج العمل الصحيح في الحالات الحدّية (edge-cases). وهذا يقصّر زمن التطوير ويخفض تكاليف جمع بيانات جديدة. المنطق
ما أبرز التفاصيل حول المخاطر الخفية في الأرشيفات؟
عندما يبدأ المدققون بفحص البيانات القديمة بدقة، يعثرون على ما يلي: أسماء كاملة وأرقام وثائق وأرقام ضمان اجتماعي بصيغة مكشوفة سجلات لموظفين فُصلوا قبل 5 سنوات لكنها لم تُحذف من القاعدة كلمات مرور ومفاتيح API ورموز (tokens) سُجّلت يومًا بصيغة مكشوفة بيانات أشخاص من دول أخرى، وهو ما يشكّل انتهاكًا للائحة GDPR والقوانين المحلية بيانات موسومة بشكل غير صحيح، مثل معاملات صُنّفت خطأً وأخطاء في التسميات سجلات مكررة ومتناقضة تعلّم النموذج الضوضاء بدلًا من الإشارة وحين يُنشر نموذج كهذا، يكتشف المنظّمون والمحامون المشكلات بسرعة. فيتجمّد العمل كله، ويلزم إعادة إعداد البيانات وإعادة تدري
ما أبرز التفاصيل حول كيف تُدار المخاطر عمليًا؟
ثمة طريق بسيط: قبل استخدام البيانات القديمة، تُجرى ثلاث مراحل. الأولى تدقيق أمني شامل للأرشيف: من أنشأ البيانات، ولأي غرض، ومتى، وهل تحتوي على معلومات سرية، وهل تتوافق مع المعايير الحديثة؟ المرحلة الثانية هي التنظيف. تُحذف سجلات الأشخاص الذين لم يعودوا موافقين على إعادة استخدامها، وتُزال المعلومات الحساسة، وتُصحَّح أخطاء الوسم. المرحلة الثالثة هي التوثيق: من أين جاءت البيانات، وكم استغرق جمعها، ومن قام بوسمها، وما الافتراضات المضمّنة فيها. كثيرًا ما تتخطى الشركات هذه الخطوات الثلاث في عجلتها، فتدفع الثمن تأخيرات تمتد أشهرًا وأعمال إعادة.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.