Mistral تطلق Search Toolkit للبحث في تطبيقات الذكاء الاصطناعي
أطلقت Mistral AI حزمة Search Toolkit، وهي إطار عمل لبناء بحث جاهز للإنتاج (production search) في تطبيقات الذكاء الاصطناعي. يجمع الإطار ingestion وretrieval وevaluation في واجهة موحّدة. الإطار مفتوح المصدر ويعمل في أي بيئة: السحابة وon-premises وعلى أجهزة edge. الفكرة الأساسية أن الفرق تقضي أسابيع في دمج الأدوات المختلفة بدل تحسين جودة البحث.
معالج بواسطة الذكاء الاصطناعي من Mistral AI News؛ بتحرير Hamidun News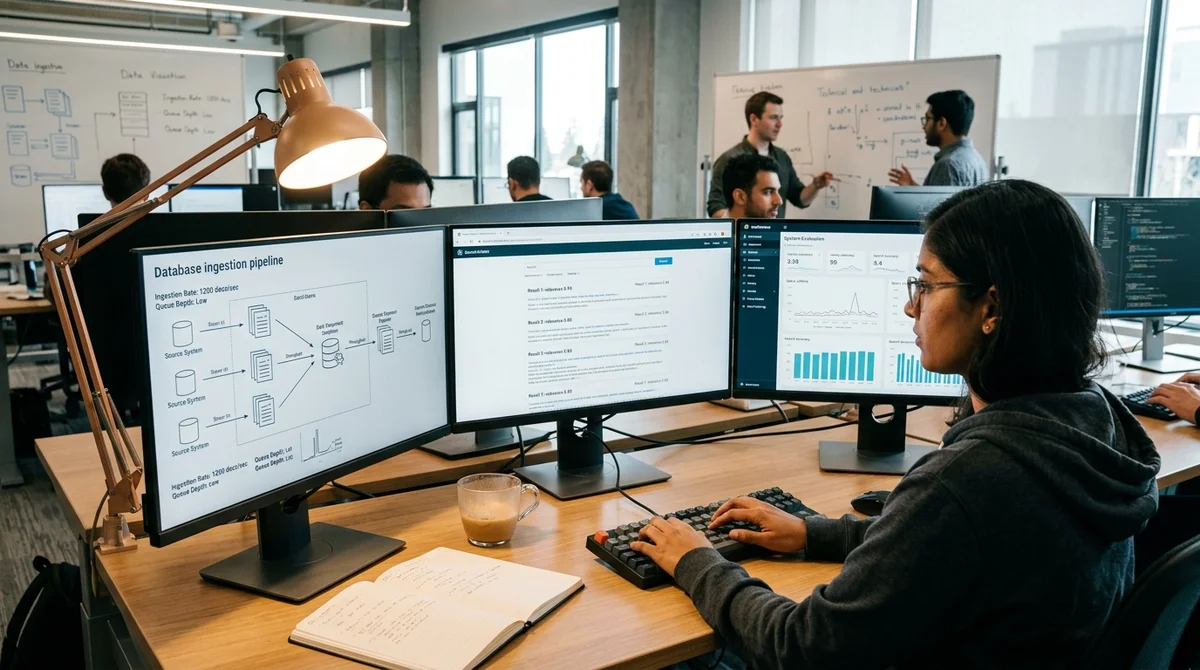
أطلقت Mistral AI حزمة Search Toolkit، وهي إطار عمل مفتوح المصدر لبناء خطوط بحث جاهزة للإنتاج (production search pipelines) في تطبيقات الذكاء الاصطناعي. تجمع الأداة ingestion وretrieval وevaluation في واجهة واحدة، كي تركّز الفرق على جودة البحث بدل دمج خدمات متفرقة. وتعمل في أي بيئة: في السحابة، وon-premises، وعلى أجهزة edge.
المشكلة: الدمج على حساب التحسين
تقضي الفرق التي تبني أنظمة البحث حاليًا وقتًا مفرطًا في ما يشبه «أعمال السباكة». فهي تحتاج إلى أداة لتحميل البيانات (ingestion)، وأخرى للبحث (retrieval)، وثالثة لتقييم النتائج (evaluation). ولكل أداة واجهتها الخاصة وافتراضاتها الخاصة حول صيغة البيانات. والنتيجة أن الفرق تقضي أسابيع في بناء طبقة الدمج قبل أن تنفّذ أول عملية بحث في بياناتها.
وتتفاقم المشكلة على مستوى المؤسسات الكبيرة، حين تبحث الشركة في عشرات المصادر في آن واحد: ويكي داخلية، وأنظمة دعم، ومستودعات وثائق، وتخزين ملفات، وقواعد شيفرة. لكل مصدر بنية مختلفة ويتطلب منطق تحليل (parsing) خاصًا به. وعندها إما تبني الفرق خط معالجة مستقلًا لكل مصدر، أو تكتب طبقة توحيد هشّة تتحول هي نفسها إلى كابوس في الصيانة.
يغيّر Search Toolkit هذا النهج: إطار عمل واحد بواجهة موحّدة للمراحل الثلاث كلها.
كيف يعمل عمليًا
صُمّم الإطار لثلاث حالات استخدام رئيسية:
- Enterprise search (البحث المؤسسي) — يمكن للمؤسسات إضافة مصادر جديدة دون إعادة بناء خط المعالجة بأكمله. وتعمل أنماط المعالجة والفهرسة نفسها مع أنواع المصادر المختلفة.
- RAG وجودة retrieval — حين يعيد نظام RAG نتائج سيئة، يصعب تحديد موضع الخلل: في retrieval أم في التوليد. وغالبًا ما تعدّل الفرق prompts واستراتيجيات chunking دون رؤية واضحة. يتضمن Search Toolkit تقييمًا مدمجًا لقياس جودة retriever بمعزل عن النموذج.
- البحث المتخصص — تتطلب الوثائق القانونية والسجلات الطبية والتقارير المالية وقواعد الشيفرة استراتيجيات مختلفة عن البحث على الويب. ولا تتعامل retriever الجاهزة (off-the-shelf) جيدًا مع المصطلحات المتخصصة ومعايير الصلة الفريدة. وكانت الشركات في السابق تبني بنية retrieval مخصصة من الصفر، وهو أمر مكلف ويصعب صيانته.
الوكلاء والبيانات الحيّة
يجب أن يتاح للوكلاء (agents) الذين ينفّذون مهام مؤسسية الوصول إلى سياق المؤسسة بأكملها. فهم يتخذون قرارات البحث بصورة مستقلة وبحجم كبير، ولذلك تؤثر جودة البنية التحتية للبحث التي يعتمدون عليها في كل خطوة لاحقة (downstream). يتيح Search Toolkit للوكلاء إجراء بحث دلالي (semantic search) في الفهارس للحصول على نتائج دقيقة بزمن استجابة (latency) منخفض. وفي الوقت نفسه، يمكن للوكلاء عبر Connectors جلب بيانات حيّة مباشرة من المصادر.
ماذا يعني ذلك
يزيح Search Toolkit قدرًا كبيرًا من العمل الهندسي عن كاهل الفرق. فبدل أسابيع من دمج الأدوات المختلفة، تبدأ الفرق ببناء أنظمة البحث فورًا. وبالنسبة للشركات التي تدمج RAG ووكلاء الذكاء الاصطناعي في أنظمتها الداخلية (المعرفة، والموارد البشرية، والمالية، والدعم الفني)، يعني ذلك وصولًا أسرع إلى الإنتاج (go-to-production) ووقتًا أطول لما يهمّ حقًا: جودة نتائج البحث.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.