كيف تختار الشبكات العصبية الرموز: logits ودرجة الحرارة وtop-p
تختار الشبكة العصبية الكلمة التالية عبر logits ودالة softmax. وتتحكم درجة الحرارة في مستوى العشوائية: فالدرجة المنخفضة تعطي إجابات دقيقة، والمرتفعة تعطي إجابات أكثر إبداعًا. أما top-p فيستبعد الخيارات ضعيفة الاحتمال. ويحدد الضبط الصحيح لهذه المعاملات جودة النص الناتج.
معالج بواسطة الذكاء الاصطناعي من Machine Learning Mastery؛ بتحرير Hamidun News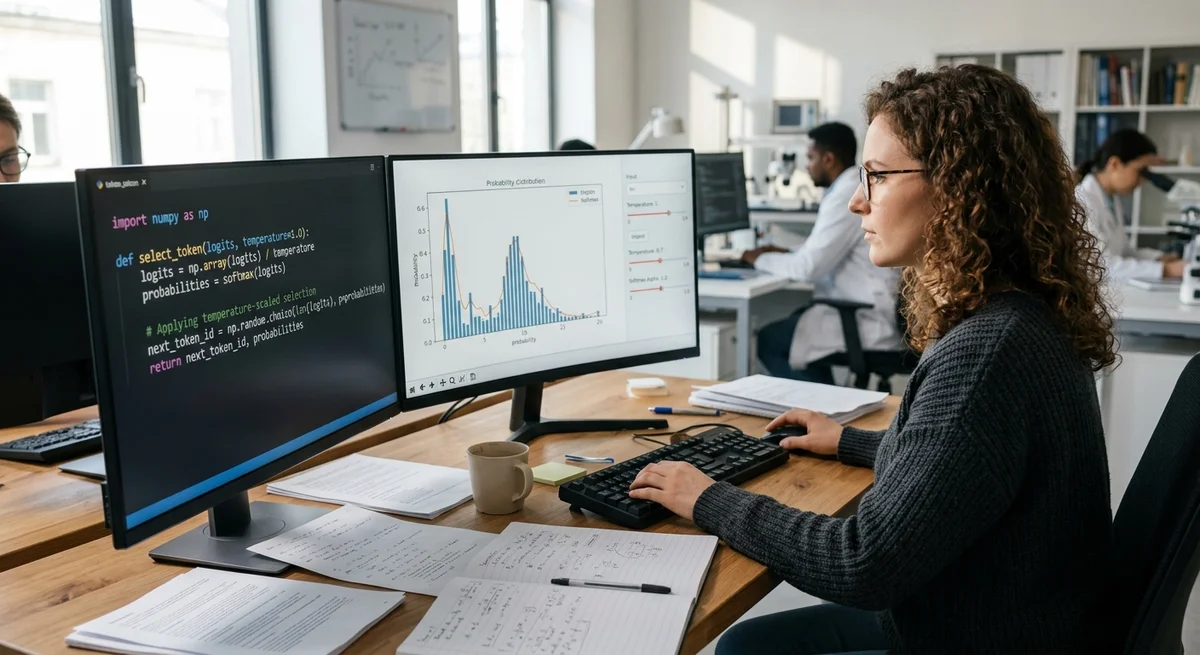
عندما يولّد النموذج اللغوي نصًا، تواجهه مهمة جوهرية: اختيار الكلمة التالية من بين آلاف المرشحين. وهذا الاختيار ليس عشوائيًا، بل تحكمه آليات احتمالية. وفهم logits ودرجة الحرارة وtop-p هو مفتاح التحكم في سلوك LLM.
ما هي logits وsoftmax
تحسب الشبكة العصبية لكل رمز (توكن) محتمل تقييمًا رقميًا يسمى logit. وهو إشارة خام تصدر عن الطبقة الأخيرة في الشبكة. فقد تحصل كلمة «الإبداع» على logit قدره 5.2، بينما تحصل كلمة «الهاتف» على 2.1.
تحوّل دالة softmax هذه الأرقام إلى احتمالات (من 0 إلى 1) يبلغ مجموعها 1.
لنفترض أن النموذج يعالج عبارة «تعلّم الآلة هو». يحسب النموذج logits لجميع كلمات القاموس. وبعد softmax نحصل على توزيع احتمالي: «علم» = 35%، «فن» = 8%، «بطريق» = 0.001%. ثم يختار النموذج عشوائيًا من هذا التوزيع، فيختار الخيارات المحتملة في الغالب، ونادرًا ما يختار الضعيفة الاحتمال.
درجة الحرارة: منظّم السلوك
درجة الحرارة هي معامل يُضرب في logits قبل softmax. الرياضيات بسيطة لكن الأثر قوي:
- T < 1 (مثلًا 0.3): يدفع النموذج نحو الجانب «الجليدي». يصبح التوزيع أكثر حدّة، وتحصل الخيارات ضعيفة الاحتمال على احتمالات ضئيلة جدًا. يختار النموذج بصورة شبه حتمية، فتأتي الإجابات متوقعة ودقيقة. وهذا مثالي للبرمجة والحقائق والتعليمات.
- T = 1: السلوك القياسي، إذ تُستخدم logits كما هي.
- T > 1 (مثلًا 1.5–2.0): يدفع النموذج نحو الجانب «الناري». يصبح التوزيع أكثر تجانسًا، وتحصل الخيارات ضعيفة الاحتمال على فرصة. يختار النموذج بعشوائية أكبر. وهذا مثالي للكتابة الإبداعية، لكنه يعرّض النموذج لخطر توليد أخطاء أو هلوسات.
فالدرجة العالية تجعل النموذج مغامرًا، والمنخفضة تجعله محافظًا.
Top-p: انتقاء ذكي
يحلّ top-p (أو nucleus sampling) مشكلة محددة: كيف نمنع النموذج من قول كلام لا معنى له، مع الإبقاء على حريته؟ تفرز الخوارزمية الرموز حسب الاحتمال، وتأخذ من أعلاها ما يكفي إلى أن يبلغ مجموع احتمالاتها القيمة p (عادةً 0.9).
مثال: إذا كان top-p = 0.9 وكان التوزيع كما يلي:
- «علم» = 40%
- «طريق» = 30%
- «معرفة» = 15%
- «حرية» = 10%
- «بطريق» = 5%
فسيأخذ النموذج الخيارات الأربعة الأولى (40+30+15+10=95%) ويستبعد «بطريق». وtop-p ديناميكي: ففي سياق ما قد ينتقي 5 خيارات، وفي سياق آخر 200.
ماذا يعني ذلك
هذه المعاملات الثلاثة ليست سحرًا، بل أدوات تحكم. يختار المطوّر درجة الحرارة وtop-p بحسب المهمة: فتوليد الشيفرة البرمجية يتطلب درجة حرارة منخفضة (الموثوقية أهم من الإبداع)، بينما تتطلب كتابة قصة درجة عالية (التنوع). وفهم هذه الآليات يحوّل العمل مع LLM من التعامل مع «صندوق أسود» إلى مهمة هندسية.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول ما هي logits وsoftmax؟
تحسب الشبكة العصبية لكل رمز (توكن) محتمل تقييمًا رقميًا يسمى logit. وهو إشارة خام تصدر عن الطبقة الأخيرة في الشبكة. فقد تحصل كلمة «الإبداع» على logit قدره 5.2، بينما تحصل كلمة «الهاتف» على 2.1. تحوّل دالة softmax هذه الأرقام إلى احتمالات (من 0 إلى 1) يبلغ مجموعها 1. لنفترض أن النموذج يعالج عبارة «تعلّم الآلة هو». يحسب النموذج logits لجميع كلمات القاموس. وبعد softmax نحصل على توزيع احتمالي: «علم» = 35%، «فن» = 8%، «بطريق» = 0.001%. ثم يختار النموذج عشوائيًا من هذا التوزيع، فيختار الخيارات المحتملة في الغالب، ونادرًا ما يختار الضعيفة الاحتمال.
ما أبرز التفاصيل حول درجة الحرارة: منظّم السلوك؟
درجة الحرارة هي معامل يُضرب في logits قبل softmax. الرياضيات بسيطة لكن الأثر قوي: T < 1 (مثلًا 0.3): يدفع النموذج نحو الجانب «الجليدي». يصبح التوزيع أكثر حدّة، وتحصل الخيارات ضعيفة الاحتمال على احتمالات ضئيلة جدًا. يختار النموذج بصورة شبه حتمية، فتأتي الإجابات متوقعة ودقيقة. وهذا مثالي للبرمجة والحقائق والتعليمات. T = 1: السلوك القياسي، إذ تُستخدم logits كما هي. T > 1 (مثلًا 1.5–2.0): يدفع النموذج نحو الجانب «الناري». يصبح التوزيع أكثر تجانسًا، وتحصل الخيارات ضعيفة الاحتمال على فرصة. يختار النموذج بعشوائية أكبر. وهذا مثالي للكتابة الإبداعية، لكنه يعرّض النموذج لخطر توليد أخ
ما أبرز التفاصيل حول Top-p: انتقاء ذكي؟
يحلّ top-p (أو nucleus sampling) مشكلة محددة: كيف نمنع النموذج من قول كلام لا معنى له، مع الإبقاء على حريته؟ تفرز الخوارزمية الرموز حسب الاحتمال، وتأخذ من أعلاها ما يكفي إلى أن يبلغ مجموع احتمالاتها القيمة p (عادةً 0.9). مثال: إذا كان top-p = 0.9 وكان التوزيع كما يلي: «علم» = 40% «طريق» = 30% «معرفة» = 15% «حرية» = 10% «بطريق» = 5% فسيأخذ النموذج الخيارات الأربعة الأولى (40+30+15+10=95%) ويستبعد «بطريق». وtop-p ديناميكي: ففي سياق ما قد ينتقي 5 خيارات، وفي سياق آخر 200.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.