Нейросети в шаблонах: почему ChatGPT, Claude, Gemini мыслят одинаково
Попросите любой чат-бот назвать случайное число от 1 до 10 — почти наверняка получите 7. Это симптом системной проблемы: все крупные LLM обучались на одинаковых данных и склонны к «групповому мышлению». Исследователи зафиксировали паттерн у Claude, ChatGPT и Gemini — один стартап разрабатывает методы преодоления этого консенсуса, чтобы модели давали по-настоящему разные ответы.
AI-обработка оригинала MIT Technology Review; редакция Hamidun News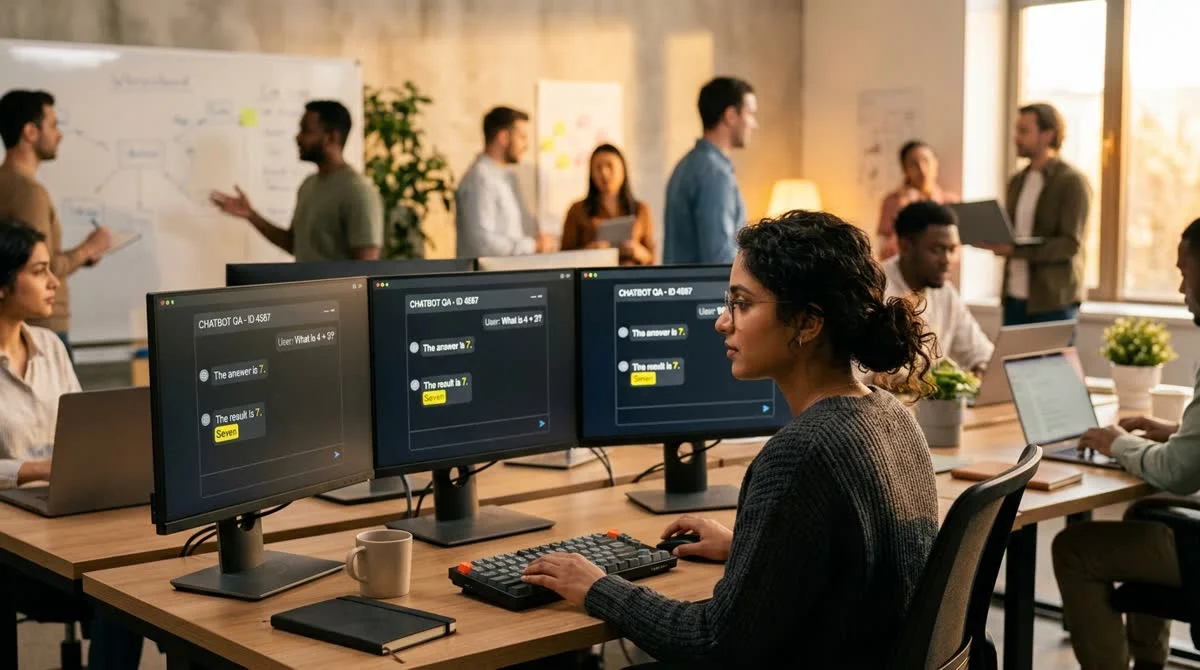
Нейросети ChatGPT, Claude и Gemini демонстрируют одинаково предсказуемые ответы на схожие запросы — MIT Technology Review 1 июля 2026 года зафиксировало это явление как системное «групповое мышление» языковых моделей и рассказало о стартапе, разрабатывающем способы его преодоления.
Тест с числами: почему это не совпадение?
Попросите любой популярный чат-бот назвать случайное число от 1 до 10 — почти наверняка получите 7. Переспросите — услышите 3 или 4, ещё раз — 8 или 9. Паттерн воспроизводится с поразительной стабильностью у разных моделей от разных компаний.
Объяснение простое: все крупные LLM обучались на схожих веб-корпусах, где «7» как ответ на этот вопрос встречается чаще других чисел — люди и сами называют семёрку «самым случайным» числом. Дообучение с подкреплением (RLHF) дополнительно поощряет «безопасные» и ожидаемые ответы: те, которые чаще получают высокие оценки от людей-оценщиков. Модели буквально обучены давать предсказуемый ответ.
- Семёрка как «случайное» число — хрестоматийный пример шаблонности LLM
- Паттерн характерен для Claude (Anthropic), ChatGPT (OpenAI) и Gemini (Google DeepMind)
- Причина — пересечение обучающих данных и схожие RLHF-процедуры у всех крупных лабораторий
Где групповое мышление причиняет реальный вред
Числа — лишь наглядный симптом. В реальных задачах проблема масштабнее: модели воспроизводят одни и те же культурные клише, формулируют стратегические рекомендации похожим образом, предлагают схожие маркетинговые решения. Когда компания использует несколько LLM для «диверсификации взглядов», она зачастую получает перефразированные версии одного и того же мнения — с иллюзией независимости.
«Мы создали экосистему, в которой все модели смотрят на мир одинаково — потому что прочитали одно и то же», — констатирует MIT
Technology Review.
Особенно остро проблема стоит там, где ценна оригинальность: генерация научных гипотез, нестандартный контент, оценка нетривиальных рисков. «Независимая проверка» через несколько LLM в таких случаях даёт иллюзию разнообразия — но не само разнообразие.
Что предлагает стартап
MIT Technology Review описывает стартап, сосредоточенный на методах преодоления «шаблонного мышления» в языковых моделях. Точная архитектура решения не раскрыта. В индустрии между тем обсуждается несколько подходов к этой задаче:
- Тренировка на более разнообразных данных с намеренным включением нишевых точек зрения
- Управляемая стохастичность на этапе дообучения — поощрение вариативности как явной цели
- Ансамблевые системы, где несколько моделей с разными «предубеждениями» дискутируют между собой
- Метрики разнообразия ответов как обязательная часть evals — наравне с точностью и безопасностью
Что это значит
Если методам преодоления «группового консенсуса» удастся задать новый стандарт отрасли, это изменит то, как мы оцениваем AI-системы: разнообразие и независимость ответов станут такими же измеримыми требованиями, как точность или безопасность. Для корпоративных пользователей это открывает возможность получать от AI действительно разные перспективы, а не статистически усреднённый взгляд в разных формулировках.
Почему ChatGPT, Claude и Gemini дают одинаковые ответы?
MIT Technology Review выявило систематическое явление, названное «групповое мышление» нейросетей — они воспроизводят одинаково предсказуемые ответы на схожие запросы, даже когда их просят быть случайными.
Можно ли исправить одинаковые ответы ИИ?
Стартап, описанный в статье, разрабатывает способы преодоления этого явления в языковых моделях.
- 24 окт. 2026 г.Саймон Уиллисон собрал страницу рассылок голосом: Codex и GPT-6 Astra за час
- 24 окт. 2026 г.Агенты в августе 2026 обогнали людей по числу PR на GitHub и задач в Linear
- 24 окт. 2026 г.Nvidia ведёт переговоры о покупке Reflection AI — стартапа с оценкой $8 млрд
- 24 окт. 2026 г.Oracle сокращает задачи с дней до минут через ChatGPT Work и Codex
Вопросы и ответы по материалу
Тест с числами: почему это не совпадение?
Попросите любой популярный чат-бот назвать случайное число от 1 до 10 — почти наверняка получите 7. Переспросите — услышите 3 или 4, ещё раз — 8 или 9. Паттерн воспроизводится с поразительной стабильностью у разных моделей от разных компаний. Объяснение простое: все крупные LLM обучались на схожих веб-корпусах, где «7» как ответ на этот вопрос встречается чаще других чисел — люди и сами называют семёрку «самым случайным» числом. Дообучение с подкреплением (RLHF) дополнительно поощряет «безопасные» и ожидаемые ответы: те, которые чаще получают высокие оценки от людей-оценщик
Почему ChatGPT, Claude и Gemini дают одинаковые ответы?
MIT Technology Review выявило систематическое явление, названное «групповое мышление» нейросетей — они воспроизводят одинаково предсказуемые ответы на схожие запросы, даже когда их просят быть случайными.
Можно ли исправить одинаковые ответы ИИ?
Стартап, описанный в статье, разрабатывает способы преодоления этого явления в языковых моделях.
Соберите и запустите AI-продукт без классического кодинга
Практический интенсив Жемала Хамидуна по вайб-кодингу в Claude Code и Cursor на hamidun.com/vibecoding: от идеи и архитектуры до рабочего продакшн-сервиса, ботов и пайплайнов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.