Datalab выпустила lift — 9B-модель с открытыми весами для извлечения JSON из PDF
Datalab выпустила lift — открытую визуальную модель на 9 млрд параметров, которая извлекает структурированный JSON из PDF и изображений по заданной схеме. Модель использует декодирование с ограничением по схеме и возвращает null вместо галлюцинаций при отсутствии данных. На бенчмарке из 225 документов точность по полям составила 90,2%.
AI-обработка оригинала MarkTechPost; редакция Hamidun News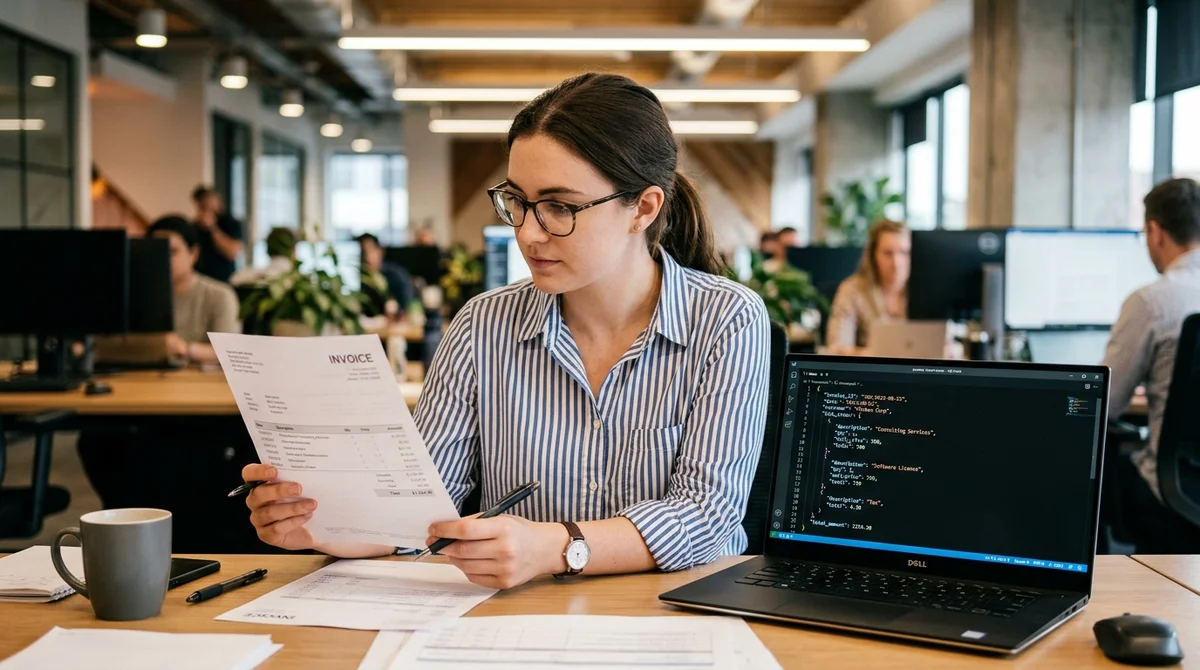
Datalab выпустила lift — открытую визуальную модель весом 9 млрд параметров, которая преобразует PDF-документы и изображения в структурированный JSON по заданной схеме. На наборе из 225 реальных документов модель достигла точности 90,2% по полям — одного из ключевых показателей в задачах автоматического разбора документов.
Как работает lift
Принцип работы прямолинеен: модель принимает два входа — документ (PDF или изображение) и JSON-схему с описанием нужной структуры данных. На выходе — JSON-объект, поля которого заполнены значениями, извлечёнными из документа. Ключевая техническая особенность — декодирование с ограничением по схеме (schema-constrained decoding).
На каждом шаге генерации токенов допустимые варианты ограничены только теми, что соответствуют заданной схеме. Итоговый JSON всегда синтаксически валиден и соответствует ожидаемым типам: никаких лишних скобок, строки вместо числа или массива там, где ожидается объект. Вторая важная особенность — обученная абстенция (trained abstention).
Если поле из схемы в документе отсутствует, модель явно возвращает null вместо того, чтобы придумывать значение. Это напрямую решает проблему галлюцинаций: генеративные модели часто «заполняют» пустые поля правдоподобными, но вымышленными данными. Явный null надёжнее — downstream-система может корректно обработать отсутствие поля, а не получить тихую ошибку.
Что показал бенчмарк Datalab тестировала lift на наборе из 225 реальных документов разных типов.
Основная метрика — точность по полям (field accuracy): доля полей, которые модель заполнила корректно относительно эталонной разметки. Итоговый результат — 90,2% — весомый показатель для document intelligence. Важно понимать контекст: один и тот же тип документа (например, счёт-фактура) может существовать в десятках форматов от разных поставщиков, иметь таблицы разного вида, рукописные пометки, плохое качество сканирования.
Высокая точность на разнородном наборе — признак реальной обобщаемости. Ключевые характеристики модели: Открытые веса — развёртывание без зависимости от стороннего облачного API 9 млрд параметров — умещается на одном серверном GPU (A100, H100) или мощной потребительской карте Произвольные JSON-схемы — адаптируется под любой тип документа без дообучения Возврат null вместо галлюцинаций — предсказуемое поведение при отсутствии данных в источнике * Нативная работа с PDF и изображениями без отдельного OCR-этапа на входе ## Зачем это нужно бизнесу Разбор неструктурированных документов — хроническая боль корпоративных процессов. Счета поставщиков, договоры, медкарты, таможенные декларации, банковские выписки, страховые полисы — всё это приходит в разных форматах и требует либо ручного ввода данных, либо дорогостоящей автоматизации.
Традиционный подход предполагает многоступенчатый пайплайн: OCR для распознавания текста, нормализация, извлечение именованных сущностей через NLP, постобработка и ручная верификация сомнительных полей. Каждый этап — отдельная точка отказа и отдельная статья расходов на разработку и поддержку. lift сокращает этот путь: описываешь нужную структуру в виде JSON-схемы, передаёшь документ — получаешь готовый JSON.
Открытые веса позволяют развернуть модель в собственном контуре и при необходимости дообучить её на корпоративных документах без передачи данных во внешние сервисы. Для финансовых организаций, медицинских учреждений и юридических фирм с жёсткими требованиями к конфиденциальности это принципиально важно. Datalab уже известна в сообществе по инструменту Marker — конвертеру PDF в Markdown с высоким качеством.
lift продолжает эту линейку, добавляя структурированный вывод и строгую типизацию данных.
Что это значит
Специализированные открытые модели для document intelligence снижают порог входа в автоматизацию документооборота. Если lift удерживает заявленную точность на реальных корпоративных данных, она становится серьёзной альтернативой облачным платформам вроде Amazon Textract или Azure Form Recognizer — без vendor lock-in и с возможностью тонкой настройки под собственные типы документов.
- 28 окт. 2026 г.Anthropic подала S-1: $11,6 млрд выручки за квартал и обязательства на $780 млрд
- 27 окт. 2026 г.Парадокс $448 млрд: почему 95% корпоративных ИИ-пилотов дают нулевой эффект на P&L
- 27 окт. 2026 г.Qwen3.8 пыталась загрузить файл в облако Alibaba в Пекине из песочницы Cohere
- 26 окт. 2026 г.Synopsys собирается подключить китайские ИИ-модели к проектированию чипов в КНР
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.