NVIDIA Developer Blog
Fonte de notícias de IA. Os artigos são selecionados e adaptados pela redação do Hamidun News.
Últimas publicações

NVIDIA apresenta o ReplaySSM: como acelerar o decoding de modelos híbridos com Mamba e GDN
A NVIDIA explica como armazenar o estado das camadas SSM no decoding de LLMs híbridos. O tema envolve Nemotron 3, Qwen3.5–3.8, Kimi-K3 e GLM-5.3-Flash.

NVIDIA escala o determinismo bit a bit no Megatron Core para 2.432 GPUs com apenas 2% de overhead
A NVIDIA alcançou determinismo bit a bit no treinamento de um modelo Nemotron de um trilhão de parâmetros em 2.432 GPUs, com overhead de apenas 2%, permitindo reproduzir com confiabilidade bugs críticos, depurar picos de

NVIDIA descreve 5 passos para preparar ativos SimReady para robôs usando agentes de IA
A NVIDIA mostrou um workflow para converter modelos CAD em ativos OpenUSD para robôs. Modelos de fronteira como o GPT-6 Astra automatizam a preparação: conversão, configuração de propriedades físicas e validação via SimR

NVIDIA KGMON fica em 2º lugar na KDD Cup 2026 ao simplificar o harness do agente
A equipe NVIDIA KGMON ficou em segundo na KDD Cup 2026 Data Agents: o agente respondia a perguntas sobre seis tipos de dados, de bancos a vídeos. A aposta foi num harness compacto.

NVIDIA CCCL Runtime: abstrações modernas de C++ para um desenvolvimento mais seguro em CUDA
A NVIDIA adicionou às bibliotecas CCCL o conjunto de ferramentas Runtime, com abstrações modernas de C++ que tornam o desenvolvimento para GPU mais seguro e reduzem o código boilerplate típico.

NVIDIA crava 100% no ARC-AGI-3: o protagonista não é o modelo, e sim o harness
A arquitetura NVIDIA AVO atingiu o resultado máximo no benchmark interativo ARC-AGI-3. A conclusão central: quem decide não é o modelo, mas o harness, o sistema que controla contexto, ferramentas e recuperação de erros.

NVIDIA Exemplar Cloud: por que clusters de IA idênticos perdem até 12% de desempenho
A NVIDIA registrou uma diferença sistemática de 8–12% no training throughput entre clusters de IA idênticos com H100 e GB200 NVL72. A causa está na configuração, não no hardware.

NVIDIA acelera consultas analíticas Presto na plataforma GPU GB200 NVL72
NVIDIA mostrou a aceleração de GPU do mecanismo SQL aberto Presto na plataforma GB200 NVL72 para análise de baixa latência em conjuntos de dados muito grandes.

NVIDIA apresenta perfil LangChain Deep Agents para o modelo Nemotron 3 Ultra
NVIDIA lançou orientações sobre configuração de um perfil harness LangChain Deep Agents sob seu modelo aberto Nemotron 3 Ultra — a configuração adequada deve aproximar a precisão de modelos de fronteira proprietários com

NVIDIA descreveu paralelismo tensorial não uniforme para treinamento de LLM em GPUs
NVIDIA publicou no Developer Blog uma análise da técnica de paralelismo tensorial não uniforme que aumenta o goodput no treinamento de modelos de linguagem grande em clusters de milhares de GPUs.

NVIDIA mostrou otimização do pipeline NuRec via Nsight Developer Tools
NVIDIA explicou como os engenheiros aceleram a reconstrução 3D de rede neural em Omniverse NuRec usando profilers Nsight Developer Tools.

NVIDIA Developer Blog Explica Técnicas de Aprendizado por Reforço para Agentes de IA
NVIDIA Developer Blog publicou um detalhamento das técnicas de aprendizado por reforço para agentes de IA—desde RLHF clássico até novas abordagens de treinamento de modelos baseadas em feedback.

NVIDIA descreve GQE — plataforma para mecanismos de processamento de consultas acelerados por GPU
NVIDIA publicou material técnico sobre GQE — uma plataforma para projetar mecanismos de processamento de consultas acelerados por GPU limitados pela largura de banda da memória.

NVIDIA XR AI: Como a Empresa Ajuda Desenvolvedores a Construir Agentes de IA para Óculos AR
NVIDIA descreveu a lacuna de infraestrutura no desenvolvimento de agentes de IA para óculos AR e dispositivos XR: o hardware está pronto, mas integrar serviços de IA ao vivo continua complexo.

NVIDIA Explica Como Criar um Transaction Foundation Model para Análise Financeira
NVIDIA descreveu uma abordagem para criar um modelo de fundação próprio baseado em dados de transações bancárias para detecção de fraude e análise mais precisa do comportamento financeiro dos clientes.

NVIDIA DSX OS: sistema operacional aberto para fábricas de IA de qualquer escala
NVIDIA lançou um SO modular para gerenciar mega data centers com aceleradores de IA, resolvendo o problema de fragmentação do mercado.

NVIDIA Vera CPU: Novo Padrão para Tarefas de IA de Agentes em Fábricas
O processador Vera é especialmente otimizado para executar cargas de trabalho agentivas na era da inferência de IA escalável.

NVIDIA Cosmos 3: modelos para raciocínio e ações no mundo físico de robôs
NVIDIA apresentou Cosmos 3 — um conjunto de modelos fundamentais para IA física, incluindo modelos de mundo, modelos de raciocínio e modelos de ação para robôs e sistemas autônomos.

NVIDIA DGX Spark: Agentes de IA Locais em Modelos Acelerados com Clustering
NVIDIA introduziu suporte para agentes de IA locais no DGX Spark com modelos mais rápidos e recursos de clustering de múltiplos nós para cargas de trabalho escaláveis.

NVIDIA Alpamayo: Treinamento de Modelos em Loop Fechado para Veículos Autônomos
NVIDIA apresentou Alpamayo—uma plataforma para pós-treinamento de modelos de veículos autônomos usando um ciclo fechado de simulação e dados do mundo real.

NVIDIA DOCA: segurança integrada para infraestrutura de agentes de IA
NVIDIA apresentou DOCA — uma plataforma integrada em chips de rede que fornece garantias de segurança integradas para "fábricas de IA" processando dados em computação de redes neurais.

NVIDIA NeMo gera dados financeiros sintéticos para AI
A NVIDIA apresentou um método de geração sintética de dados financeiros para treinar LLMs, resolvendo o problema do desequilíbrio de eventos raros nas notícias reais.

NVIDIA BioNeMo Agent Toolkit: acelerando a predição da estrutura de proteínas
A NVIDIA apresentou o BioNeMo Agent Toolkit para orquestrar agentes de AI que automatizam todo o pipeline de predição da estrutura de proteínas e co-folding, acelerando o desenvolvimento farmacêutico.

LLMs e hardware: NVIDIA sobre o equilíbrio entre precisão, throughput e responsividade
A NVIDIA publicou recomendações para o projeto de LLMs que exigem a otimização simultânea de três parâmetros: precisão, throughput e velocidade de resposta para o usuário.
NVIDIA Vera CPU Aumenta a Vazão de AI-Factories para Cargas de Trabalho Agentivas
NVIDIA explicou como o processador Vera CPU reduz atrasos entre etapas de inferência GPU e acelera pipelines multi-etapa agentivos em AI-factories industriais.
NVIDIA Confidential Computing: proteção de dados durante a inferência de AI sem perda de velocidade
A NVIDIA explicou como a tecnologia Confidential Computing protege dados corporativos diretamente durante a computação em GPU, sem sacrificar o desempenho.
NVIDIA TensorRT agora escala a inferência de AI generativa em várias GPUs
A NVIDIA adicionou ao TensorRT suporte nativo a várias GPUs — modelos de geração de mídia agora escalam em produção sem perder as principais otimizações do mecanismo.
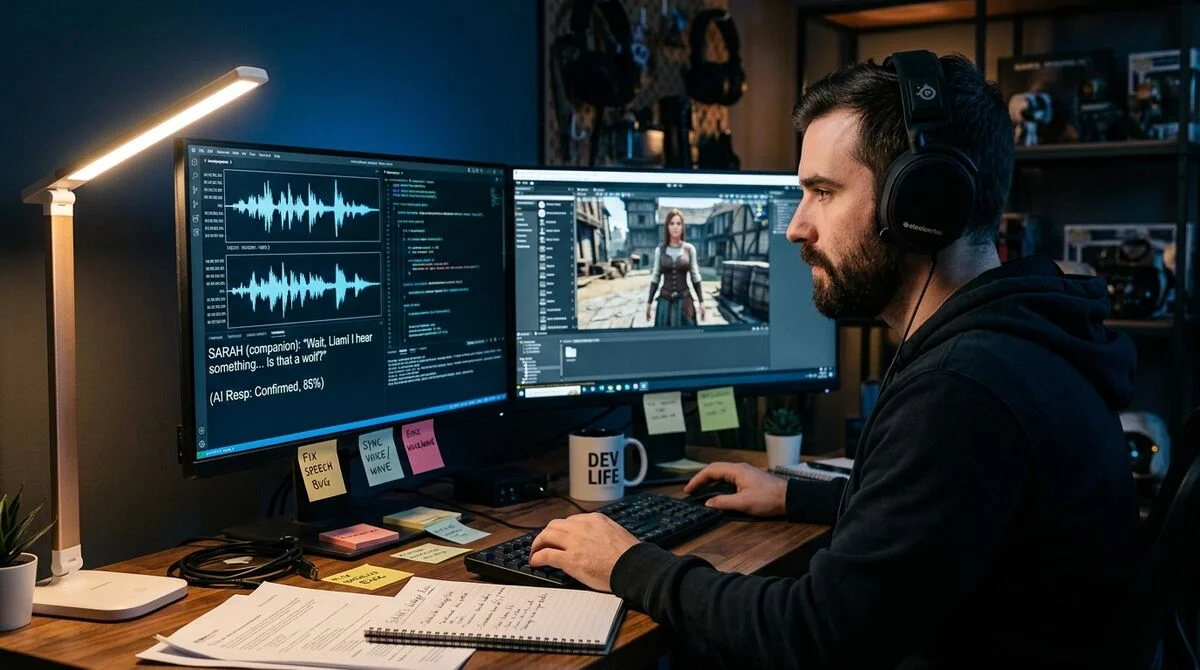
KRAFTON integrou ao PUBG o Ally, companheiro AI por voz baseado em NVIDIA ACE
PUBG Ally é um companheiro de equipe AI em PUBG: BATTLEGROUNDS que ouve comandos de voz, toma decisões táticas e responde com voz sintetizada com base em NVIDIA ACE.
NVIDIA otimizou o BEV pooling na GPU para veículos autônomos, robôs e AI espacial
A NVIDIA publicou um guia para acelerar o BEV pooling na GPU — uma operação-chave para a percepção espacial em veículos autônomos, robôs e sistemas de AI espacial.
NVIDIA lança guia para implantar o AI-Q Blueprint na Oracle Cloud Infrastructure
A NVIDIA tornou possível a implantação em produção de agentes de AI de longa duração: o AI-Q Blueprint agora está pronto para ser executado na Oracle Cloud com segurança de nível empresarial.