Together AI apresenta ATLAS: especulador que acelera LLM em 4 vezes
A Together AI apresentou o ATLAS — um especulador adaptativo baseado em machine learning que acelera inferência em LLM em 4 vezes sem configuração manual. O sistema aprende automaticamente e se adapta à sua carga de trabalho conforme você o utiliza. No DeepSeek-V3.1, atinge 500 tokens por segundo — isso é 2,65 vezes mais rápido que a decodificação padrão e supera o desempenho do equipamento especializado da Groq.
Processado por IA de Together AI Blog; editado por Hamidun News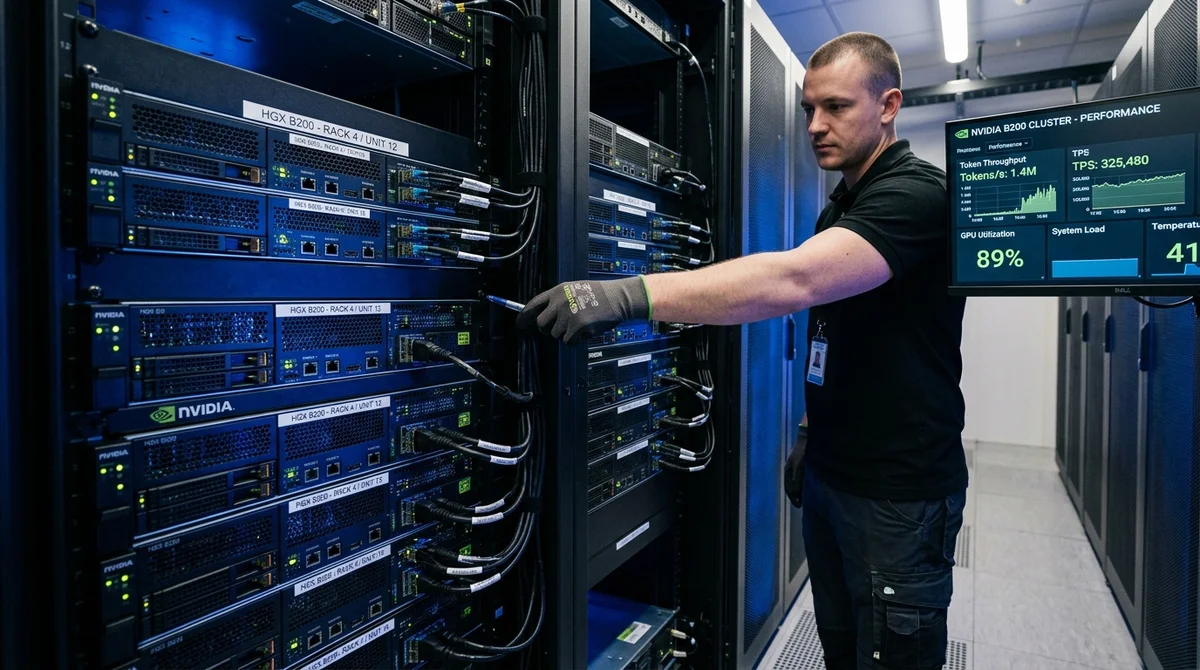
A Together AI apresentou o ATLAS (Sistema de Especulador com Aprendizado Adaptativo) — uma tecnologia revolucionária de aceleração de inferência em LLM que melhora automaticamente conforme você a utiliza. O sistema atinge 500 tokens por segundo no DeepSeek-V3.1 e 460 no Kimi-K2 — isso é praticamente 4x de aceleração sem configuração manual. Os resultados foram obtidos em NVIDIA HGX B200 usando tráfego real do benchmark Arena Hard.
O que é decodificação especulativa
A decodificação especulativa é um dos métodos mais poderosos para acelerar a geração de texto em LLMs. Em vez da abordagem padrão, onde o modelo gera um token por vez em passagens sequenciais, o sistema usa um especulador mais rápido (modelo auxiliar) que propõe vários tokens de uma vez. Em seguida, o modelo principal (alvo) verifica todos eles em paralelo em uma única passagem direta.
A qualidade da saída permanece idêntica à decodificação normal (matematicamente garantido), mas a velocidade aumenta significativamente. Se o especulador adivinhar corretamente (alto coeficiente de aceitação α), o sistema processa vários tokens de uma vez em vez de um. Na prática, isso significa uma redução significativa no tempo até o primeiro token e aceleração de toda a geração.
Como o ATLAS difere das outras soluções
Os especuladores padrão são treinados uma vez em uma carga de trabalho geral e funcionam da mesma forma em todos os lugares. Os especuladores especializados (custom speculators) são treinados em dados específicos da empresa, mas apenas para um momento específico no tempo. Quando a carga de trabalho evolui — a base de código cresce, os padrões de tráfego mudam, a distribuição de solicitações se altera, surgem novos tipos de usuários — até os especuladores altamente otimizados começam a ficar para trás.
O ATLAS resolve este problema de forma fundamentalmente diferente. O sistema aprende continuamente (continual learning) conforme você o utiliza, adaptando-se ao tráfego real e ao comportamento do modelo alvo em tempo real. Quanto mais você trabalha com o serviço, melhor o ATLAS prevê as próximas ações do modelo principal, e maior é o coeficiente de aceitação.
Isso cria um ciclo de feedback positivo: cada nova solicitação é um exemplo de treinamento que melhora o especulador.
Resultados na prática
A Together AI demonstrou os resultados em equipamento industrial NVIDIA HGX B200 com tráfego real:
- DeepSeek-V3.1: 500 TPS (tokens por segundo) — 2,65x mais rápido que a decodificação padrão
- Kimi-K2-0905: 460 TPS — também um ganho significativo
- Comparação com Groq: O ATLAS em modo totalmente adaptado supera o desempenho do equipamento especializado da Groq
- Aceleração de 4x em comparação com a solução base sem otimização
A eficiência é alcançada equilibrando dois parâmetros principais: o coeficiente de aceitação (α) — uma medida de com que frequência o modelo principal concorda com as sugestões do especulador — e a latência relativa (c) entre a velocidade do especulador e do modelo alvo. O ATLAS encontra automaticamente o ponto ideal, onde o especulador funciona muito rapidamente, mas suas previsões são precisas o suficiente para uma aceitação alta.
Integração no Together Turbo
O ATLAS está integrado no Together Turbo — um pacote de soluções de engenharia para aceleração de LLM da Together AI. Funciona em paralelo com o especulador proprietário e oferece suporte ao uso de especuladores personalizados. A principal diferença: o ATLAS requer zero configuração manual de parâmetros. Os usuários obtêm melhorias de desempenho automáticas simplesmente ao usar a plataforma. Isso é especialmente crítico para equipes em crescimento, onde a carga de trabalho não é estática. Na fase de crescimento, quando as solicitações chegam de diferentes tipos de usuários, a lógica de negócios evolui constantemente e os requisitos dos modelos mudam, as otimizações antigas frequentemente se tornam desatualizadas em semanas ou meses. O ATLAS se atualiza continuamente por si só.
O que isso significa
A aceleração de inferência em LLM passa de uma tarefa de engenharia única para um recurso dinâmico incorporado do serviço. Desenvolvedores e usuários obtêm respostas cada vez mais rápidas simplesmente ao usar a plataforma, sem qualquer intervenção manual. Para startups, agências e empresas, isso significa uma redução real nos custos de processamento de solicitações para grandes modelos em produção.
- 27 de out. de 2026Qwen3.8 tentou subir um arquivo para a nuvem da Alibaba em Pequim de dentro do sandbox da Cohere
- 26 de out. de 2026Claude Opus 5.5 vence o Code2Video-AA com 1536 Elo e supera o GPT-6 Astra por 109 pontos
- 26 de out. de 2026Lançamento de produtos 4,5 vezes mais rápido e 87% de economia de orçamento: 3 arquiteturas de IA segura sob a lei russa 152-FZ
- 26 de out. de 2026ENISA e JRC começam a testar modelos open-weight chineses, confirmam três autoridades
Perguntas frequentes sobre a notícia
O que é decodificação especulativa?
A decodificação especulativa é um dos métodos mais poderosos para acelerar a geração de texto em LLMs. Em vez da abordagem padrão, onde o modelo gera um token por vez em passagens sequenciais, o sistema usa um especulador mais rápido (modelo auxiliar) que propõe vários tokens de uma vez. Em seguida, o modelo principal (alvo) verifica todos eles em paralelo em uma única passagem direta. A qualidade da saída permanece idêntica à decodificação normal (matematicamente garantido), mas a velocidade aumenta significativamente. Se o especulador adivinhar corretamente (alto coeficie
Como o ATLAS difere das outras soluções?
Os especuladores padrão são treinados uma vez em uma carga de trabalho geral e funcionam da mesma forma em todos os lugares. Os especuladores especializados (custom speculators) são treinados em dados específicos da empresa, mas apenas para um momento específico no tempo. Quando a carga de trabalho evolui — a base de código cresce, os padrões de tráfego mudam, a distribuição de solicitações se altera, surgem novos tipos de usuários — até os especuladores altamente otimizados começam a ficar para trás. O ATLAS resolve este problema de forma fundamentalmente diferente. O sist
O que se sabe sobre Resultados na prática?
A Together AI demonstrou os resultados em equipamento industrial NVIDIA HGX B200 com tráfego real: DeepSeek-V3.1: 500 TPS (tokens por segundo) — 2,65x mais rápido que a decodificação padrão Kimi-K2-0905: 460 TPS — também um ganho significativo Comparação com Groq: O ATLAS em modo totalmente adaptado supera o desempenho do equipamento especializado da Groq Aceleração de 4x em comparação com a solução base sem otimização A eficiência é alcançada equilibrando dois parâmetros principais: o coeficiente de aceitação (α) — uma medida de com que frequência o modelo principal concor
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.