McKinsey aponta quatro passos para escalar IA agêntica com dados de qualidade
A McKinsey publicou um plano prático para empresas que querem tirar a IA agêntica dos pilotos e levá-la à escala de produção. Segundo a consultoria, menos de 10% dessas iniciativas chegam à produção, e a principal causa é o trabalho fraco com dados. As recomendações se resumem a quatro passos: escolher workflows de alto valor, atualizar a arquitetura de dados, adotar controle contínuo de qualidade e definir regras claras para a gestão dos agentes.
Processado por IA de ZDNet AI; editado por Hamidun News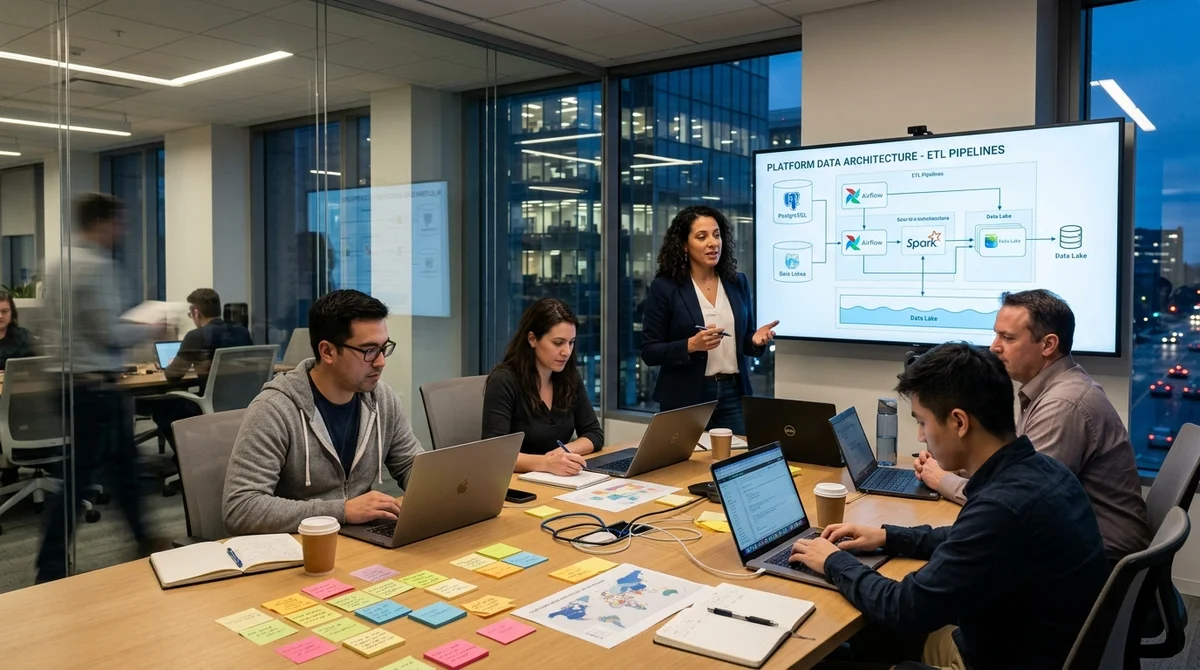
A McKinsey divulgou recomendações para empresas que tentam escalar a IA agêntica e esbarram não nos modelos, mas nos dados. A tese central é simples: sem uma base de dados comum, workflows claros e governança rígida, os agentes não saem dos pilotos e não chegam a um processo de negócio real.
Por que os pilotos travam
Segundo a McKinsey, quase dois terços das empresas já experimentaram agentes de IA, mas menos de 10% conseguiram levá-los a uma escala que entregue valor de negócio perceptível. Em oito de cada dez casos, a barreira são os dados: ficam em sistemas dispersos, têm contextos diferentes, não passam por verificações de qualidade unificadas e se adaptam mal a decisões autônomas. Enquanto uma pessoa junta as fontes manualmente e confere o resultado, o piloto ainda pode funcionar. Quando as mesmas ações precisam ser feitas o tempo todo e em tempo real, a estrutura começa a desmoronar.
O problema se agrava conforme cresce a autonomia. Um único agente pode percorrer vários sistemas em sequência e tomar decisões com base em informações fragmentadas, e um grupo de agentes especializados ainda pode repassar erros uns aos outros. Por isso a McKinsey coloca no centro não o modelo em si, mas a capacidade da empresa de dar aos agentes acesso estável a dados, definições claras, rastreabilidade e regras de acesso. Do contrário, a automação impressiona na demo, mas quebra no primeiro volume sério de operações.
Os quatro primeiros passos
A McKinsey propõe não reconstruir a empresa inteira de uma vez, e sim começar por quatro passos conectados, que ligam estratégia, arquitetura e modelo operacional. A lógica é: primeiro escolher os processos em que a autonomia realmente se paga, depois preparar a infraestrutura e só então ampliar a escala. A abordagem serve para não gastar meses em pilotos caros sem efeito repetível e para não arrastar velhos problemas de dados para a nova camada de agentes.
- Escolher 1-2 workflows de alto impacto e avaliá-los por valor, viabilidade e efeito estratégico
- Atualizar as camadas da arquitetura de dados para que os agentes troquem contexto com segurança
- Passar de limpezas pontuais para o controle contínuo da qualidade de dados estruturados e não estruturados
- Implantar modelo operacional e governança: papéis, permissões de acesso, logs, políticas e pontos de aprovação humana
Há ênfase especial em executar os quatro passos de forma coordenada. Se a empresa escolheu o caso certo, mas manteve a arquitetura antiga, o agente esbarrará em sistemas incompatíveis. Se a arquitetura já é moderna, mas faltam regras de acesso e registro das ações, a escala logo vira risco para a segurança, o compliance e a qualidade das decisões de negócio. A McKinsey também aconselha validar a abordagem em pilotos direcionados com métricas claras e já buscar dados que possam ser reaproveitados em workflows vizinhos.
Que fundação é necessária
Por arquitetura pronta para agentes, a McKinsey entende não um novo monolito, mas um conjunto de camadas modulares. Os dados devem entrar uma única vez na empresa e depois servir a analytics, machine learning e IA generativa, sem pipelines paralelos separados para cada tarefa. A camada semântica tem papel importante: ela descreve o que cada entidade significa, como os objetos se relacionam e quais regras de negócio valem. Na prática, isso leva a ontologias, grafos de conhecimento e produtos de dados com dono, qualidade e interfaces de acesso bem definidos.
A McKinsey destaca separadamente o trabalho com dados não estruturados: documentos, imagens, correspondências, histórico de atendimentos. Para que os agentes usem esse conteúdo com confiança, é preciso etiquetá-lo, classificá-lo, indexá-lo via embeddings e conectá-lo ao restante do modelo de dados corporativo. Para dados estruturados, a prioridade é outra: em vez de limpeza manual periódica, monitoramento constante de qualidade, validação automática, detecção de anomalias e armazenamento de lineage. Os mesmos padrões devem valer para os dados criados pelos próprios agentes.
A última camada é a governança do ciclo de vida dos agentes. A empresa deve definir de antemão o que o agente pode fazer, a quais dados tem acesso, onde é preciso confirmação humana e quem responde pelo resultado. Isso inclui emissão de credenciais, telemetria, logs de ações, controle de desempenho e verificações automáticas de conformidade com políticas. Nesse esquema, as equipes de negócio respondem por seus workflows e pelo modelo de domínio, e as equipes centrais de dados e IA, pelas plataformas comuns, guardrails e supervisão.
O que isso significa
O mercado vem migrando aos poucos da pergunta "qual modelo escolher" para "em quais dados e processos ele vai atuar". Para as empresas, é uma má notícia para demos rápidas, mas boa para quem está pronto para construir a IA agêntica como parte do sistema operacional do negócio, e não como um experimento isolado.
Perguntas frequentes sobre a notícia
Por que os pilotos travam?
Segundo a McKinsey, quase dois terços das empresas já experimentaram agentes de IA, mas menos de 10% conseguiram levá-los a uma escala que entregue valor de negócio perceptível. Em oito de cada dez casos, a barreira são os dados: ficam em sistemas dispersos, têm contextos diferentes, não passam por verificações de qualidade unificadas e se adaptam mal a decisões autônomas. Enquanto uma pessoa junta as fontes manualmente e confere o resultado, o piloto ainda pode funcionar. Quando as mesmas ações precisam ser feitas o tempo todo e em tempo real, a estrutura começa a desmoron
O que se sabe sobre Os quatro primeiros passos?
A McKinsey propõe não reconstruir a empresa inteira de uma vez, e sim começar por quatro passos conectados, que ligam estratégia, arquitetura e modelo operacional. A lógica é: primeiro escolher os processos em que a autonomia realmente se paga, depois preparar a infraestrutura e só então ampliar a escala. A abordagem serve para não gastar meses em pilotos caros sem efeito repetível e para não arrastar velhos problemas de dados para a nova camada de agentes. Escolher 1-2 workflows de alto impacto e avaliá-los por valor, viabilidade e efeito estratégico Atualizar as camadas d
O que se sabe sobre Que fundação é necessária?
Por arquitetura pronta para agentes, a McKinsey entende não um novo monolito, mas um conjunto de camadas modulares. Os dados devem entrar uma única vez na empresa e depois servir a analytics, machine learning e IA generativa, sem pipelines paralelos separados para cada tarefa. A camada semântica tem papel importante: ela descreve o que cada entidade significa, como os objetos se relacionam e quais regras de negócio valem. Na prática, isso leva a ontologias, grafos de conhecimento e produtos de dados com dono, qualidade e interfaces de acesso bem definidos. A McKinsey destac
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.