NeuralSet e deep learning: decodificando características da linguagem a partir de sinais MEG do cérebro
Uma análise do NeuralSet detalha um pipeline de ponta a ponta que transforma sinais MEG em previsões de características da linguagem. No exemplo, o modelo estima o tamanho de uma palavra a partir da resposta do cérebro, da carga e limpeza dos dados até o treinamento de uma rede de deep learning na prática. Não é um produto de consumo chamativo, e sim um tutorial prático para neuroengenheiros, laboratórios de pesquisa e equipes que constroem sistemas de neuroAI com biossinais reais.
Processado por IA de MarkTechPost; editado por Hamidun News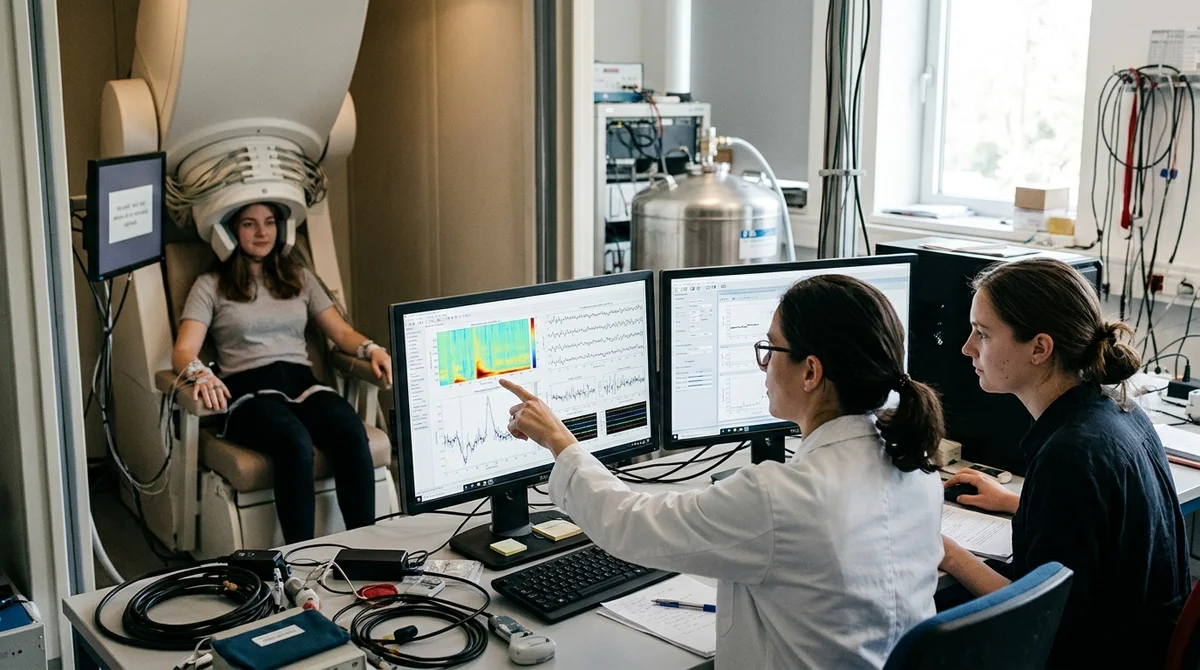
Uma nova análise técnica apresenta um pipeline de neuroAI que extrai características da linguagem diretamente de sinais MEG. Como demonstração, um sistema baseado em NeuralSet e deep learning tenta prever o tamanho de uma palavra a partir da resposta do cérebro a um estímulo linguístico.
Como o pipeline funciona
O interessante do material é que ele não mostra um trecho isolado de pesquisa, mas uma cadeia de engenharia quase completa, da preparação do ambiente ao treinamento do modelo com sinais neurais. No centro está a MEG, método que registra os campos magnéticos gerados pela atividade dos neurônios. Em seguida, os dados percorrem o caminho padrão em neuroAI: carregamento, limpeza, sincronização com os estímulos, montagem dos exemplos de treino e entrada em uma rede que deve associar padrões de atividade cerebral a uma propriedade linguística específica.
A tarefa-alvo é bastante simples, mas reveladora: o sistema estima o tamanho da palavra que a pessoa percebeu, usando apenas a resposta cerebral. É uma ressalva importante. Não se trata de "leitura de mente" livre, e sim da previsão de uma característica estritamente definida em um experimento controlado.
Esse formato é útil para desenvolvedores e pesquisadores: permite verificar se uma abordagem de ponta a ponta consegue extrair significado de biossinais brutos ou minimamente processados, sem dividir o processo em dezenas de etapas manuais.
Por que a MEG importa
Para tarefas de linguagem, a MEG é especialmente conveniente pela alta precisão temporal. Enquanto a fMRI mostra bem onde a atividade ocorre, a MEG é mais adequada para responder quando exatamente o cérebro reage a uma palavra, um som ou uma característica isolada do estímulo. Em tarefas ligadas ao tamanho da palavra, à ordem dos caracteres ou ao processamento semântico inicial, essa dinâmica em milissegundos costuma importar mais do que um mapa espacial grosseiro. Por isso, o interesse por esses pipelines cresce não só entre neurocientistas, mas também entre equipes que atuam na interseção entre IA e interfaces cérebro-computador.
Também vale destacar que a análise usa o NeuralSet como base para organizar os dados e o modelo. Na prática, isso é mais útil do que uma descrição seca de arquitetura no papel: o leitor vê como montar um processo reproduzível, e não apenas a ideia final. Nesses temas, a reprodutibilidade costuma ser o que freia o avanço. Mesmo um bom modelo rende pouco se a equipe não consegue subir rapidamente o ambiente, levar os registros MEG a um formato único e repetir o experimento com a própria amostra sem montar cada etapa à mão.
O que há na implementação
Pelo que a descrição indica, o tutorial cobre as etapas essenciais para um primeiro protótipo funcional. Não é uma visão geral abstrata sobre "redes neurais para o cérebro", mas uma implementação em código que mostra como dados neurais viram uma tarefa supervisionada. Para engenheiros, o valor está justamente nessa objetividade: dá para pegar a base, trocar a característica-alvo, conectar outro dataset e verificar rapidamente se a mesma abordagem funciona em um novo problema.
- configuração do ambiente Python e das dependências do pipeline de neuroAI
- carregamento de dados MEG e pré-processamento básico dos sinais
- associação das respostas cerebrais aos estímulos linguísticos
- treinamento de um modelo de deep learning para prever o tamanho da palavra
- avaliação dos resultados e verificação de quanta informação linguística útil o sinal carrega
Esse formato é especialmente útil agora, quando o mercado de ferramentas de IA se afasta rapidamente dos modelos puramente textuais em direção a interfaces multimodais e de biossinais. Mesmo que a tarefa do tamanho da palavra pareça restrita, ela responde a uma pergunta mais geral: é possível extrair de forma estável características estruturadas de um sinal cerebral complexo sem pesada engenharia manual? Se a resposta for positiva, ainda que em parte, a mesma abordagem pode ser estendida à fonética, à categoria da palavra, a classes semânticas e a outros níveis da análise linguística.
O que isso significa
O valor prático desta publicação não está em promessas grandiosas, mas em reduzir a barreira de entrada na neuroAI. Quando os desenvolvedores ganham código reproduzível para trabalhar com MEG e características da linguagem, a área avança mais rápido dos slides de pesquisa para sistemas verificáveis. Para a indústria, ainda não é um produto pronto, mas já é um caminho claro rumo às futuras interfaces cérebro-computador e a novas ferramentas para estudar a fala.
Perguntas frequentes sobre a notícia
Como o pipeline funciona?
O interessante do material é que ele não mostra um trecho isolado de pesquisa, mas uma cadeia de engenharia quase completa, da preparação do ambiente ao treinamento do modelo com sinais neurais. No centro está a MEG, método que registra os campos magnéticos gerados pela atividade dos neurônios. Em seguida, os dados percorrem o caminho padrão em neuroAI: carregamento, limpeza, sincronização com os estímulos, montagem dos exemplos de treino e entrada em uma rede que deve associar padrões de atividade cerebral a uma propriedade linguística específica. A tarefa-alvo é bastante
Por que a MEG importa?
Para tarefas de linguagem, a MEG é especialmente conveniente pela alta precisão temporal. Enquanto a fMRI mostra bem onde a atividade ocorre, a MEG é mais adequada para responder quando exatamente o cérebro reage a uma palavra, um som ou uma característica isolada do estímulo. Em tarefas ligadas ao tamanho da palavra, à ordem dos caracteres ou ao processamento semântico inicial, essa dinâmica em milissegundos costuma importar mais do que um mapa espacial grosseiro. Por isso, o interesse por esses pipelines cresce não só entre neurocientistas, mas também entre equipes que at
O que há na implementação?
Pelo que a descrição indica, o tutorial cobre as etapas essenciais para um primeiro protótipo funcional. Não é uma visão geral abstrata sobre "redes neurais para o cérebro", mas uma implementação em código que mostra como dados neurais viram uma tarefa supervisionada. Para engenheiros, o valor está justamente nessa objetividade: dá para pegar a base, trocar a característica-alvo, conectar outro dataset e verificar rapidamente se a mesma abordagem funciona em um novo problema. configuração do ambiente Python e das dependências do pipeline de neuroAI carregamento de dados MEG
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.