Nvidia quer dominar toda a pilha do data center de IA, dos chips às redes e ao armazenamento
Na GTC 2026, a Nvidia apresentou uma nova aposta: vender não só GPUs, mas um data center de IA inteiro para cargas de trabalho corporativas. A pilha inclui Vera Rubin, racks de CPU independentes, a rede Spectrum-6, o armazenamento BlueField-4 STX e o Groq 3 LPX para inferência rápida. Segundo a empresa, essa abordagem vai baratear os tokens e aumentar a receita por megawatt.
Processado por IA de ZDNet AI; editado por Hamidun News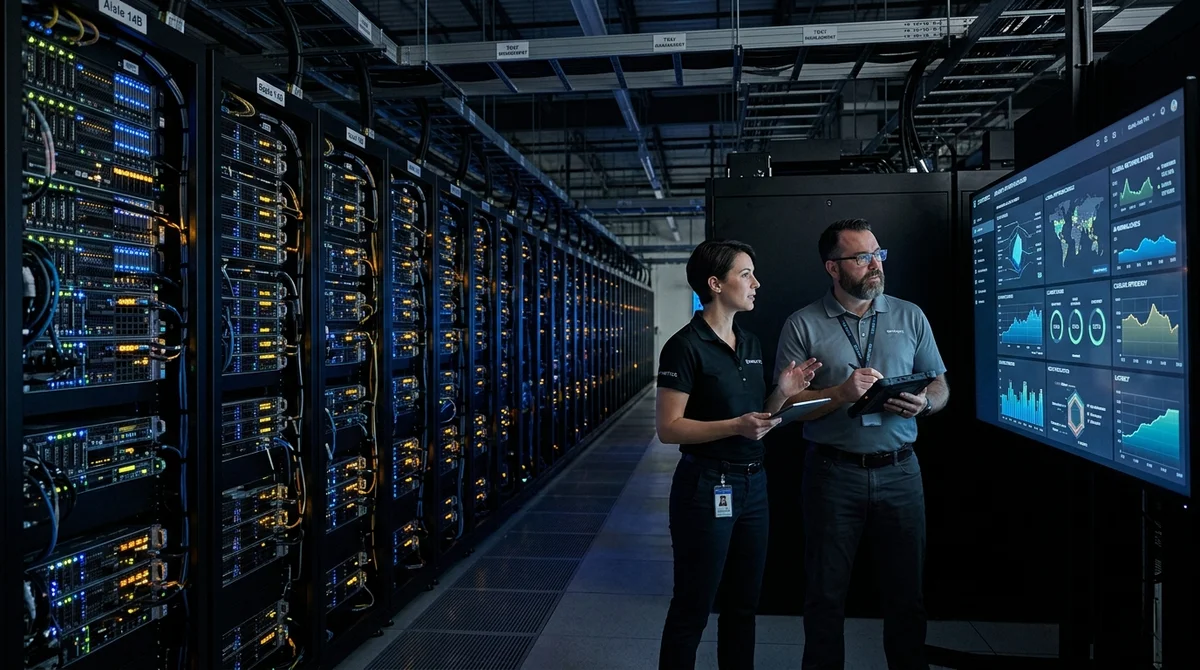
Na GTC 2026, a Nvidia mostrou que não quer mais ser apenas fornecedora de GPUs. A empresa oferece aos clientes um data center de IA completo como produto único, da computação e das redes ao armazenamento de contexto e ao software de gerenciamento.
Aposta na verticalização
O principal sinal da apresentação de Jensen Huang não foi um chip novo, mas a arquitetura do negócio. A Nvidia alinhou no palco uma linha de racks e disse ao mercado, na prática, que a infraestrutura de IA será mais barata, mais rápida e mais lucrativa se for comprada como pilha completa de um único fornecedor, e não em componentes avulsos. Isso já não é o modelo "vendemos aceleradores e vocês montam o resto", mas uma tentativa de transformar o data center em um sistema totalmente projetado pela Nvidia.
Huang promove há tempos a ideia da AI factory: uma fábrica que produz tokens e inteligência do mesmo modo que uma indústria produz peças. Agora a ideia ficou ainda mais rígida: a Nvidia quer controlar não só a computação, mas também a rede, a memória, o armazenamento de dados intermediários, a camada de CPU e o software que liga tudo isso. Com o boom dos sistemas agênticos, a abordagem parece lógica: o gargalo deixou de ser apenas a GPU e passou a incluir tudo que move dados entre elas.
O que entrou na pilha
Na nova configuração, a Nvidia reuniu vários racks, cada um resolvendo um problema específico do data center de IA. Juntos, formam um kit quase completo para empresas que constroem grandes clusters de treinamento e inferência e não querem integrar dezenas de fornecedores heterogêneos em um só esquema.
- Vera Rubin NVL72: sistema principal em escala de rack, com 72 GPUs Rubin e 36 CPUs Vera.
- Vera CPU Rack: rack independente com 256 CPUs para tarefas de IA agêntica, em que importam tool calling, SQL e execução de código.
- BlueField-4 STX: camada de armazenamento e entrega rápida de cache KV, necessária aos grandes modelos de linguagem na inferência.
- Spectrum-6 SPX: nova rede Ethernet para conectar racks e escalar o cluster.
- Groq 3 LPX: rack de inferência com 256 aceleradores LPU, focado em baixa latência e grande contexto.
O sentido dessa montagem é que a Nvidia agora não vende só a "potência bruta" das GPUs. Ela cobre as partes do sistema em que normalmente se perdem milissegundos, watts e dinheiro: transferência de dados entre chips, tratamento de contexto, latências de rede, tarefas de CPU para agentes e balanceamento geral de carga. Quanto maior o modelo e o contexto, mais perceptível é esse custo adicional.
Onde a Nvidia busca ganhos
O argumento mais visível da Nvidia é a economia da inferência. A empresa afirma que a combinação de Vera Rubin e Groq 3 LPX reduz os acessos à DRAM externa graças ao grande volume de SRAM na LPU, o que diminui a latência e acelera a geração de tokens. Segundo a Nvidia, esse arranjo pode entregar até 35 vezes mais vazão por megawatt para modelos com trilhões de parâmetros e até 10 vezes mais receita por watt em cenários com tokens "premium" caros.
"O que antes exigia um dia inteiro de consultas agora será feito em
menos de uma hora."
A Nvidia também aposta na camada de CPU. Diz abertamente que, mesmo na era das GPUs, os agentes esbarram o tempo todo em tarefas computacionais comuns: chamada de ferramentas, consultas SQL, compilação e execução de código em sandbox. Por isso, a empresa coloca no centro suas próprias CPUs Vera e acrescenta DPUs e um armazenamento especializado de contexto. Isso amplia as ambições da Nvidia muito além dos aceleradores e mostra que ela quer ficar com cada vez mais margem na infraestrutura de IA.
O que isso significa
Para o mercado, é mais um passo rumo a data centers de IA verticalizados, em que um único fornecedor responde por quase tudo. Para os clientes, esse modelo pode trazer implantação mais simples e melhor eficiência, ao custo de maior dependência da Nvidia. Para os concorrentes, de fabricantes de CPU e redes a fornecedores de armazenamento, é um sinal de que a Nvidia não joga mais apenas no campo das GPUs.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Autor do Habr faz fine-tuning do YOLOv8l em radiografias dentárias e leva o mAP50 a 0,642
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
Perguntas frequentes sobre a notícia
O que se sabe sobre Aposta na verticalização?
O principal sinal da apresentação de Jensen Huang não foi um chip novo, mas a arquitetura do negócio. A Nvidia alinhou no palco uma linha de racks e disse ao mercado, na prática, que a infraestrutura de IA será mais barata, mais rápida e mais lucrativa se for comprada como pilha completa de um único fornecedor, e não em componentes avulsos. Isso já não é o modelo "vendemos aceleradores e vocês montam o resto", mas uma tentativa de transformar o data center em um sistema totalmente projetado pela Nvidia. Huang promove há tempos a ideia da AI factory: uma fábrica que produz t
O que entrou na pilha?
Na nova configuração, a Nvidia reuniu vários racks, cada um resolvendo um problema específico do data center de IA. Juntos, formam um kit quase completo para empresas que constroem grandes clusters de treinamento e inferência e não querem integrar dezenas de fornecedores heterogêneos em um só esquema. Vera Rubin NVL72: sistema principal em escala de rack, com 72 GPUs Rubin e 36 CPUs Vera. Vera CPU Rack: rack independente com 256 CPUs para tarefas de IA agêntica, em que importam tool calling, SQL e execução de código. BlueField-4 STX: camada de armazenamento e entrega rápida
Onde a Nvidia busca ganhos?
O argumento mais visível da Nvidia é a economia da inferência. A empresa afirma que a combinação de Vera Rubin e Groq 3 LPX reduz os acessos à DRAM externa graças ao grande volume de SRAM na LPU, o que diminui a latência e acelera a geração de tokens. Segundo a Nvidia, esse arranjo pode entregar até 35 vezes mais vazão por megawatt para modelos com trilhões de parâmetros e até 10 vezes mais receita por watt em cenários com tokens "premium" caros. "O que antes exigia um dia inteiro de consultas agora será feito em menos de uma hora." A Nvidia também aposta na camada de CPU.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.