Google lança WAXAL, conjunto de dados de fala aberto para idiomas africanos
O Google abriu o WAXAL, um conjunto de dados de fala para idiomas africanos que deve acelerar o reconhecimento e a síntese de voz em idiomas de poucos recursos. Para o reconhecimento, coletou-se fala natural por meio da descrição de imagens; para a síntese, gravações mais limpas a partir de textos balanceados. O Google também mostra que o projeto já está em expansão, cobre dezenas de idiomas e continuará sendo ampliado.
Processado por IA de MarkTechPost; editado por Hamidun News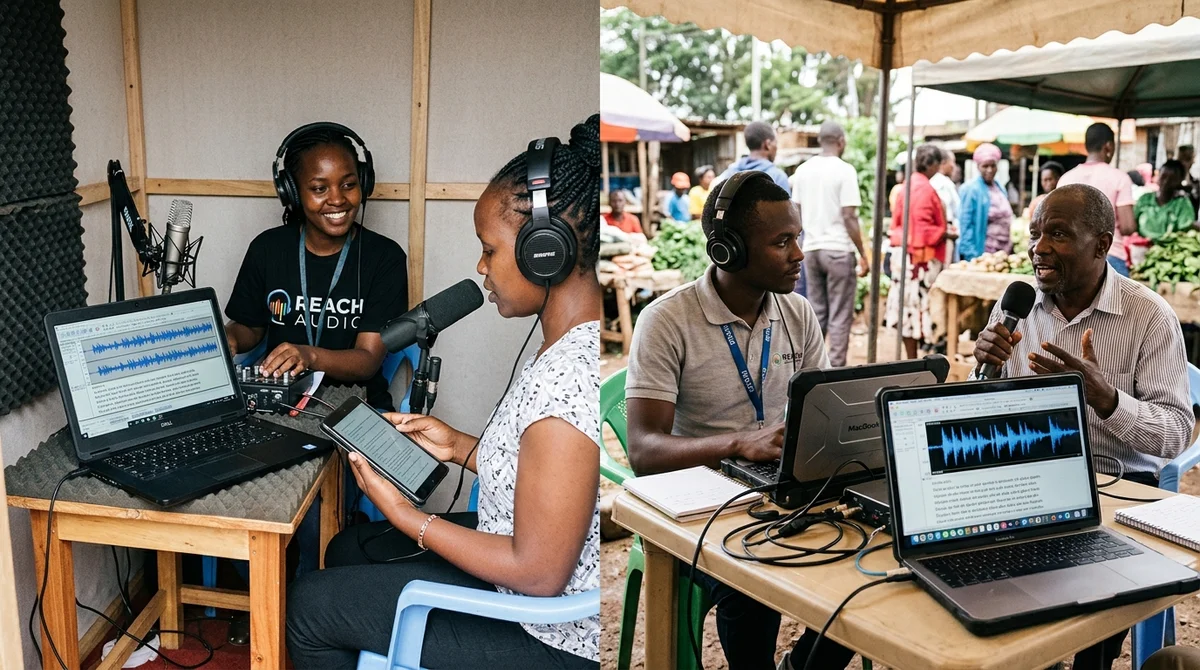
O Google abriu o WAXAL, um grande corpus de fala para idiomas africanos, criado como base para sistemas de reconhecimento e síntese de voz. O projeto mira um mercado em que as tecnologias de voz evoluem bem mais devagar por causa da falta crônica de dados abertos de qualidade.
Por que isso importa
Há tempos, o principal problema da IA de fala não são os modelos, e sim a distribuição dos dados. Para inglês, espanhol ou chinês existem enormes corpora abertos e comerciais, e por isso o reconhecimento de fala e a síntese de voz avançam rápido. Para muitos idiomas africanos ocorre o oposto: pouca fala anotada, poucas gravações de qualidade e poucas licenças abertas. Por isso, falantes de idiomas com milhões de pessoas ainda recebem qualidade pior em ditado, legendas automáticas, assistentes de voz e narração de interfaces.
O WAXAL tenta fechar justamente essa lacuna de infraestrutura.
É significativo que o projeto já pareça vivo, e não um arquivo estático. Na descrição técnica, a equipe fala em 24 idiomas e em um conjunto inicial para tarefas de reconhecimento e síntese de fala. No blog de lançamento do Google de 6 de março de 2026, já aparece uma entrega inicial ampliada: 27 idiomas, mais de 1.846 horas de dados para reconhecimento de fala e mais de 565 horas para síntese. Ou seja, o Google não apenas publicou um conjunto de dados; ao que tudo indica, está construindo uma base aberta de longo prazo para idiomas que costumam ficar fora das grandes plataformas de IA.
Como o WAXAL é organizado
O WAXAL foi dividido em duas partes independentes, porque reconhecimento de fala e síntese de voz têm requisitos de dados diferentes. O primeiro precisa de falantes variados, ambiente natural e fala espontânea para que o modelo funcione melhor em condições reais. A segunda exige áudio mais limpo, textos foneticamente balanceados e gravação controlada; do contrário, é difícil obter uma voz natural e estável. Nesse sentido, o WAXAL não parece uma "pasta de áudios" genérica, mas um conjunto pensado para duas classes de tarefas.
- Na parte de reconhecimento de fala, os participantes foram convidados a descrever imagens no idioma nativo, em vez de ler roteiros prontos.
- O Google diz que esses estímulos cobriram mais de 50 temas e extraíram melhor a fala natural, incluindo nuances tonais e alternância entre idiomas.
- Na parte de síntese, usaram-se textos foneticamente balanceados e condições de gravação mais controladas.
- O conjunto foi lançado sob a licença aberta CC-BY-4.0, para que possa ser usado em pesquisa e em produtos aplicados.
Quem coletou os dados
O ponto-chave do projeto não é só o volume, mas a forma de coleta. O Google não trabalhou sozinho, e sim com universidades e organizações locais africanas, entre elas Makerere University, University of Ghana, Digital Umuganda, African Institute for Mathematical Sciences Senegal, Media Trust e Loud and Clear Communications. Esse formato importa porque equipes locais entendem melhor os hábitos de fala, a mistura de idiomas, as variantes regionais de pronúncia e os contextos em que as pessoas realmente falam, em vez de ler um texto no silêncio de um laboratório.
"O corpus foi criado pela comunidade e para a comunidade que precisa dele."
Os detalhes de produção também são interessantes. Na parte de TTS, os participantes prepararam textos de 10 a 20 mil palavras e trabalharam em duplas: um lia, o outro gravava e verificava a qualidade. Para obter um som mais limpo, algumas equipes chegaram a montar seus próprios estúdios improvisados.
O Google ressalta que o WAXAL deve ajudar não só benchmarks acadêmicos, mas cenários reais: interfaces de voz locais, ditado automático, transcrição automática, narração de serviços e sistemas conversacionais que precisam entender fala espontânea, e não apenas um texto lido com perfeição.
Em torno do corpus, já começa a crescer um ecossistema aplicado e de pesquisa. O Google menciona trabalhos de coleta de dados para pessoas com distúrbios de fala, um grande corpus à parte para cinco idiomas de Gana e benchmarks para modelos como Whisper, XLS-R, MMS e W2v-BERT em idiomas africanos. É um bom sinal: o WAXAL serve não só como arquivo, mas como ponto de referência comum para comparar modelos, encontrar pontos fracos e levar produtos de voz mais rápido a uma qualidade utilizável.
O que isso significa
O WAXAL reduz a barreira de entrada para startups, pesquisadores e equipes locais que querem criar IA de voz não apenas para idiomas globais. Se esses corpora abertos crescerem e forem atualizados com regularidade, os idiomas africanos terão a chance de alcançar mais rápido o restante do mercado em qualidade de reconhecimento, síntese e acessibilidade de serviços digitais.
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
Perguntas frequentes sobre a notícia
Por que isso importa?
Há tempos, o principal problema da IA de fala não são os modelos, e sim a distribuição dos dados. Para inglês, espanhol ou chinês existem enormes corpora abertos e comerciais, e por isso o reconhecimento de fala e a síntese de voz avançam rápido. Para muitos idiomas africanos ocorre o oposto: pouca fala anotada, poucas gravações de qualidade e poucas licenças abertas. Por isso, falantes de idiomas com milhões de pessoas ainda recebem qualidade pior em ditado, legendas automáticas, assistentes de voz e narração de interfaces. O WAXAL tenta fechar justamente essa lacuna de in
Como o WAXAL é organizado?
O WAXAL foi dividido em duas partes independentes, porque reconhecimento de fala e síntese de voz têm requisitos de dados diferentes. O primeiro precisa de falantes variados, ambiente natural e fala espontânea para que o modelo funcione melhor em condições reais. A segunda exige áudio mais limpo, textos foneticamente balanceados e gravação controlada; do contrário, é difícil obter uma voz natural e estável. Nesse sentido, o WAXAL não parece uma "pasta de áudios" genérica, mas um conjunto pensado para duas classes de tarefas. Na parte de reconhecimento de fala, os participan
O que se sabe sobre Quem coletou os dados?
O ponto-chave do projeto não é só o volume, mas a forma de coleta. O Google não trabalhou sozinho, e sim com universidades e organizações locais africanas, entre elas Makerere University, University of Ghana, Digital Umuganda, African Institute for Mathematical Sciences Senegal, Media Trust e Loud and Clear Communications. Esse formato importa porque equipes locais entendem melhor os hábitos de fala, a mistura de idiomas, as variantes regionais de pronúncia e os contextos em que as pessoas realmente falam, em vez de ler um texto no silêncio de um laboratório. "O corpus foi
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.