NVIDIA e PNY promovem a RTX PRO 6000 Blackwell para análise de dados e desenvolvimento de IA
A PNY promove estações de trabalho com a NVIDIA RTX PRO 6000 Blackwell como substitutas de sistemas baseados em CPU para data science. Os principais argumentos: até 50 vezes mais velocidade no pandas via cuDF sem reescrever código, menor tempo de treinamento do XGBoost e a possibilidade de instalar até quatro GPUs em uma única máquina. A aposta é o processamento local dos dados, menos dependência da nuvem e controle de custos.
Processado por IA de IEEE Spectrum AI; editado por Hamidun News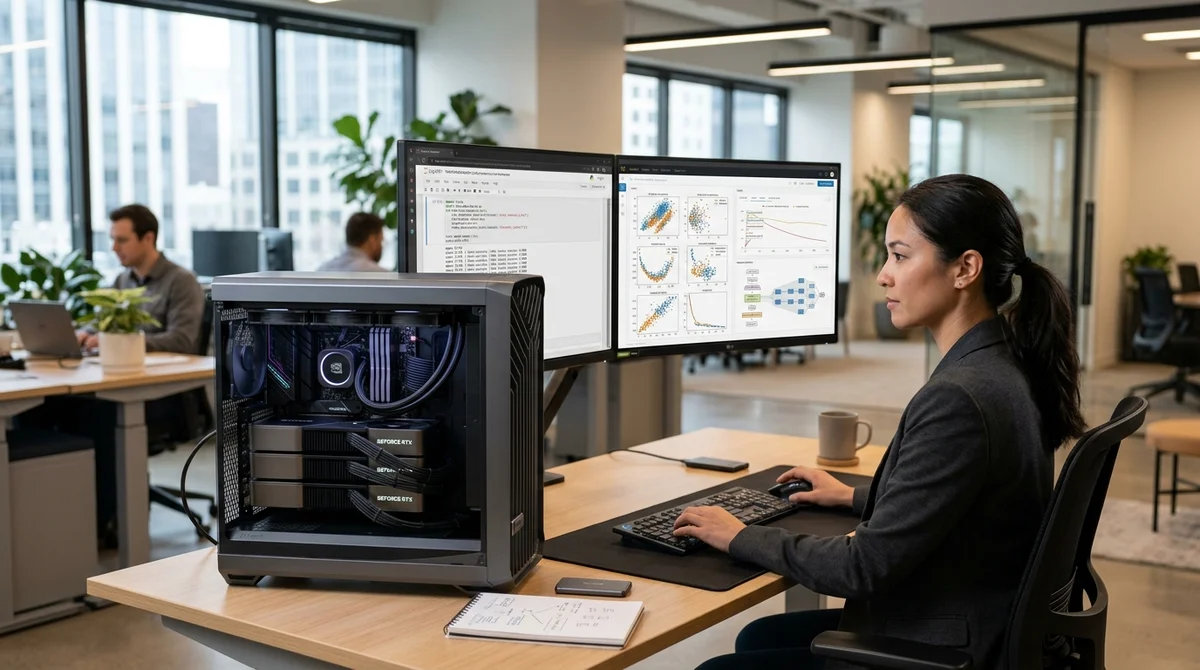

Em um conteúdo patrocinado para a IEEE Spectrum, a PNY promove a NVIDIA RTX PRO 6000 Blackwell Workstation Edition como alternativa local à nuvem e aos data centers para tarefas de data science. A tese central: parte dos pipelines pesados de IA e análise pode ser acelerada em dezenas de vezes direto na estação de trabalho.
Por que a CPU não dá conta
O argumento se apoia em três gargalos conhecidos pela maioria das equipes de data science. O primeiro é a preparação dos dados: limpeza, junção de tabelas, preenchimento de lacunas e criação de features costumam consumir a maior parte do tempo antes do treinamento do modelo. O segundo é a escala: os volumes crescem mais rápido do que os sistemas de mesa com CPU conseguem processar, e por isso as equipes às vezes reduzem as amostras e perdem qualidade nos resultados. O terceiro é o hardware: o acesso a aceleradores na nuvem e em data centers é caro e, em alguns casos, limitado.
Nesse contexto, NVIDIA e PNY propõem devolver parte da carga às estações de trabalho locais. A ideia é simples: se um analista ou engenheiro de ML tem sob a mesa uma máquina com várias GPUs, ele depende menos das filas da infraestrutura compartilhada, testa hipóteses mais rápido e não envia dados sensíveis para fora. Para equipes corporativas, isso é apresentado como um meio-termo entre velocidade, privacidade e controle de custos.
O que a Blackwell promete
A ênfase está em acelerar todo o fluxo, das operações do pandas ao treinamento de modelos. Segundo a NVIDIA, a biblioteca cuDF, da pilha CUDA-X, consegue acelerar pipelines Python sem reescrever código, e a combinação com PyData e XGBoost deve reduzir de forma perceptível o tempo de análise exploratória e de treinamento. A plataforma também foi pensada para cenários multiusuário, visualização avançada e trabalho colaborativo via NVIDIA AI Workbench, para que o mesmo projeto possa rodar em uma máquina local, na nuvem e em um data center.
- até quatro GPUs RTX PRO 6000 Blackwell Max-Q em uma única estação de trabalho
- aceleração do pandas via cuDF sem alterar o código, até 50 vezes segundo a empresa
- operação join: quase 5 minutos na CPU contra 14 segundos na GPU
- group by: quase 4 minutos na CPU contra 4 segundos na GPU
- treinamento de XGBoost que antes levava semanas, e que a empresa promete reduzir a minutos
«a GPU de mesa mais poderosa já criada»
O tom de marketing da publicação é direto: é assim que a PNY descreve a RTX PRO 6000 Blackwell no vídeo que acompanha o material. É uma afirmação forte, mas o próprio conteúdo não traz testes independentes nem comparação com alternativas em configuração equivalente. Por isso, vale encarar os números como uma referência do fabricante: eles mostram a classe de tarefas em que a GPU realmente traz ganho, mas não substituem um benchmark completo com o seu stack e os seus dados.
Aposta no processamento local
Outro argumento é a economia e a segurança. Quando parte do pipeline sai da nuvem e vai para a estação de trabalho, a empresa paga menos pelo aluguel de computação e pelo armazenamento, e os datasets sensíveis permanecem dentro do perímetro. Para setores com exigência de processamento on-premise, isso pesa mais do que o desempenho puro. Além disso, uma máquina local reduz a dependência da escassez de GPUs nos data centers: é preciso esperar menos por uma vaga de treinamento ou negociar um orçamento separado.
A PNY também destaca o lado corporativo: integração com a infraestrutura de TI existente, soluções de rede NVIDIA ConnectX, ferramentas de implantação e alto uptime. A mensagem é clara: a RTX PRO 6000 Blackwell não é vendida como uma «placa para entusiastas», mas como um bloco de construção para o desenvolvimento corporativo de IA. Principalmente para equipes que precisam de iterações rápidas em grandes datasets, mas não estão prontas para migrar totalmente para a nuvem nem para disputar o tempo todo os recursos de um cluster compartilhado.
O que isso significa
O mercado de hardware para IA se desloca cada vez mais de promessas universais para um cenário concreto: oferecer a uma equipe de data science desempenho de nível data center direto no local de trabalho. Se os ganhos anunciados se confirmarem em cargas reais, essas estações podem virar uma camada intermediária entre o notebook do analista e um cluster caro de GPUs. Mas é melhor comprá-las depois de testar nos próprios pipelines, e não com base em um benchmark publicitário.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Autor do Habr faz fine-tuning do YOLOv8l em radiografias dentárias e leva o mAP50 a 0,642
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
Perguntas frequentes sobre a notícia
Por que a CPU não dá conta?
O argumento se apoia em três gargalos conhecidos pela maioria das equipes de data science. O primeiro é a preparação dos dados: limpeza, junção de tabelas, preenchimento de lacunas e criação de features costumam consumir a maior parte do tempo antes do treinamento do modelo. O segundo é a escala: os volumes crescem mais rápido do que os sistemas de mesa com CPU conseguem processar, e por isso as equipes às vezes reduzem as amostras e perdem qualidade nos resultados. O terceiro é o hardware: o acesso a aceleradores na nuvem e em data centers é caro e, em alguns casos, limita
O que a Blackwell promete?
A ênfase está em acelerar todo o fluxo, das operações do pandas ao treinamento de modelos. Segundo a NVIDIA, a biblioteca cuDF, da pilha CUDA-X, consegue acelerar pipelines Python sem reescrever código, e a combinação com PyData e XGBoost deve reduzir de forma perceptível o tempo de análise exploratória e de treinamento. A plataforma também foi pensada para cenários multiusuário, visualização avançada e trabalho colaborativo via NVIDIA AI Workbench, para que o mesmo projeto possa rodar em uma máquina local, na nuvem e em um data center. até quatro GPUs RTX PRO 6000 Blackwel
O que se sabe sobre Aposta no processamento local?
Outro argumento é a economia e a segurança. Quando parte do pipeline sai da nuvem e vai para a estação de trabalho, a empresa paga menos pelo aluguel de computação e pelo armazenamento, e os datasets sensíveis permanecem dentro do perímetro. Para setores com exigência de processamento on-premise, isso pesa mais do que o desempenho puro. Além disso, uma máquina local reduz a dependência da escassez de GPUs nos data centers: é preciso esperar menos por uma vaga de treinamento ou negociar um orçamento separado. A PNY também destaca o lado corporativo: integração com a infraest
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.