AWS explica como acelerar o fine-tuning do Llama 3.2 Vision com dados do S3
A AWS não apresentou um modelo novo, e sim um jeito prático de refinar LLMs multimodais mais rápido com dados do S3. No exemplo, a equipe conecta SageMaker Unified Studio, Catalog e S3 e usa esse circuito para fazer o fine-tuning do Llama 3.2 11B Vision Instruct em visual question answering. Para as empresas, é um sinal importante: acervos não estruturados podem ser ligados a um pipeline de ML sem montagem manual extra.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News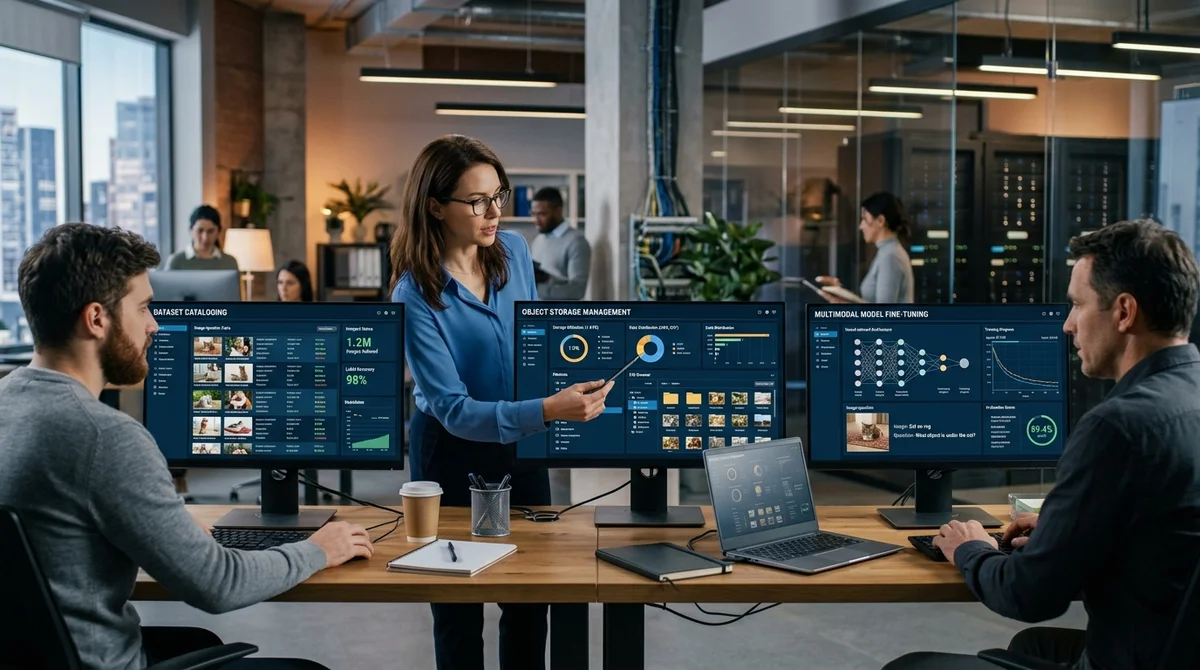
A AWS mostrou um cenário prático de trabalho com dados não estruturados no ecossistema SageMaker. A empresa descreveu como conectar o Amazon S3 ao SageMaker Catalog e ao Unified Studio e, depois, usar esse circuito para fazer o fine-tuning do modelo Llama 3.2 11B Vision Instruct em tarefas de visual question answering.
Como funciona a combinação
O caso se baseia em uma integração que a AWS anunciou no ano passado: o Amazon SageMaker Unified Studio consegue trabalhar com buckets S3 comuns, e não apenas com conjuntos de dados preparados separadamente dentro do ambiente de ML. Para as equipes, é uma mudança importante, porque a maior parte do material útil está justamente no armazenamento de objetos: imagens, PDFs, digitalizações, apresentações, documentos internos, exportações e outros arquivos não estruturados.
Antes, entre o armazenamento e o treinamento do modelo costumava surgir uma camada manual extra: transferência, duplicação, rotulagem e catalogação à parte. Agora a AWS mostra um esquema mais direto. O S3 serve como armazenamento básico, o SageMaker Catalog ajuda a descrever e organizar os dados, e o Unified Studio vira um ambiente de trabalho comum para analistas e engenheiros de ML. Nessa abordagem, os dados não ficam apenas «parados no bucket», mas se tornam um ativo acessível e governado dentro do pipeline. Isso reduz o atrito entre as equipes e permite passar mais rápido dos arquivos brutos ao experimento com o modelo, sem montar uma infraestrutura separada para cada projeto.
O que o exemplo mostra
Na demonstração, a AWS usou o Llama 3.2 11B Vision Instruct e a tarefa de visual question answering, ou VQA. Nesse cenário, o modelo precisa olhar uma imagem e responder a perguntas sobre o conteúdo. Tarefas assim aparecem em processamento de documentos, e-commerce, suporte, inspeções e bases de conhecimento internas, onde importa não só guardar a imagem, mas extrair dela uma resposta em texto compreensível. Para esse tipo de fine-tuning, é especialmente crítico que os dados visuais e as anotações associadas estejam reunidos em um circuito claro.
O valor prático do post está no fato de a AWS dar ênfase não aos benchmarks do modelo, mas à velocidade de montagem do fluxo de trabalho. Para muitas empresas, o gargalo não é escolher a LLM, e sim o caminho de «temos um acervo de arquivos» até «iniciamos o retreinamento para uma tarefa de negócio específica». A integração do S3 com Catalog e Unified Studio encurta justamente esse caminho. Em vez de etapas manuais dispersas, a equipe ganha um processo mais conectado, mais fácil de repetir, documentar e escalar para outros conjuntos de dados.
- Dá para usar buckets S3 já existentes, sem migração para um novo armazenamento
- A equipe ganha um espaço único para trabalhar com dados, análise e experimentos de ML
- Fica mais fácil transformar arquivos não estruturados em datasets reutilizáveis
- Modelos multimodais podem ser adaptados a cenários aplicados, como VQA
- Diminui o volume de operações manuais entre o armazenamento dos dados e o início do fine-tuning
Ainda assim, a AWS não promete que o fine-tuning agora seja uma tarefa de «um clique». A qualidade do resultado continua dependendo da rotulagem, da limpeza dos dados, da formulação da pergunta e de quão bem foi escolhido o conjunto-base de exemplos. Mas a parte de infraestrutura fica mais simples: o armazenamento de objetos deixa de ser um arquivo passivo e passa a ser uma fonte de trabalho para ML e análise. Para empresas com grandes volumes de imagens e documentos, isso pode reduzir de forma notável o tempo até o primeiro protótipo útil.
O que isso significa
A AWS empurra o mercado das conversas abstratas sobre as capacidades dos modelos para a montagem prática de um pipeline de dados ao modelo. A conclusão para as empresas é simples: a vantagem vem cada vez mais não só da escolha de uma LLM forte, mas da velocidade com que a equipe consegue conectar seus dados não estruturados, descrevê-los e transformá-los em um circuito gerenciado para fine-tuning repetível. Quanto menos emendas manuais entre armazenamento, catálogo e treinamento, mais rápido surgem modelos aplicados a processos específicos.
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
- 31 de out. de 2026LTX-2.5 de 22 bilhões de parâmetros roda em RTX 3080 de 10 GB, mas leva 5 minutos por plano
- 29 de out. de 2026T-Tech cria o método LIMe, que treina modelos de linguagem com 15% menos computação
Perguntas frequentes sobre a notícia
Como funciona a combinação?
O caso se baseia em uma integração que a AWS anunciou no ano passado: o Amazon SageMaker Unified Studio consegue trabalhar com buckets S3 comuns, e não apenas com conjuntos de dados preparados separadamente dentro do ambiente de ML. Para as equipes, é uma mudança importante, porque a maior parte do material útil está justamente no armazenamento de objetos: imagens, PDFs, digitalizações, apresentações, documentos internos, exportações e outros arquivos não estruturados. Antes, entre o armazenamento e o treinamento do modelo costumava surgir uma camada manual extra: transferê
O que o exemplo mostra?
Na demonstração, a AWS usou o Llama 3.2 11B Vision Instruct e a tarefa de visual question answering, ou VQA. Nesse cenário, o modelo precisa olhar uma imagem e responder a perguntas sobre o conteúdo. Tarefas assim aparecem em processamento de documentos, e-commerce, suporte, inspeções e bases de conhecimento internas, onde importa não só guardar a imagem, mas extrair dela uma resposta em texto compreensível. Para esse tipo de fine-tuning, é especialmente crítico que os dados visuais e as anotações associadas estejam reunidos em um circuito claro. O valor prático do post est
O que isso significa?
A AWS empurra o mercado das conversas abstratas sobre as capacidades dos modelos para a montagem prática de um pipeline de dados ao modelo. A conclusão para as empresas é simples: a vantagem vem cada vez mais não só da escolha de uma LLM forte, mas da velocidade com que a equipe consegue conectar seus dados não estruturados, descrevê-los e transformá-los em um circuito gerenciado para fine-tuning repetível. Quanto menos emendas manuais entre armazenamento, catálogo e treinamento, mais rápido surgem modelos aplicados a processos específicos.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.