MIT Technology Review: por que os testes padrão de IA já não mostram a utilidade real
A MIT Technology Review afirma que os benchmarks de IA tradicionais medem o modelo no vácuo e, por isso, preveem mal o efeito no trabalho real. A reportagem cita o caso de sistemas médicos: nos testes eles parecem fortes, mas nos hospitais acrescentam atrasos por causa da revisão em equipe, dos padrões de relatório e das exigências regulatórias. A conclusão é simples: é preciso avaliar não uma única resposta do modelo, mas o comportamento dele dentro de processos e equipes.
Processado por IA de MIT Technology Review; editado por Hamidun News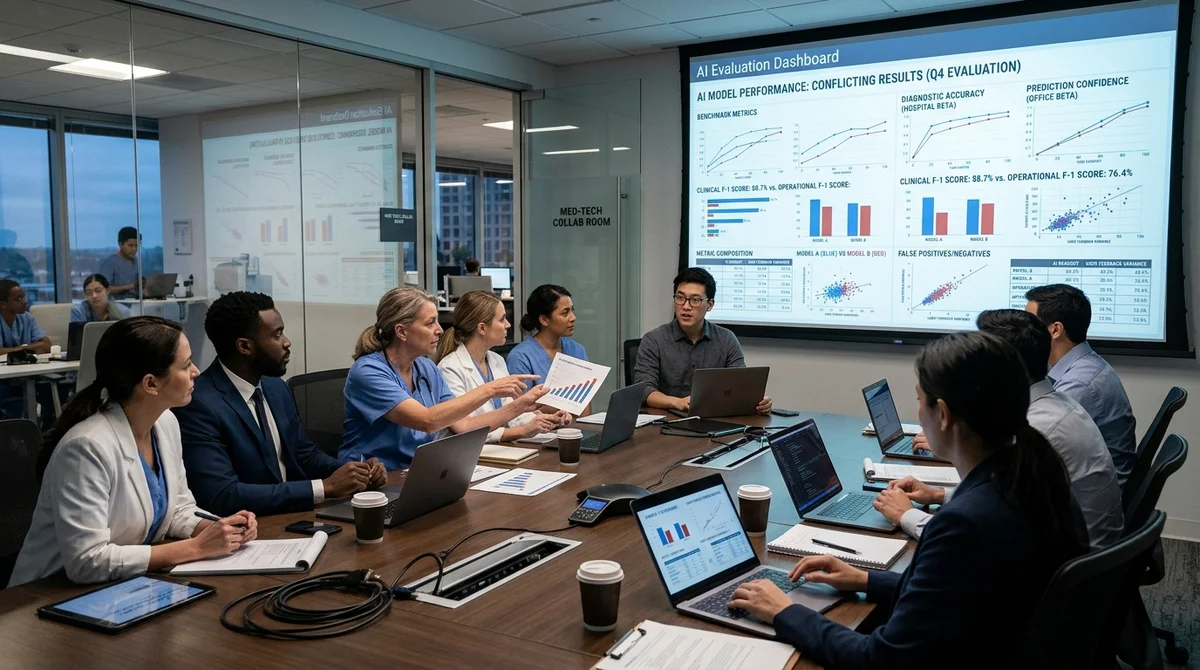
A MIT Technology Review escreve que os benchmarks de IA tradicionais mostram cada vez pior como os sistemas se comportam no trabalho real. Um modelo pode vencer um teste isolado e ainda assim atrasar uma equipe se for integrado a um processo vivo.
Por que os testes divergem
Por décadas, o progresso da IA foi medido como uma disputa de «máquina contra humano». A abordagem é conveniente: dar ao modelo xadrez, problemas de matemática, programação ou redações e depois comparar o resultado com o de uma pessoa. Esses testes são fáceis de padronizar, transformar em rankings e usar em marketing. Por isso, em torno dos benchmarks cresceu toda uma indústria de números de impacto, leaderboards e comparações que ficam ótimos em apresentações.
O problema é que a IA quase nunca é usada da forma como é testada. No trabalho real, um sistema não existe no vácuo: ele é integrado a equipes, processos, regras, prazos e padrões internos. Seu valor aparece não em uma única resposta, mas em uma série de interações ao longo de semanas e meses. Por isso, uma nota alta em uma tarefa isolada ainda não diz que o modelo vai acelerar o trabalho, reduzir erros ou sequer se mostrar útil para a organização.
Onde a avaliação falha
A reportagem traz um exemplo revelador da medicina. Há sistemas de análise de imagens que, nos testes, leem exames mais rápido e com mais precisão do que radiologistas experientes. No papel, parece a receita pronta para ganhar produtividade.
Mas, num hospital, a decisão raramente é tomada por um só especialista em um só momento. Em torno de um caso podem atuar radiologistas, oncologistas, físicos, enfermeiros e outros membros da equipe, e o plano de tratamento muda conforme chegam novos dados. Quando essas ferramentas entram no fluxo real, descobre-se que a equipe precisa de tempo extra para interpretar as respostas do modelo, confrontá-las com os padrões locais de relatório e verificar a conformidade com as exigências regulatórias.
Como resultado, um sistema que prometia aceleração no teste às vezes gera atrasos na prática. Além disso, pode reforçar a «ancoragem» precoce numa resposta plausível, porém incompleta, aumentar a carga cognitiva e propagar erros adiante na cadeia. Assim surge o «cemitério da IA»: produtos com notas altas que não se firmam no trabalho real.
O que se propõe no lugar
No lugar de testes estreitos, o autor propõe os benchmarks HAIC, sigla de Human-AI, Context-Specific Evaluation. É uma abordagem que avalia não só o modelo em si, mas também como ele se comporta dentro de uma equipe, de um processo e de um ambiente organizacional específicos. A ideia é aproximar a avaliação do uso real, e não de uma demonstração de laboratório.
- Deslocar o foco da tarefa individual para o trabalho da equipe e de todo o processo
- Medir o efeito não em uma única execução de teste, mas no longo prazo
- Considerar importantes não só velocidade e precisão, mas também coordenação, qualidade da decisão conjunta e visibilidade dos erros
- Olhar não só a resposta do modelo, mas as consequências antes e depois de sua aplicação
O autor descreve também exemplos iniciais dessa abordagem. Em um sistema hospitalar britânico, a pergunta não foi «o diagnóstico ficou mais preciso?», mas «a IA muda a qualidade da discussão coletiva e da interação entre os especialistas?». No setor humanitário, um sistema semelhante foi acompanhado por 18 meses, com monitoramento separado de quão facilmente as pessoas percebem e corrigem os erros do modelo. Um horizonte tão longo permite projetar mecanismos de proteção para um contexto específico, em vez de esperar que uma nota alta no teste garanta, por si só, segurança e utilidade.
O que isso significa
A indústria vai esbarrando aos poucos no limite das métricas antigas: elas mostram bem o que o modelo sabe fazer sozinho, mas mal o que acontece quando ele passa a fazer parte de uma organização viva. Para empresas e governos, é um sinal para olhar além dos leaderboards e perguntar se a IA ajuda as equipes a trabalhar de forma mais estável, rápida e segura em condições reais.
Perguntas frequentes sobre a notícia
Por que os testes divergem?
Por décadas, o progresso da IA foi medido como uma disputa de «máquina contra humano». A abordagem é conveniente: dar ao modelo xadrez, problemas de matemática, programação ou redações e depois comparar o resultado com o de uma pessoa. Esses testes são fáceis de padronizar, transformar em rankings e usar em marketing. Por isso, em torno dos benchmarks cresceu toda uma indústria de números de impacto, leaderboards e comparações que ficam ótimos em apresentações. O problema é que a IA quase nunca é usada da forma como é testada. No trabalho real, um sistema não existe no vácu
Onde a avaliação falha?
A reportagem traz um exemplo revelador da medicina. Há sistemas de análise de imagens que, nos testes, leem exames mais rápido e com mais precisão do que radiologistas experientes. No papel, parece a receita pronta para ganhar produtividade. Mas, num hospital, a decisão raramente é tomada por um só especialista em um só momento. Em torno de um caso podem atuar radiologistas, oncologistas, físicos, enfermeiros e outros membros da equipe, e o plano de tratamento muda conforme chegam novos dados. Quando essas ferramentas entram no fluxo real, descobre-se que a equipe precisa d
O que se propõe no lugar?
No lugar de testes estreitos, o autor propõe os benchmarks HAIC, sigla de Human-AI, Context-Specific Evaluation. É uma abordagem que avalia não só o modelo em si, mas também como ele se comporta dentro de uma equipe, de um processo e de um ambiente organizacional específicos. A ideia é aproximar a avaliação do uso real, e não de uma demonstração de laboratório. Deslocar o foco da tarefa individual para o trabalho da equipe e de todo o processo Medir o efeito não em uma única execução de teste, mas no longo prazo Considerar importantes não só velocidade e precisão, mas també
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.