AWS explica como escalar a memória de agentes de IA com padrões de namespace no AgentCore Memory
A AWS lançou um guia detalhado sobre como organizar a memória de agentes de IA no AgentCore Memory, componente do Bedrock que armazena contexto de longo prazo em sistemas escaláveis. O material descreve cinco padrões de namespace, de escopo por usuário a hierarquias multi-tenant, e três estratégias de recuperação de dados. O serviço se integra nativamente ao AWS IAM, o que permite controlar o acesso dos agentes à memória com as mesmas políticas usadas no restante da infraestrutura.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News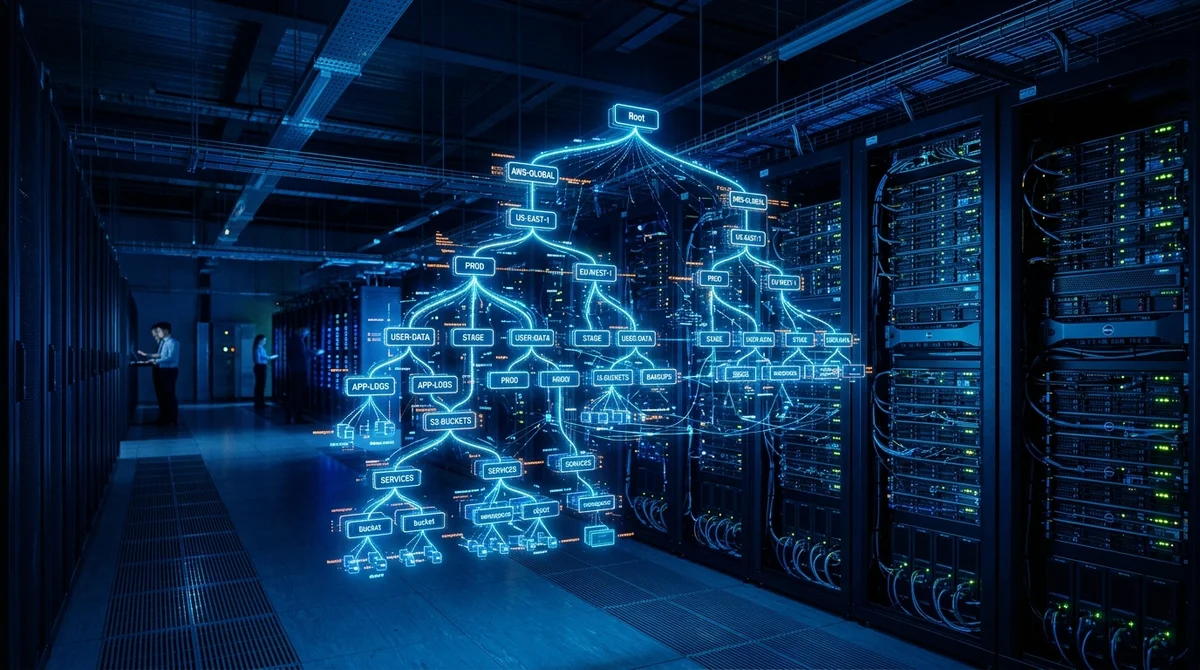
A AWS publicou um guia sobre como organizar a memória de agentes de IA no AgentCore Memory, serviço da plataforma Bedrock que permite armazenar e estruturar contexto de longo prazo em sistemas de agentes escaláveis.
O que é o AgentCore Memory
O AgentCore Memory é um dos componentes do AWS Bedrock AgentCore, que surgiu em 2025 como resposta às crescentes exigências de sistemas de agentes em nível de produção. O serviço resolve um problema concreto: em arquiteturas multiagente, não dá para simplesmente guardar o contexto em variáveis ou na sessão. Os dados precisam estar disponíveis entre requisições, agentes e usuários ao mesmo tempo.
A abstração central é o namespace (espaço de nomes), que define a quem pertence cada trecho de memória e quem pode lê-lo. Sem uma estrutura de namespace clara, os agentes passam a misturar o contexto de usuários diferentes ou perdem acesso aos dados de que precisam.
Padrões de hierarquia de namespace
A estrutura correta de namespace determina a velocidade e a precisão da recuperação de memória. A AWS descreve cinco padrões básicos:
- User-scoped: um namespace separado para cada usuário. Isolamento total, sem sobreposição entre contas.
- Session-scoped: a memória existe apenas dentro de uma sessão. Indicado para tarefas de curta duração que não exigem armazenamento de longo prazo.
- Project-scoped: vários agentes compartilham uma memória comum dentro de um projeto ou fluxo de trabalho.
- Tenant-scoped: para produtos SaaS, isolamento rígido entre clientes no nível da infraestrutura.
- Hierarchical mix: combinações em vários níveis, por exemplo `tenant/user/project`, para sistemas multi-tenant complexos.
Para a maioria dos sistemas em produção, a AWS recomenda uma abordagem hierárquica com dois ou três níveis: ela oferece flexibilidade sem complicar demais as consultas.
Padrões de recuperação de dados
Escolher a estratégia de recuperação é tão importante quanto a estrutura de armazenamento. A busca semântica vetorial não é a única opção. O AgentCore Memory aceita vários modos: consulta pontual por chave (rápida quando a estrutura de namespace foi bem planejada), busca semântica (para consultas vagas, como "o que o usuário disse sobre suas preferências") e um modo híbrido, em que primeiro a filtragem por namespace reduz o espaço de busca e depois a busca semântica atua dentro dele.
A abordagem híbrida é especialmente valiosa com grandes volumes de memória: a pré-filtragem reduz a latência e aumenta a precisão dos resultados.
Controle de acesso via IAM
A integração nativa com o AWS IAM é um dos principais argumentos a favor do AgentCore Memory em relação a soluções customizadas. O acesso aos namespaces é gerenciado pelas mesmas políticas e funções do restante da infraestrutura da AWS, sem um sistema de autorização separado para a memória dos agentes. Na prática, isso permite montar um modelo de acesso claro:
- O agente lê apenas o namespace do seu usuário, sem ver dados de terceiros
- O agente orquestrador recebe acesso de leitura e escrita a todos os namespaces do projeto
- A conta de serviço de CI/CD exclui namespaces temporários sem acesso aos dados dos usuários
- Os logs de auditoria do CloudTrail registram automaticamente cada acesso do agente à memória
Esse modelo é especialmente importante em setores regulados, como bancos, saúde e advocacia, onde o isolamento de dados entre clientes é uma exigência legal, e não uma recomendação.
O que isso significa
A AWS vem fechando de forma sistemática as lacunas de infraestrutura em sistemas de agentes em nível de produção. Os padrões de namespace e a integração com o IAM no AgentCore Memory atacam um dos problemas mais dolorosos das arquiteturas multiagente: quem pode ler o quê da memória compartilhada, e quando. As equipes ganham padrões prontos em vez de soluções customizadas, e os clientes corporativos recebem conformidade com requisitos de segurança já de fábrica.
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
- 30 de out. de 2026AWS dá a agentes de código uma prévia ao vivo do site direto da sessão isolada
- 30 de out. de 2026MoEngage abre 400 APIs privadas a agentes de IA via AgentCore Gateway, sem servidores MCP próprios
- 29 de out. de 2026NVIDIA Nemotron 3.5 Super VL: 120 bilhões de parâmetros, 12 bilhões ativos, com implantação na AWS
Perguntas frequentes sobre a notícia
O que é o AgentCore Memory?
O AgentCore Memory é um dos componentes do AWS Bedrock AgentCore, que surgiu em 2025 como resposta às crescentes exigências de sistemas de agentes em nível de produção. O serviço resolve um problema concreto: em arquiteturas multiagente, não dá para simplesmente guardar o contexto em variáveis ou na sessão. Os dados precisam estar disponíveis entre requisições, agentes e usuários ao mesmo tempo. A abstração central é o namespace (espaço de nomes), que define a quem pertence cada trecho de memória e quem pode lê-lo. Sem uma estrutura de namespace clara, os agentes passam a m
O que se sabe sobre Padrões de hierarquia de namespace?
A estrutura correta de namespace determina a velocidade e a precisão da recuperação de memória. A AWS descreve cinco padrões básicos: User-scoped: um namespace separado para cada usuário. Isolamento total, sem sobreposição entre contas. Session-scoped: a memória existe apenas dentro de uma sessão. Indicado para tarefas de curta duração que não exigem armazenamento de longo prazo. Project-scoped: vários agentes compartilham uma memória comum dentro de um projeto ou fluxo de trabalho. Tenant-scoped: para produtos SaaS, isolamento rígido entre clientes no nível da infraestrutu
O que se sabe sobre Padrões de recuperação de dados?
Escolher a estratégia de recuperação é tão importante quanto a estrutura de armazenamento. A busca semântica vetorial não é a única opção. O AgentCore Memory aceita vários modos: consulta pontual por chave (rápida quando a estrutura de namespace foi bem planejada), busca semântica (para consultas vagas, como "o que o usuário disse sobre suas preferências") e um modo híbrido, em que primeiro a filtragem por namespace reduz o espaço de busca e depois a busca semântica atua dentro dele. A abordagem híbrida é especialmente valiosa com grandes volumes de memória: a pré-filtragem
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.