MarkTechPost detalha o ciclo completo de treinamento de grandes modelos de linguagem, dos dados ao deploy
Um LLM moderno não é um único grande treinamento, mas um longo pipeline: pré-treinamento, SFT, LoRA/QLoRA, RLHF, otimização de raciocínio e deploy. A análise da MarkTechPost mostra que as capacidades básicas do modelo nascem na etapa com dados brutos, enquanto a utilidade real vem depois, quando ele é ajustado a uma tarefa, alinhado às expectativas humanas e preparado para operar sob carga. A principal conclusão é que a qualidade de um LLM vem de uma cadeia de decisões ao longo de todo o percurso, e não de uma única etapa secreta.
Processado por IA de MarkTechPost; editado por Hamidun News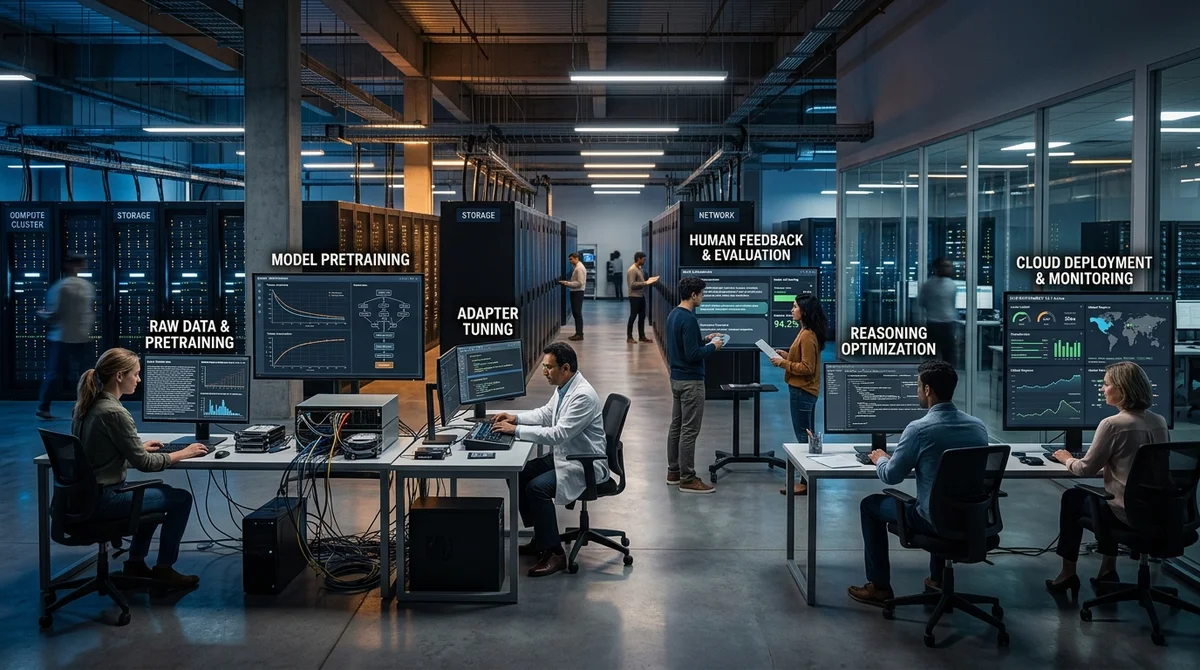
Um grande modelo de linguagem não nasce em uma única passada pelos dados: é uma longa cadeia de engenharia em que um erro em qualquer etapa afeta a qualidade, a segurança e o custo de operação. A análise técnica da MarkTechPost descreve o percurso completo de um LLM moderno, do pré-treinamento ao deploy em produção, e mostra por que dois modelos de tamanho parecido podem se comportar de maneiras totalmente diferentes. A diferença não vem só da arquitetura, mas da qualidade de todo o pipeline: dados, ajuste de comportamento, alinhamento e infraestrutura.
A primeira etapa é o pré-treinamento. Nela, o modelo recebe enormes volumes de dados brutos: livros, sites, documentação, código e outros corpora de texto. Ele não é ensinado a uma tarefa de negócio específica; em vez disso, assimila padrões gerais da linguagem, relações entre conceitos, a estrutura da argumentação e padrões básicos de raciocínio. Os objetivos típicos são a previsão do próximo token ou o preenchimento de lacunas. Na prática, o pré-treinamento transforma uma rede neural inicializada aleatoriamente em um sistema capaz de continuar um texto com sentido e manter o contexto. Se essa base é fraca, nenhuma melhoria posterior produz um resultado realmente forte.
Em seguida vem o ajuste fino supervisionado, ou SFT. O modelo deixa de receber uma massa bruta de texto e passa a ser treinado com pares rotulados de «entrada-saída». Isso permite adaptá-lo a instruções específicas, ao estilo de resposta, ao tom de comunicação e às regras de um setor.
A diferença aparece bem em um exemplo simples: um modelo base pode responder à reclamação de um usuário de forma seca e curta, e depois do SFT dar uma resposta estruturada, educada e útil, com passos claros. É nesta etapa que se incorporam ao modelo a expertise de domínio, os requisitos da empresa e o formato de comunicação desejado. Ou seja, o pré-treinamento responde à pergunta sobre o que o modelo sabe fazer, e o SFT, sobre como exatamente ele deve se comportar em um cenário aplicado.
Mas o retreinamento completo de modelos grandes custa caro demais, então na prática se usam métodos de adaptação econômicos. A MarkTechPost destaca LoRA e QLoRA. No LoRA, os pesos base do modelo ficam congelados e o treinamento ocorre apenas por meio de pequenas matrizes de baixo ranking inseridas em certas camadas.
Isso reduz de forma drástica o número de parâmetros treináveis, o uso de memória e o tempo de treinamento. O QLoRA vai além: combina a mesma abordagem com a quantização do modelo base, por exemplo para 4 bits, o que permite adaptar até modelos muito grandes sem exigências excessivas de infraestrutura. O sentido prático é simples: a empresa não precisa mais fazer um retreinamento completo a cada nova tarefa.
Pode pegar uma base forte e ajustá-la a um custo relativamente baixo para advogados, suporte, analistas ou um assistente interno.
Depois entra o alinhamento. Mesmo que o modelo saiba muito e siga bem as instruções, ele ainda pode responder de forma muito ríspida, insegura ou simplesmente diferente do que o usuário espera. Para isso se aplica o RLHF, aprendizado por reforço com feedback humano. Pessoas comparam várias respostas do modelo e as ordenam, com base nisso treina-se um modelo de recompensa, e então o próprio LLM é otimizado para gerar com mais frequência as variantes preferidas.
O texto menciona ainda o GRPO, uma abordagem mais recente voltada a melhorar o raciocínio e as soluções em várias etapas. O modelo gera várias respostas para uma mesma consulta, e o treinamento se baseia não em uma nota absoluta de cada resposta, mas na comparação dentro do grupo. Esse mecanismo é especialmente útil quando importa não só a resposta final, mas a qualidade do raciocínio: matemática, problemas lógicos, explicações passo a passo.
A etapa final é o deploy, e é aqui que o modelo de pesquisa vira produto. Em produção, o que importa não é mais a loss nem a qualidade do dataset por si sós, mas latência, custo de inferência, vazão, uso de GPU e estabilidade sob carga real. Por isso os modelos são otimizados ainda mais: quantizados, executados em engines de inferência especializadas como vLLM, TensorRT-LLM ou SGLang, encapsulados em uma API e hospedados na nuvem ou em ambiente self-hosted, quando controle sobre os dados e a economia importam.
Por cima disso se constrói a observabilidade: monitoramento de latência, vazão e consumo de memória, além de escalonamento automático. Sem isso, até um modelo forte logo vira um serviço caro e instável.
A principal conclusão da análise da MarkTechPost é que a qualidade de um LLM não é definida por uma etapa «secreta», mas pelo conjunto de decisões ao longo de todo o percurso. O pré-treinamento entrega a inteligência bruta, o SFT torna o modelo útil para uma tarefa específica, LoRA e QLoRA barateiam a adaptação, RLHF e GRPO lapidam o comportamento e a lógica, e o deploy decide se todo o sistema consegue funcionar ao vivo, com rapidez e previsibilidade. Para o mercado, é um sinal importante: a concorrência entre produtos de IA se desloca cada vez mais do tamanho do modelo em si para a qualidade da estrutura de engenharia ao redor dele.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.