NetKet e JAX: como montar um modelo Transformer para sistemas de spin frustrados
Saiu um guia prático que mostra como unir a arquitetura Transformer à física quântica com NetKet e JAX. O material constrói um Neural Quantum State para a cadeia de Heisenberg J1-J2, treina o modelo com Variational Monte Carlo e confere o resultado com a diagonalização exata. É um modelo útil para quem quer sair dos exemplos de brinquedo e partir para a modelagem em nível de pesquisa.
Processado por IA de MarkTechPost; editado por Hamidun News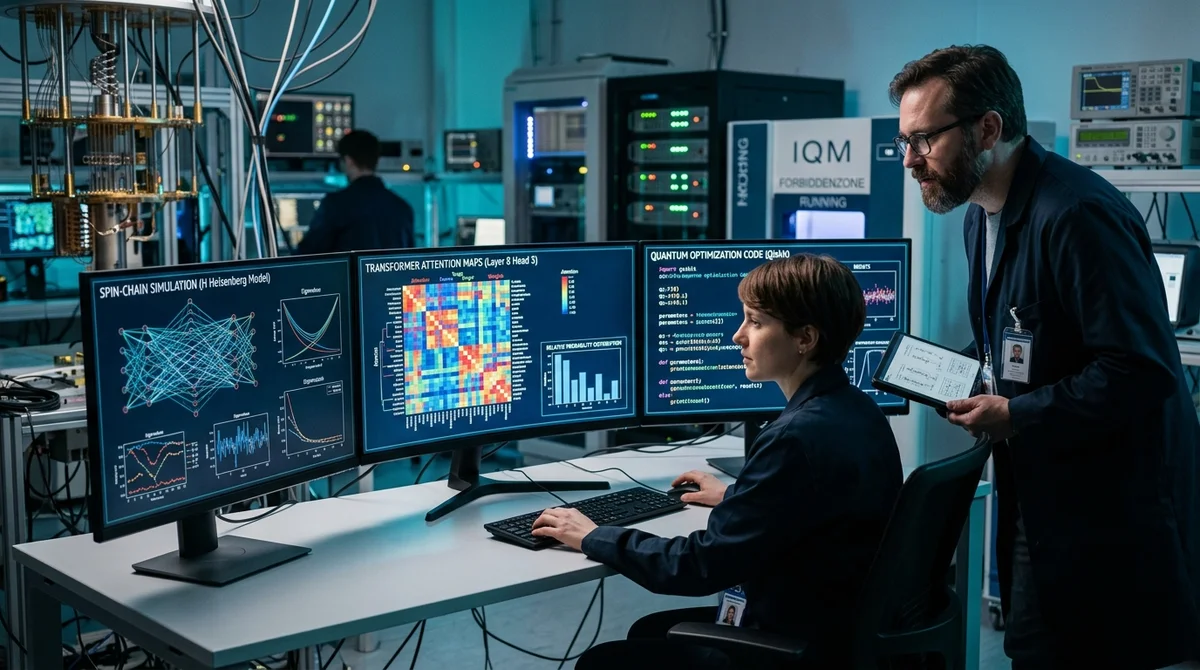
As arquiteturas Transformer começam a ganhar espaço também na física quântica computacional. Um novo guia prático mostra como usar NetKet e JAX para montar um pipeline completo de Neural Quantum States para um problema difícil: a cadeia de spins de Heisenberg J1-J2 frustrada. Não é teoria no vácuo, mas um esquema reproduzível em que modelo, sampler, otimização e verificação de precisão formam um único circuito de pesquisa.
A ideia central do guia é que a arquitetura Transformer se adapta bem à descrição de estados quânticos de muitos corpos, nos quais importam as correlações de longo alcance entre partículas. Os métodos numéricos tradicionais esbarram rapidamente na dimensão do espaço de estados, sobretudo quando o sistema é frustrado, ou seja, quando interações concorrentes o impedem de chegar a um mínimo de energia simples e ordenado. Nesse cenário, os Neural Quantum States permitem representar a função de onda como uma rede neural parametrizável e depois otimizá-la com Variational Monte Carlo. O NetKet funciona como ambiente pronto para cálculos quânticos, e o JAX como motor de otimização acelerada e de alta precisão.
O guia começa configurando a parte física básica do problema. O autor define uma cadeia unidimensional de comprimento L com condições de contorno periódicas, em que os vizinhos mais próximos interagem com o coeficiente J1 e os seguintes com J2. Essa combinação cria a frustração que torna o problema interessante e nada trivial. Para descrever o sistema, usam-se um grafo do NetKet, um espaço de Hilbert de spins 1/2 com projeção total fixa e um operador hamiltoniano montado com GraphOperator. Em paralelo, ativa-se a precisão de 64 bits do JAX, importante para cálculos estáveis em problemas desse tipo.
Em seguida vem o aprendizado de máquina propriamente dito. A função de onda é definida por um modelo próprio, TransformerLogPsi, em Flax: as configurações de spin são codificadas como tokens, recebem embeddings e representações posicionais e passam por vários blocos de self-attention e camadas feed-forward. O exemplo usa dimensão oculta de 96, quatro cabeças de atenção e seis camadas de transformer.
Na saída, o modelo devolve o logaritmo complexo da amplitude da função de onda. Isso é crítico, porque um estado quântico não pode ser descrito de forma adequada apenas por um escalar real. Depois de agregar a informação de toda a cadeia por média, a rede obtém uma representação global da configuração e consegue expressar correlações mais complexas que os ansätze locais.
Outro mérito do guia é que ele não para na definição do modelo. Para o treinamento, o autor monta um circuito VMC completo: o sampler MetropolisExchange, o estado variacional MCState, o otimizador Adam e a Stochastic Reconfiguration, análoga ao natural gradient descent para estados quânticos. A configuração do exemplo usa 4096 amostras, descarta os estados iniciais das cadeias e roda cerca de 250 iterações de otimização. Essa pilha serve não só para obter energia baixa, mas também para controlar a convergência. O código guarda as trajetórias da energia média e da variância, para mostrar com que estabilidade o modelo avança rumo a uma boa solução.
Depois do treinamento, o pipeline passa a ser usado como ferramenta de pesquisa. O autor roda cálculos para vários valores de J2, de 0 a 0,7, em uma cadeia de 24 sítios, registra as energias finais e estima o pico do fator de estrutura. Assim, não se trata apenas de ajustar os parâmetros da rede: dá para ver como o comportamento físico do sistema muda com o aumento da frustração e onde podem surgir transições entre diferentes fases de ordem magnética.
Como verificação adicional, a qualidade do modelo é comparada com a diagonalização exata em um sistema menor, de 14 sítios, pelo método de Lanczos. A comparação das energias dá uma referência numérica clara de quão perto o transformer variacional chega da solução exata onde o cálculo exato ainda é possível.
O valor prático do material está em fechar a lacuna entre dois mundos: as arquiteturas modernas de deep learning e os problemas reais da física computacional. Para engenheiros de ML, é um bom exemplo de uso do transformer fora de texto, imagens e dados tabulares padrão. Para físicos, é um modelo claro para sair da ideia abstrata de Neural Quantum States e chegar a um experimento reproduzível, com métricas, benchmarks e observáveis concretos. E para quem trabalha na interseção dessas áreas, o guia oferece uma base que pode ser ampliada: partir para redes maiores, adicionar simetrias, estudar emaranhamento ou montar simulações temporais mais complexas.
O que isso significa: a abordagem Transformer vai se tornando uma ferramenta de trabalho não só para tarefas clássicas de IA, mas também para modelar sistemas quânticos, nos quais o custo do erro é alto e os métodos exatos se esgotam rápido. Se NetKet e JAX já fazem parte do seu stack, este material oferece um ponto de partida quase pronto para experimentos em nível de pesquisa.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.