AWS apresenta guia prático para ajustar o Amazon Nova com o Nova Forge SDK
A AWS publicou a segunda parte da série sobre o Nova Forge SDK e mostrou um cenário aplicado de fine-tuning do Amazon Nova. O guia aborda a preparação dos dados, a mistura deles durante o treinamento e a avaliação de qualidade que vem depois. Na prática, é um playbook pronto para equipes que querem adaptar o modelo ao seu domínio sem montar o processo do zero.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News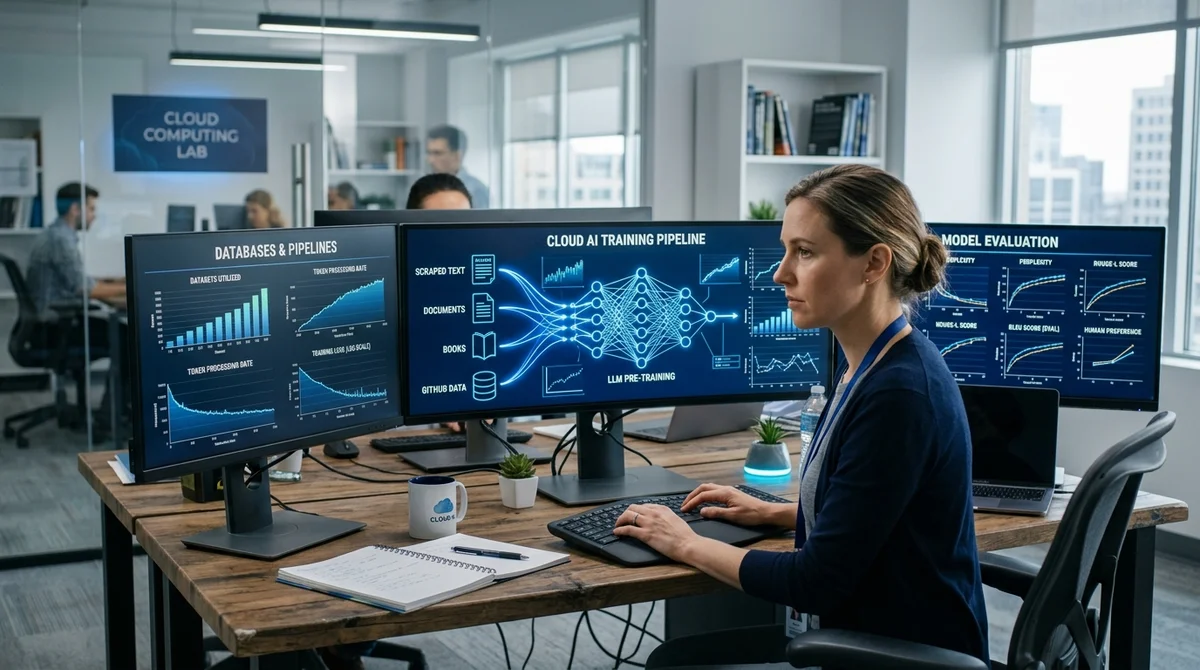
A AWS publicou a segunda parte da série sobre o Nova Forge SDK. Desta vez, saiu da visão geral para uma instrução prática: como fazer o fine-tuning de um modelo Amazon Nova com dados próprios, usar a mistura de datasets e, depois, verificar se o ajuste trouxe um efeito real. O material não parece uma apresentação de recursos, e sim um roteiro de trabalho que uma equipe pode repetir quase passo a passo.
O centro do guia é o ciclo completo de ajuste do modelo. A AWS descreve o caminho da preparação do corpus até o início do treinamento e a avaliação dos resultados. Isso importa porque muitas equipes não travam por ter ou não um modelo, mas pelo processo: como deixar os dados no formato certo, com o que complementar os exemplos internos, como não perder as capacidades básicas do modelo após a especialização e com quais critérios decidir se o ajuste compensou.
Nessa lógica, o Nova Forge SDK é apresentado como uma ferramenta que ajuda a padronizar o experimento e torná-lo repetível. Em vez de ações dispersas (um script para os dados, uma configuração de treinamento separada, uma checagem manual de qualidade separada), a empresa propõe reunir tudo em uma sequência clara de passos.
Há ênfase especial em data mixing, a mistura de conjuntos de dados durante o fine-tuning. Para equipes práticas, esse é um dos temas centrais: se o modelo for treinado apenas com um conjunto corporativo restrito, ele pode responder melhor naquele domínio específico, mas ao mesmo tempo perder utilidade geral, estilo ou robustez nas respostas. A inclusão de diferentes tipos de exemplos costuma ser usada para manter o equilíbrio entre especialização e qualidade do modelo base. No contexto do Amazon Nova, isso significa poder adaptar o sistema com mais precisão ao seu cenário, como documentação interna, suporte, classificação ou geração de textos, sem transformar o ajuste em uma caixa-preta.
Pela descrição do material, a AWS foca justamente o lado prático: não só explicar o conceito, mas mostrar como trabalhar com as proporções dos dados e como encaixar essa etapa no pipeline geral de treinamento.
A avaliação do resultado após o fine-tuning também tem um espaço próprio no guia. É uma etapa tão importante quanto o treinamento: sem uma verificação clara, é fácil acabar com um processo bem configurado que, na prática, não melhora as respostas do modelo em produção. Por isso, o valor do guia está não só nas instruções de execução, mas na tentativa de ligar preparação de dados, treinamento e avaliação em uma única cadeia. Para equipes de produto, isso é especialmente útil, porque a decisão de adotar um modelo ajustado normalmente não vem de sensação, mas da qualidade em tarefas reais: precisão, estabilidade, aderência ao estilo e redução de erros nos cenários-alvo.
Outro ponto forte do material é a reprodutibilidade. A AWS o posiciona explicitamente como playbook, ou seja, um esquema repetível que pode ser adaptado ao seu caso. Isso ajuda equipes de ML e de produto que querem mais do que «testar fine-tuning» e pretendem montar um pipeline claro de experimentos: preparar a amostra, definir as proporções de mistura, treinar o modelo, checar a qualidade, registrar as conclusões e partir para a próxima iteração. No fundo, trata-se de tirar o ajuste fino do campo dos experimentos manuais isolados e levá-lo a um processo mais disciplinado, em que é mais fácil comparar resultados entre versões e decidir com base em dados, não em intuição.
Vale notar também que esta já é a segunda parte da série sobre o Nova Forge SDK. A primeira tratou do lançamento de experimentos de customização, e o novo material continua o tema e desce a um nível mais prático. O formato favorece a AWS: a empresa não se limita a anunciar os modelos Amazon Nova, mas vai construindo documentação aplicada para quem realmente os leva a produtos. Para o mercado, também é um sinal revelador: a concorrência não gira mais só em torno do tamanho do contexto, da velocidade ou da qualidade em benchmarks, mas também da praticidade das ferramentas que encurtam o caminho entre um modelo base e uma solução ajustada a um domínio.
A conclusão principal é simples: a AWS aposta não só nos modelos Amazon Nova em si, mas em um processo gerenciado para ajustá-los. Se a série sobre o Nova Forge SDK mantiver esse nível de detalhe, pode se tornar uma referência útil para equipes que não precisam de uma stack de IA abstrata, e sim de instruções claras para transformar um modelo geral em uma ferramenta de trabalho para uma tarefa específica.
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
- 30 de out. de 2026AWS dá a agentes de código uma prévia ao vivo do site direto da sessão isolada
- 30 de out. de 2026MoEngage abre 400 APIs privadas a agentes de IA via AgentCore Gateway, sem servidores MCP próprios
- 29 de out. de 2026NVIDIA Nemotron 3.5 Super VL: 120 bilhões de parâmetros, 12 bilhões ativos, com implantação na AWS
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.