Google monta cadeia de suprimentos de chips com quatro parceiros para disputar com a Nvidia a inferência de IA
O Google está montando uma cadeia de suprimentos de chips de IA com quatro parceiros para desafiar a Nvidia em inferência. As parceiras são Broadcom, MediaTek, Marvell e Intel. O roadmap inclui o Ironwood TPU, já entregue aos milhões, e os chips TPU v8 no processo de 2 nm da TSMC, previstos para o fim de 2027.
Processado por IA de TNW; editado por Hamidun News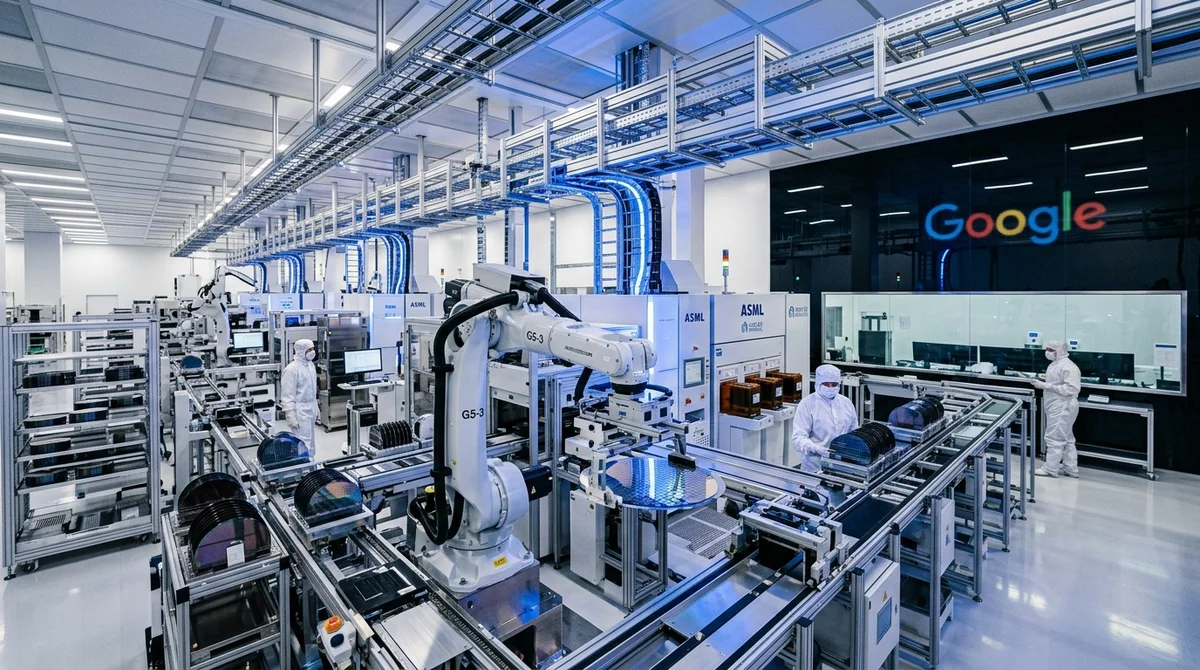
O Google anunciou a cadeia de suprimentos de chips personalizados mais diversificada da indústria de IA, com quatro parceiras de design e um roadmap que vai até o fim de 2027. A empresa aposta em reduzir a dependência do mercado de nuvem em relação à Nvidia no segmento de inferência de IA.
A rede de parceiras do Google tem quatro grandes players: Broadcom, MediaTek, Marvell e Intel. Cada uma cuida de uma área distinta da arquitetura e da fabricação dos chips. A estratégia foi detalhada às vésperas do Google Cloud Next, o principal evento anual da empresa para clientes corporativos e parceiros.
O primeiro produto desse ecossistema é o Ironwood TPU, chip de nova geração que já é entregue na casa dos milhões de unidades. É o primeiro sinal de que o Google deixa de ser apenas consumidor de hardware alheio e se torna, de forma planejada, um player autossuficiente no mercado de infraestrutura de IA.
O ponto final do roadmap são os chips TPU v8, que serão fabricados no processo de 2 nm da TSMC e chegarão na segunda metade de 2027. A estratégia do Google divide as próximas gerações de TPU em vários fluxos independentes, por parceira de design e capacidade de produção. Essa abordagem protege contra interrupções de fornecimento típicas da dependência de um único fornecedor e dá flexibilidade para escalar o desempenho conforme as diferentes tarefas de inferência.
Inferência, ou seja, a execução de modelos já treinados para gerar respostas aos usuários, tornou-se o principal campo de batalha do mercado de chips de IA em 2025–2026. É ali que se concentra a maior parte da demanda dos grandes provedores de nuvem: o modelo é treinado uma vez, enquanto a inferência roda continuamente.
A Nvidia mantém o domínio graças à arquitetura de GPU e ao maduro ecossistema CUDA, mas os TPUs personalizados do Google tradicionalmente mostram melhor eficiência energética em tarefas com modelos transformer.
Para o mercado, isso significa mais concorrência em hardware de IA na nuvem. Se o Google conseguir escalar a própria cadeia até os volumes necessários, seus clientes terão uma alternativa real aos clusters de GPU da Nvidia, com custo de inferência por token potencialmente menor e menos dependência de um único fornecedor.
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.