Amazon SageMaker e DVC: rastreabilidade de ponta a ponta de modelos de ML dos dados à previsão
A AWS publicou um guia de rastreabilidade de ponta a ponta de modelos de ML com DVC, Amazon SageMaker AI e MLflow Apps. O material aborda dois padrões: lineage no nível do dataset e no nível do registro individual. Ambos são implantados na sua conta AWS por meio de notebooks prontos.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News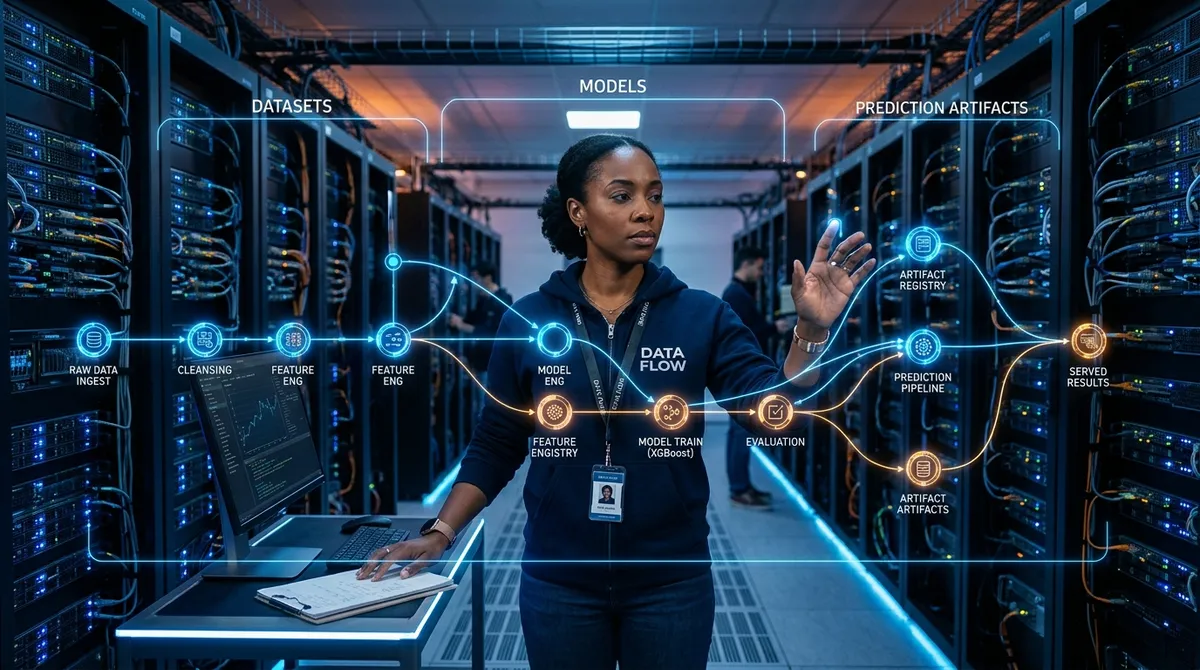
O AWS Machine Learning Blog publicou um guia detalhado sobre como construir rastreamento end-to-end de modelos ML — desde dados brutos até a previsão final — usando três ferramentas: DVC, Amazon SageMaker AI e Amazon SageMaker AI MLflow Apps. O problema que o material aborda é bem conhecido por equipes trabalhando em produção: é pouco claro exatamente quais dados foram usados para treinar um modelo específico, quais transformações foram aplicadas a eles e como um registro individual influenciou a previsão. Isso é crítico durante auditorias, depuração de data drift e conformidade com requisitos regulatórios.
DVC (Data Version Control) é uma ferramenta open-source que adiciona versionamento de arquivos grandes e datasets ao Git. Em combinação com SageMaker, permite capturar o snapshot exato dos dados usados em cada execução de treinamento. SageMaker MLflow Apps, por sua vez, armazena métricas, parâmetros e artefatos de experimentos — um servidor MLflow padrão gerenciado pela AWS sem necessidade de implantar infraestrutura manualmente.
Os autores descrevem dois padrões concretos. O primeiro é linhagem em nível de dataset: a versão do dataset é registrada (via tag DVC), parâmetros do pipeline de processamento e um link para o modelo treinado no MLflow. O segundo é linhagem em nível de registro: cada registro específico do conjunto de treinamento é vinculado ao modelo, o que permite responder a pergunta "quais exatamente exemplos moldaram essa previsão".
Ambos os padrões são implementados como notebooks Jupyter prontos para executar em sua conta AWS. A arquitetura funciona da seguinte forma: dados são armazenados em S3 e versionados por DVC, metadados de experimentos (parâmetros, métricas, artefatos) — no MLflow App, e a conexão entre versão de dados e versão de modelo é fornecida através de tags personalizados e artefatos DVC registrados no MLflow. O valor prático da abordagem está na reprodutibilidade.
Se em seis meses descobrir que o modelo se comporta inesperadamente em uma certa coorte de usuários, os engenheiros poderão recuperar com precisão em qual dataset foi treinado, quais registros incluiu e com quais hiperparâmetros o treinamento foi lançado. O material é direcionado para engenheiros ML e equipes MLOps já trabalhando no ecossistema AWS. Notebooks prontos reduzem significativamente a barreira de entrada: não há necessidade de projetar a integração do zero — é suficiente adaptar os exemplos ao seu dataset e pipeline de processamento.
Para empresas onde a auditabilidade de sistemas ML é importante — especialmente no setor financeiro, medicina e projetos governamentais — tal abordagem se torna um padrão de facto. A AWS está construindo consistentemente um toolkit em que linhagem deixa de ser uma "boa prática" opcional e se torna uma propriedade incorporada do pipeline.
- 29 de out. de 2026NVIDIA Nemotron 3.5 Super VL: 120 bilhões de parâmetros, 12 bilhões ativos, com implantação na AWS
- 29 de out. de 2026Cloudflare lança modelos open source Clef: 98,5% no BFCL e 38,8 ms
- 29 de out. de 2026Anthropic mostra no S-1: 11 900 clientes pagam a partir de $100 mil por ano
- 28 de out. de 2026Keystone tira o nome do modelo do código: gateway de LLM open source adiciona 0,64 ms
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.