Google ensina IA a prever enchentes a partir de velhas reportagens de jornal
O Google usa reportagens antigas e um LLM para prever enchentes repentinas. Textos de arquivo são convertidos em dados numéricos, o que resolve a escassez de medições hidrológicas em países em desenvolvimento. O modelo já está sendo testado em regiões sem sensores nem estações meteorológicas.
Processado por IA de TechCrunch; editado por Hamidun News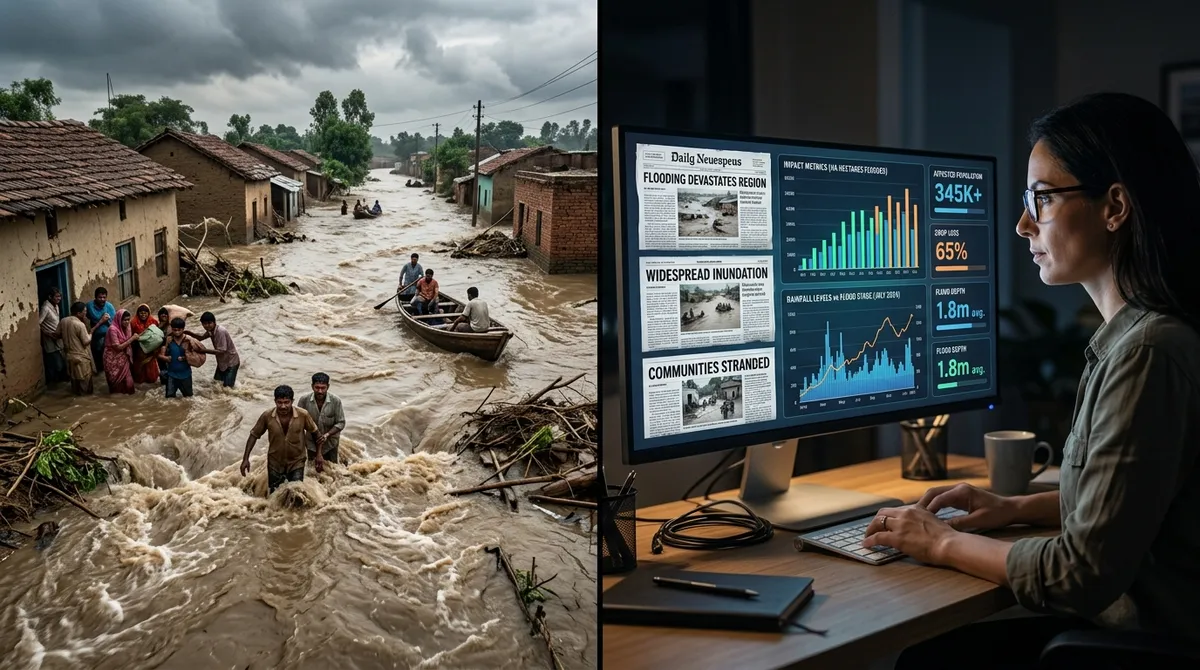
O Google desenvolveu uma abordagem fora do convencional para prever enchentes repentinas: em vez de uma infraestrutura cara de sensores, a empresa usa reportagens de arquivo como fonte de dados históricos. Um modelo de linguagem converte descrições textuais qualitativas de desastres naturais em indicadores quantitativos adequados para treinar modelos hidrológicos.
O problema que esse método resolve é bem conhecido dos climatologistas. Modelos precisos de previsão de cheias exigem séries de vários anos sobre nível da água, chuvas e relevo. Mas na maioria dos países em desenvolvimento, onde as enchentes são mais letais, essa infraestrutura simplesmente não existe. Sensores custam dinheiro e exigem manutenção e eletricidade, recursos que faltam em regiões vulneráveis.
Ainda assim, existem registros históricos de enchentes: em arquivos de jornais, reportagens de veículos locais e boletins governamentais. O problema é que esses dados são qualitativos: "uma forte cheia inundou três vilarejos" não é um número com o qual um modelo tradicional consiga trabalhar.
O Google propôs usar um LLM como tradutor: o modelo lê o texto histórico e extrai estimativas numéricas estruturadas da escala, da duração e da geografia do evento. As séries numéricas sintéticas resultantes são então usadas para treinar um modelo de previsão de enchentes. Na prática, o jornalismo de arquivo passa a substituir décadas de medições instrumentais.
É uma forma fundamentalmente nova de lidar com a escassez de dados em problemas climáticos, e potencialmente aplicável muito além da hidrologia.
O Google já testa o sistema em regiões da África e do Sul da Ásia, onde praticamente não há alertas de cheias. A empresa desenvolve o Flood Hub desde 2023 e hoje cobre mais de 80 países. O novo método deve ampliar a cobertura para territórios que antes ficavam fora da previsão por falta de dados numéricos históricos.
É um exemplo revelador de como os LLMs mudam a própria estrutura dos dados científicos. Antes, a fronteira entre "há dados" e "não há dados" era definida pela presença de equipamentos de medição. Agora, os modelos de linguagem permitem empurrar essa fronteira, pois conseguem extrair informação quantitativa oculta de textos escritos sem qualquer finalidade científica.
- 2 de nov. de 2026Agente de LLM montou um redutor no KOMPAS-3D, mas tirou 50 em 100 na lista de materiais
- 2 de nov. de 2026Karpathy montou em duas horas, com o Claude Code, o catálogo HackerTube com 6 454 vídeos
- 2 de nov. de 2026Я устроил допрос 6 нейросетям про себя и своё ИП глазами заказчика: как ИИ выдумал мне бизнес на Amazon в США и слил смету из закрытого КП
- 2 de nov. de 2026NVIDIA lança Nemotron 3.5 Bolt E4B com 4 GB e 133 tokens por segundo na RTX 5070
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.