PostgreSQL no OpenAI: como dimensionar o BD para ChatGPT
Quando o ChatGPT disparou para o topo, a equipe da OpenAI enfrentou um desafio sério: como garantir a operação estável e rápida do banco de dados que está na base de tudo – o PostgreSQL. Isso envolveu suportar centenas de milhões de usuários e processar milhões de requisições por segundo. Resolver essa tarefa exigiu não apenas adicionar mais hardware, mas um repensamento profundo da arquitetura e a aplicação de toda uma série de truques de engenharia. PostgreSQL, apesar de sua maturidade e confiabilidade, não foi originalmente projetado para cargas tão extremas. Os métodos tradicionais de escalabilidade, como o dimensionamento vertical (aumentar a potência de um único servidor), rapidamente atingiram um limite. Ficou claro que era necessária uma abordagem horizontal – distribuir a carga entre múltiplos servidores.
Processado por IA de OpenAI Blog; editado por Hamidun News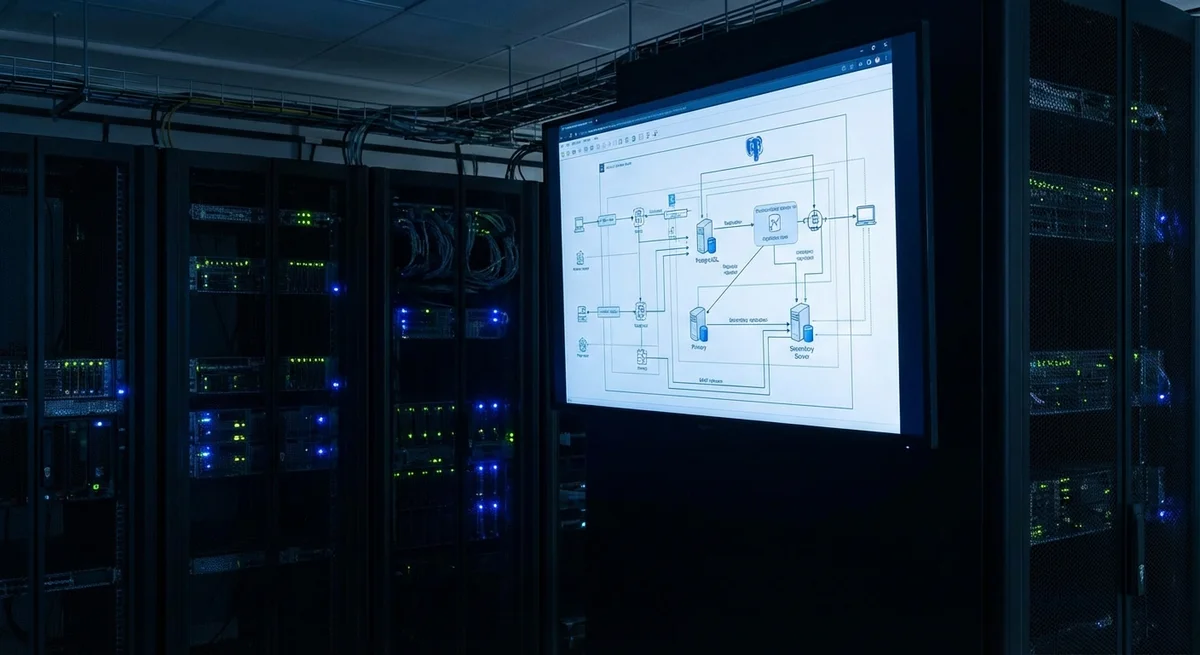
Quando o ChatGPT disparou para o topo, a equipe da OpenAI enfrentou um desafio sério: como garantir a operação estável e rápida do banco de dados que está na base de tudo – o PostgreSQL. Isso envolveu suportar centenas de milhões de usuários e processar milhões de requisições por segundo. Resolver essa tarefa exigiu não apenas adicionar mais hardware, mas um repensamento profundo da arquitetura e a aplicação de toda uma série de truques de engenharia.
PostgreSQL, apesar de sua maturidade e confiabilidade, não foi originalmente projetado para cargas tão extremas. Os métodos tradicionais de escalabilidade, como o dimensionamento vertical (aumentar a potência de um único servidor), rapidamente atingiram um limite. Ficou claro que era necessária uma abordagem horizontal – distribuir a carga entre múltiplos servidores. A OpenAI escolheu o caminho da replicação, criando múltiplas cópias de apenas leitura do banco de dados. Isso possibilitou reduzir significativamente a carga no servidor principal e aumentar a taxa de transferência geral.
No entanto, a replicação é apenas parte da solução. Para otimização adicional, foi usado o cache – armazenar os dados solicitados com mais frequência na memória RAM, o que possibilitou evitar acessar o banco de dados a cada requisição. Além disso, foi implementado um sistema de limitação de taxa (rate limiting), que evitava sobrecarga do sistema a partir de picos repentinos de tráfego. Por fim, o isolamento de cargas de trabalho desempenhou um papel importante – dividir diferentes tipos de requisições em diferentes servidores para evitar conflitos e garantir prioridade para as operações mais importantes.
A aplicação desses métodos permitiu que a OpenAI não apenas lidasse com a carga atual, mas também criasse uma arquitetura escalável pronta para crescimento futuro. Este é um precedente importante para toda a indústria, demonstrando que até tecnologias maduras, como o PostgreSQL, podem ser usadas com sucesso para suportar as aplicações de IA mais exigentes. A experiência da OpenAI mostra quão importante é uma abordagem abrangente, combinando replicação, cache, limitação de taxa e isolamento de cargas de trabalho.
As implicações dessa experiência se estendem muito além da OpenAI. Outras empresas que trabalham com grandes dados e altas cargas podem usar esses desenvolvimentos para otimizar seus próprios sistemas. Em particular, isso é relevante para plataformas de comércio eletrônico, redes sociais e outros serviços que exigem acesso instantâneo a grandes volumes de informações. Além disso, essa experiência pode estimular o desenvolvimento futuro do PostgreSQL e de outros bancos de dados, visando melhorar a escalabilidade e o desempenho.
Em conclusão, o sucesso da OpenAI no dimensionamento do PostgreSQL não é apenas uma conquista técnica, mas uma lição importante para toda a indústria. Isso mostra que a abordagem correta para arquitetura e otimização pode permitir que até mesmo tecnologias maduras lidem com as tarefas mais complexas. Isso abre novas oportunidades para o desenvolvimento de IA e outras áreas que exigem o processamento de grandes volumes de dados.
- 30 de out. de 2026Claude Enterprise ganha relatórios inteligentes: quem usa IA, como usa e quanto isso custa
- 29 de out. de 2026TokenRouter acelera o roteamento token a token entre modelos em até 64 vezes
- 29 de out. de 2026Google abre o Android Studio a agentes de IA de terceiros: Claude, Codex e mais de 40 outros
- 29 de out. de 2026Claude Code edita vídeo a partir da transcrição: como funciona o video-use, com 30 000 estrelas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.