Gemini 4 Argon ensina humanoide Apollo 2 a jogar cornhole: 7 acertos seguidos
A Google DeepMind divulgou um teste interno do Gemini 4 Argon. O modelo assistiu a um vídeo de uma pessoa jogando cornhole, montou uma cena virtual no MuJoCo, calculou a física e o controle de corpo inteiro e entregou o resultado ao humanoide Apollo 2, da Apptronik. No mundo real, o robô acertou o alvo com os saquinhos sete vezes seguidas. Segundo a DeepMind, o pipeline Video-to-Sim-to-Real reduz semanas de modelagem manual a algumas horas. O teste é interno, e ainda não há verificação independente nem estatísticas das tentativas. • Entrada: um único vídeo de uma pessoa; saída: uma política funcional para o humanoide. • Resultado: 7 acertos seguidos no robô real. • Ganho declarado: de semanas para algumas horas.
Processado por IA de YouTube: Google DeepMind; editado por Hamidun News
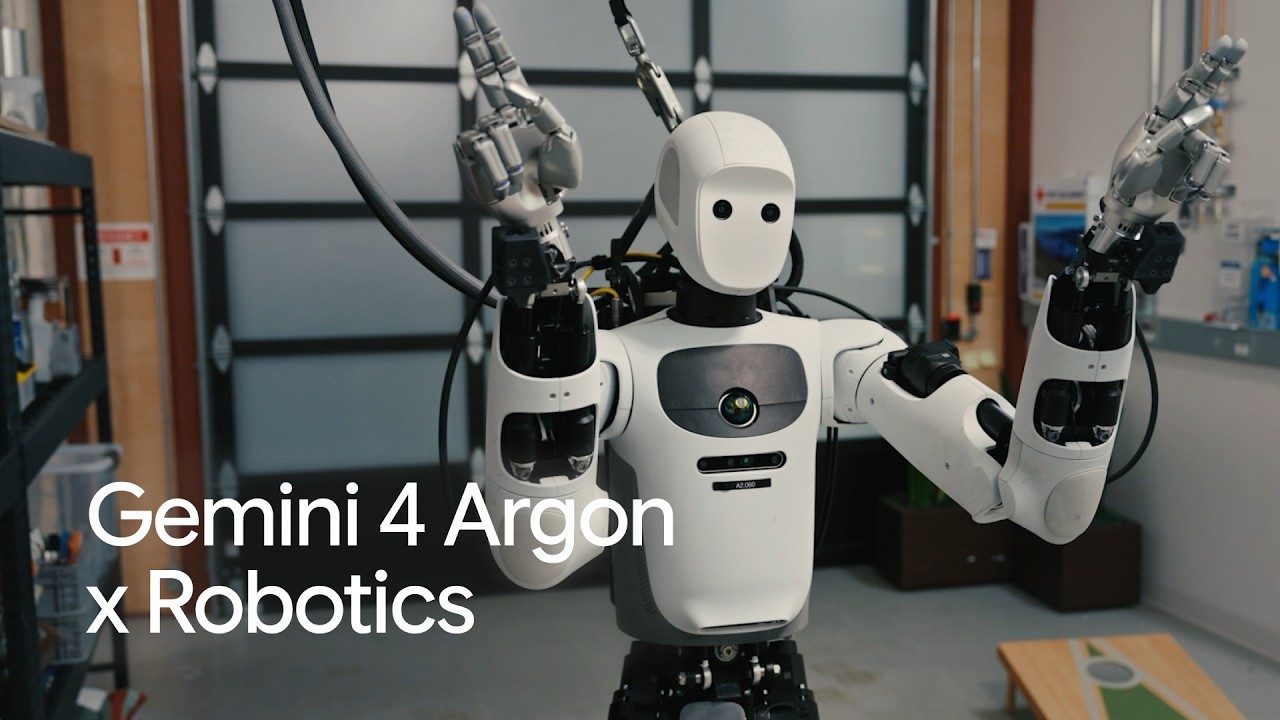
A Google DeepMind apresentou um teste interno do Gemini 4 Argon em robótica. O modelo assistiu a um vídeo de uma pessoa jogando cornhole e preparou o controle para o humanoide Apollo 2, da Apptronik. No mundo real, o robô acertou o alvo com os saquinhos sete vezes seguidas. Segundo a DeepMind, o pipeline Video-to-Sim-to-Real reduz semanas de modelagem manual a algumas horas.
Do vídeo à simulação e ao piso real
O cornhole parece simples: é preciso lançar um saquinho de grãos no buraco de uma prancha inclinada. Para um humanoide, porém, é um conjunto de várias tarefas ao mesmo tempo. O robô precisa agarrar o saquinho, transferir o peso do corpo, escolher a trajetória e soltar o objeto no momento exato. Um erro em qualquer etapa faz o arremesso errar o alvo.
De acordo com a descrição da DeepMind, a cadeia funciona assim. Os pesquisadores fornecem ao Gemini 4 Argon um vídeo com o jogador. O modelo usa sua capacidade de compreensão de vídeo e raciocínio avançado para construir uma cena virtual no motor de física MuJoCo. Em seguida, calcula a física do arremesso e os parâmetros de controle de todo o corpo. A solução pronta é transferida para o Apollo 2 no mundo real.
O elemento-chave aqui não é o arremesso em si, mas a etapa intermediária. Antes, uma equipe de engenheiros montava essa simulação manualmente: medições, modelagem dos objetos, ajuste dos parâmetros de contato. A DeepMind afirma que agora isso leva algumas horas.
O que se sabe em números
- Modelo: Gemini 4 Argon.
- Robô: humanoide Apollo 2, fabricado pela Apptronik.
- Simulador: MuJoCo.
- Dados de entrada: vídeo de uma pessoa jogando cornhole.
- Resultado no mundo real: sete acertos seguidos.
- Economia de tempo declarada: de semanas de modelagem manual para algumas horas.
- Formato do teste: interno, conduzido por pesquisadores da DeepMind.
O que ficou fora do vídeo
A descrição do vídeo deixa muitas perguntas em aberto. A DeepMind não informa a distância até a prancha nem o tamanho do alvo. Não se sabe quantas tentativas antecederam a série de sete arremessos, nem se houve participação humana na calibração. Também não foi revelado o que exatamente o modelo produz: código do controlador, trajetórias ou parâmetros de política. E não está claro como foi resolvida a lacuna entre simulação e realidade, o principal problema da abordagem sim-to-real.
Uma série de sete acertos fica bem no vídeo, mas não substitui estatísticas. Para uma avaliação séria, seriam necessários a taxa de sucesso em uma amostra longa, a variação conforme as condições e o comportamento diante de troca de saquinho ou de iluminação. Ainda não há verificação independente.
Mesmo assim, a direção é clara. Hoje, o principal gargalo da IA física está nos dados e nos ambientes de treinamento. A teleoperação é cara, e a montagem manual de simulações é lenta. Se um modelo de linguagem com compreensão de vídeo realmente constrói uma cena física funcional a partir de um vídeo comum, qualquer vídeo na internet se torna um potencial ambiente de treinamento. A pergunta deixa de ser "onde conseguir dados" e passa a ser "com que precisão o modelo reconstrói a física".
O que as equipes devem fazer
Equipes de robótica devem analisar o próprio ciclo de desenvolvimento e ver onde o tempo é gasto: na coleta de dados, na modelagem da cena ou na transferência para o mundo real. Se o maior custo está na modelagem, vale testar a abordagem "vídeo → simulação" nas próprias tarefas. O MuJoCo é aberto, e a reconstrução de cenas a partir de vídeo já pode ser testada com modelos multimodais disponíveis, sem esperar por acesso de parceiros ao Gemini 4 Argon.
Esses sistemas devem ser avaliados pela repetibilidade em uma longa série de execuções, e não pela melhor tentativa. Quem acompanha o mercado de humanoides deve observar dois pontos: se DeepMind e Apptronik vão publicar métricas e se o pipeline será aberto a desenvolvedores externos. Por enquanto, é uma demonstração forte, mas não um produto.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.