Google DeepMind lança o DiffusionGemma, um LLM de difusão 4 vezes mais rápido que o Gemma 4
O Google DeepMind anunciou o DiffusionGemma, um modelo de linguagem de nova classe que usa difusão em vez de autorregressão. Ele roda 4 vezes mais rápido que os demais modelos da família Gemma 4. Demis Hassabis parabenizou pessoalmente a equipe e chamou o desenvolvimento de "fulminante", um sinal para toda a indústria.
Processado por IA de @demishassabis; editado por Hamidun News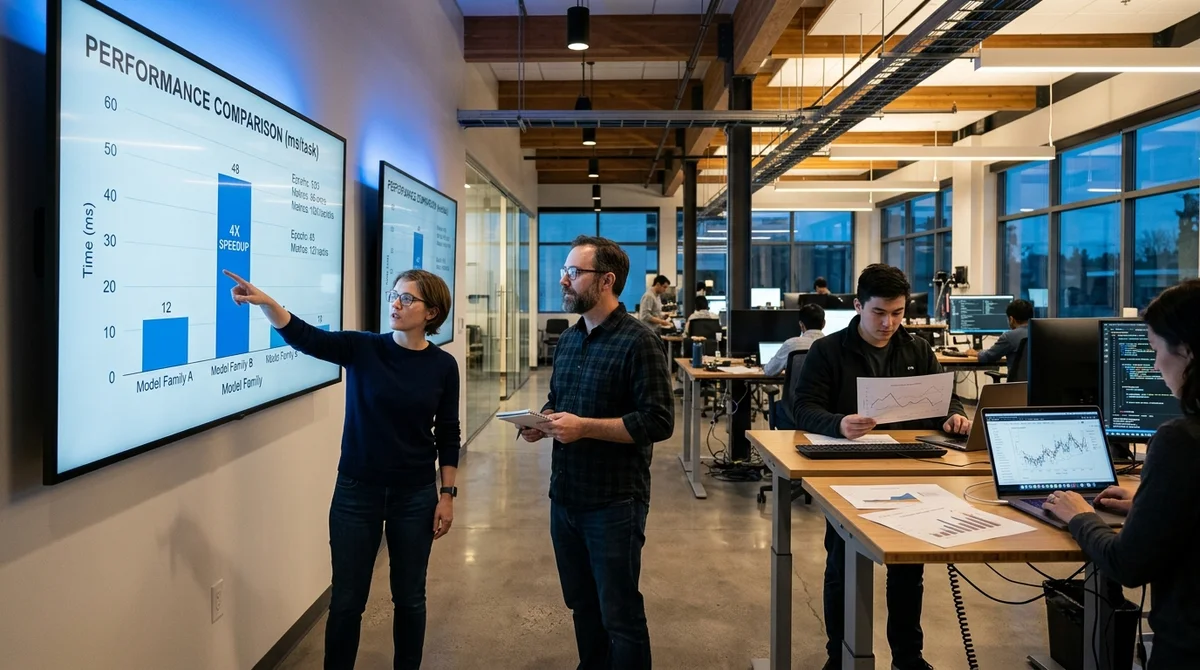
O Google DeepMind apresentou o DiffusionGemma, um modelo de linguagem de nova classe que gera texto por difusão, e não pela abordagem autorregressiva padrão. Segundo a equipe, o modelo roda 4 vezes mais rápido que qualquer outro da família Gemma 4, com qualidade comparável.
Como funciona um LLM de difusão
Os modelos de linguagem clássicos, como GPT, Llama e Gemma, geram texto de forma sequencial: token por token, da esquerda para a direita. Para obter 500 tokens, são necessários 500 passos de inferência sequenciais. É uma limitação fundamental da arquitetura: cada token depende de todos os anteriores, então o paralelismo é impossível pela própria natureza da autorregressão.
A abordagem de difusão funciona de outro jeito. A mesma ideia por trás do Stable Diffusion e do DALL-E para imagens agora é aplicada ao texto: o modelo aprende a reconstruir o texto original a partir de ruído aleatório, refinando toda a sequência de uma vez. Ele não avança da esquerda para a direita, mas de forma iterativa, em paralelo em todas as posições ao mesmo tempo.
- Autorregressão: 500 tokens exigem 500 passos sequenciais
- Difusão: 500 tokens são processados em 10–50 passos, independentemente do tamanho
- O ganho de velocidade não é linear: quanto mais longo o texto, mais evidente a vantagem
Várias equipes tentam dominar a difusão para geração de texto desde 2021. O principal problema era a qualidade: os modelos de texto por difusão ficaram muito tempo atrás dos autorregressivos, e os textos perdiam coerência e precisão de formulação. A julgar pela declaração de Hassabis, o DiffusionGemma superou essa barreira.
Demis Hassabis anunciou pessoalmente
O próprio CEO do Google DeepMind anunciou o resultado, o que é incomum. Executivos desse nível costumam promover produtos inteiros ou direções estratégicas, mas raramente destacam uma decisão arquitetônica específica como motivo de parabenização. Hassabis parabenizou pessoalmente o pesquisador Brian O'Donoghue e toda a equipe, chamando o desenvolvimento de "fulminante".
"Ótima inovação em difusão de texto.
O DiffusionGemma é fulminante: 4 vezes mais rápido que outros modelos Gemma 4. Mal posso esperar para ver o que as pessoas vão construir com ele!" — Demis Hassabis
Contexto importante: a comparação não é com benchmarks ultrapassados, mas com a família Gemma 4 atual, que já é considerada uma das mais eficientes entre os modelos abertos da sua classe. Um ganho de quatro vezes sobre essa base é um resultado arquitetônico expressivo.
A economia da inferência está mudando
A velocidade de geração determina tanto o custo da API quanto a latência do produto final. Se o DiffusionGemma gera 4 vezes mais rápido com qualidade comparável, isso abre várias possibilidades práticas:
- Menor custo de inferência: menos tempo de GPU por resposta
- Contextos longos sem crescimento exponencial dos atrasos
- Competitividade em cenários sensíveis à latência: chatbots, autocompletar, pipelines agênticos
- Potencial de unificação com a geração de imagens e áudio por difusão
A sinergia multimodal é especialmente interessante: ao combinar a difusão de texto com as abordagens já maduras para imagem e som, surge uma arquitetura única que processa todas as modalidades com um só princípio. O Google já caminha nessa direção com a série Gemini, e o DiffusionGemma parece o primeiro passo rumo a uma multimodalidade por difusão completa.
O que isso significa
Os LLMs de difusão deixaram de ser um experimento acadêmico. Quando o CEO de um dos maiores laboratórios de IA do mundo anuncia pessoalmente um avanço arquitetônico, o mercado reage. Se os números de velocidade do DiffusionGemma forem confirmados em testes independentes, eles podem mudar a precificação do mercado de inferência de LLMs e forçar os concorrentes a acelerar seus próprios projetos de difusão. Para os desenvolvedores que ainda não estudaram essa arquitetura, a hora é agora.
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
Perguntas frequentes sobre a notícia
Como funciona um LLM de difusão?
Os modelos de linguagem clássicos, como GPT, Llama e Gemma, geram texto de forma sequencial: token por token, da esquerda para a direita. Para obter 500 tokens, são necessários 500 passos de inferência sequenciais. É uma limitação fundamental da arquitetura: cada token depende de todos os anteriores, então o paralelismo é impossível pela própria natureza da autorregressão. A abordagem de difusão funciona de outro jeito. A mesma ideia por trás do Stable Diffusion e do DALL-E para imagens agora é aplicada ao texto: o modelo aprende a reconstruir o texto original a partir de r
O que se sabe sobre Demis Hassabis anunciou pessoalmente?
O próprio CEO do Google DeepMind anunciou o resultado, o que é incomum. Executivos desse nível costumam promover produtos inteiros ou direções estratégicas, mas raramente destacam uma decisão arquitetônica específica como motivo de parabenização. Hassabis parabenizou pessoalmente o pesquisador Brian O'Donoghue e toda a equipe, chamando o desenvolvimento de "fulminante". "Ótima inovação em difusão de texto. O DiffusionGemma é fulminante: 4 vezes mais rápido que outros modelos Gemma 4. Mal posso esperar para ver o que as pessoas vão construir com ele!" — Demis Hassabis Contex
O que se sabe sobre A economia da inferência está mudando?
A velocidade de geração determina tanto o custo da API quanto a latência do produto final. Se o DiffusionGemma gera 4 vezes mais rápido com qualidade comparável, isso abre várias possibilidades práticas: Menor custo de inferência: menos tempo de GPU por resposta Contextos longos sem crescimento exponencial dos atrasos Competitividade em cenários sensíveis à latência: chatbots, autocompletar, pipelines agênticos Potencial de unificação com a geração de imagens e áudio por difusão A sinergia multimodal é especialmente interessante: ao combinar a difusão de texto com as aborda
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.