LangChain: como a engenharia de loops agênticos torna os agentes de IA confiáveis
Um agente de IA confiável exige mais do que um bom modelo. A LangChain publicou uma análise da "engenharia de loops": como projetar o agent loop para que o agente funcione de forma estável em tarefas reais. A chave está nas camadas. Os loops internos resolvem subtarefas específicas, enquanto os externos cuidam da orquestração. As primitivas da LangChain ajudam a instrumentar cada nível e a descobrir onde o agente falha.
Processado por IA de LangChain Blog; editado por Hamidun News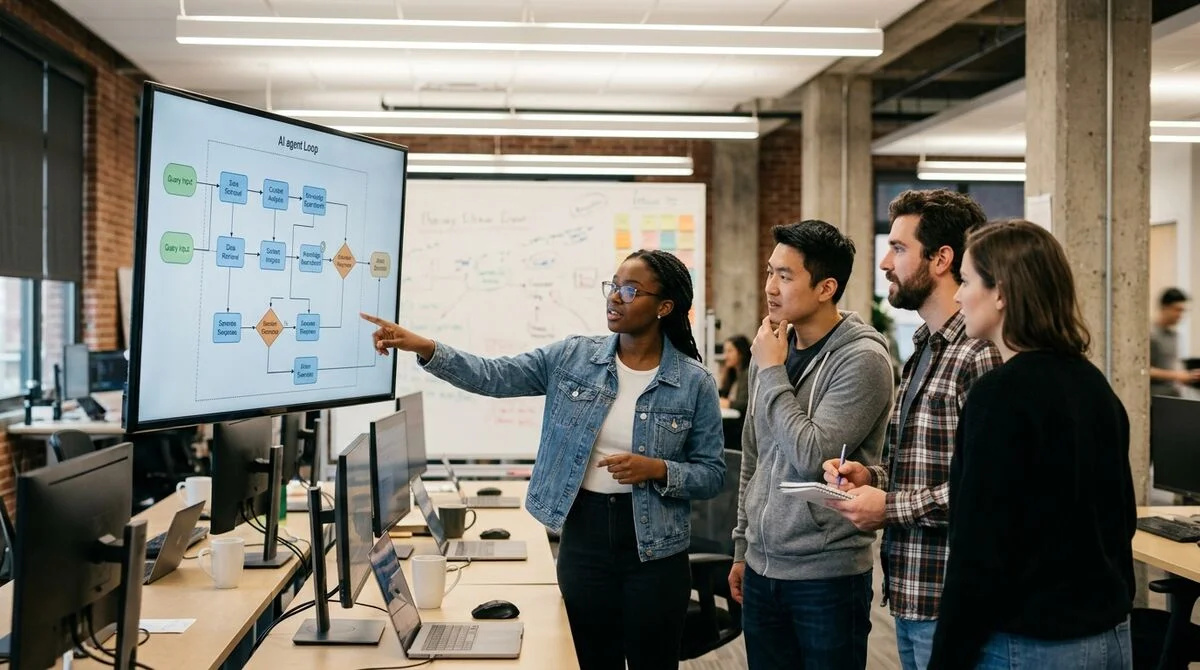
A LangChain publicou uma análise de uma das decisões arquiteturais centrais na criação de agentes de IA: como projetar corretamente o "loop agêntico" e por que a confiabilidade em produção depende disso, e não da escolha do modelo.
Por que o modelo não basta
A maioria dos desenvolvedores enfrenta o mesmo problema: o agente funciona bem na demo, mas quebra em tarefas reais. A LangChain afirma que raramente o problema está no modelo em si. O problema é a falta de um harness (arnês) bem pensado, que envolva o modelo e controle o fluxo de execução.
Um agente não é apenas uma chamada a um LLM com ferramentas. É um processo iterativo controlado: observa o estado, escolhe uma ação, recebe o resultado, atualiza o estado e repete. A confiabilidade depende de quão cuidadosamente esse loop é projetado.
Anatomia do agent loop
O loop básico tem quatro etapas, repetidas até a conclusão da tarefa:
- Observação — o agente recebe o contexto atual: a tarefa, o histórico e os resultados das ferramentas anteriores
- Raciocínio — o LLM decide o que fazer em seguida: chamar uma ferramenta, pedir esclarecimento ou encerrar
- Ação — uma chamada de ferramenta ou a resposta final
- Atualização — o resultado é gravado no estado e o loop continua
A ideia central: cada nível precisa ter suas próprias ferramentas de observação. Sem logs em cada etapa, é impossível entender onde exatamente o agente erra.
Empilhando e ampliando loops
Agentes complexos usam loops aninhados com diferentes horizontes de decisão. O loop externo gerencia a tarefa geral: divide em subtarefas, acompanha o progresso e decide quando terminar. Os loops internos resolvem subtarefas específicas, como busca, escrita de código e verificação.
A LangChain identifica vários padrões de ampliação. Reflection loops: o agente revisa a própria saída antes de entregá-la ao usuário. Validation loops: um loop separado verifica os resultados, por exemplo rodando testes no código gerado. Escalation loops: se o agente não consegue resolver a tarefa em N passos, passa o controle a uma pessoa.
Cada camada aumenta a confiabilidade, mas também a latência. O trabalho do engenheiro é equilibrar rigor e velocidade.
Primitivas da LangChain para instrumentação
O LangGraph permite descrever loops agênticos como um grafo de estados (StateGraph), em que cada nó é uma etapa do loop e as arestas são as transições entre elas. Isso traz três vantagens práticas.
Primeiro, transparência: cada transição é registrada e qualquer falha pode ser reproduzida. Segundo, controle: é possível adicionar "pontos de interrupção" em que uma pessoa revisa a decisão do agente antes de prosseguir. Terceiro, testabilidade: cada nó pode ser testado isoladamente, sem executar o agente inteiro.
O LangSmith resolve a observabilidade em produção. Sem ele, é difícil saber em que etapa o agente se degrada ao escalar.
O que isso significa
A indústria está saindo do "chame o GPT-4 com ferramentas" para uma engenharia completa de sistemas de agentes. As equipes que investem agora na arquitetura de loops e na observabilidade terão agentes que funcionam em produção, e não só em demos.
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
- 1 de nov. de 2026Novo teste detecta conluio oculto entre agentes de IA pela reação do parceiro a uma paráfrase
- 1 de nov. de 2026Universidade de Illinois reúne 12 151 problemas abertos e testa se a IA consegue resolvê-los
- 31 de out. de 2026Engenheiro de IA escreve uma só função de recompensa para equipes de agentes: taxa de vitória sobe de 51% para 90%
Perguntas frequentes sobre a notícia
Por que o modelo não basta?
A maioria dos desenvolvedores enfrenta o mesmo problema: o agente funciona bem na demo, mas quebra em tarefas reais. A LangChain afirma que raramente o problema está no modelo em si. O problema é a falta de um harness (arnês) bem pensado, que envolva o modelo e controle o fluxo de execução. Um agente não é apenas uma chamada a um LLM com ferramentas. É um processo iterativo controlado: observa o estado, escolhe uma ação, recebe o resultado, atualiza o estado e repete. A confiabilidade depende de quão cuidadosamente esse loop é projetado.
O que se sabe sobre Anatomia do agent loop?
O loop básico tem quatro etapas, repetidas até a conclusão da tarefa: Observação — o agente recebe o contexto atual: a tarefa, o histórico e os resultados das ferramentas anteriores Raciocínio — o LLM decide o que fazer em seguida: chamar uma ferramenta, pedir esclarecimento ou encerrar Ação — uma chamada de ferramenta ou a resposta final Atualização — o resultado é gravado no estado e o loop continua A ideia central: cada nível precisa ter suas próprias ferramentas de observação. Sem logs em cada etapa, é impossível entender onde exatamente o agente erra.
O que se sabe sobre Empilhando e ampliando loops?
Agentes complexos usam loops aninhados com diferentes horizontes de decisão. O loop externo gerencia a tarefa geral: divide em subtarefas, acompanha o progresso e decide quando terminar. Os loops internos resolvem subtarefas específicas, como busca, escrita de código e verificação. A LangChain identifica vários padrões de ampliação. Reflection loops: o agente revisa a própria saída antes de entregá-la ao usuário. Validation loops: um loop separado verifica os resultados, por exemplo rodando testes no código gerado. Escalation loops: se o agente não consegue resolver a taref
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.