Como incorporar o conhecimento e o julgamento da sua equipe ao ciclo de melhoria de agentes de IA — LangChain
Agentes de IA funcionam melhor quando refletem o conhecimento e o julgamento da sua equipe. Parte desse conhecimento está documentada: regulamentos, checklists, bancos de dados. Mas a maioria das organizações também depende de uma experiência tácita que existe apenas na cabeça das pessoas. A LangChain explica como incorporar essa experiência ao ciclo de melhoria dos agentes e por que é justamente aí que a maioria dos projetos trava.
Processado por IA de LangChain Blog; editado por Hamidun News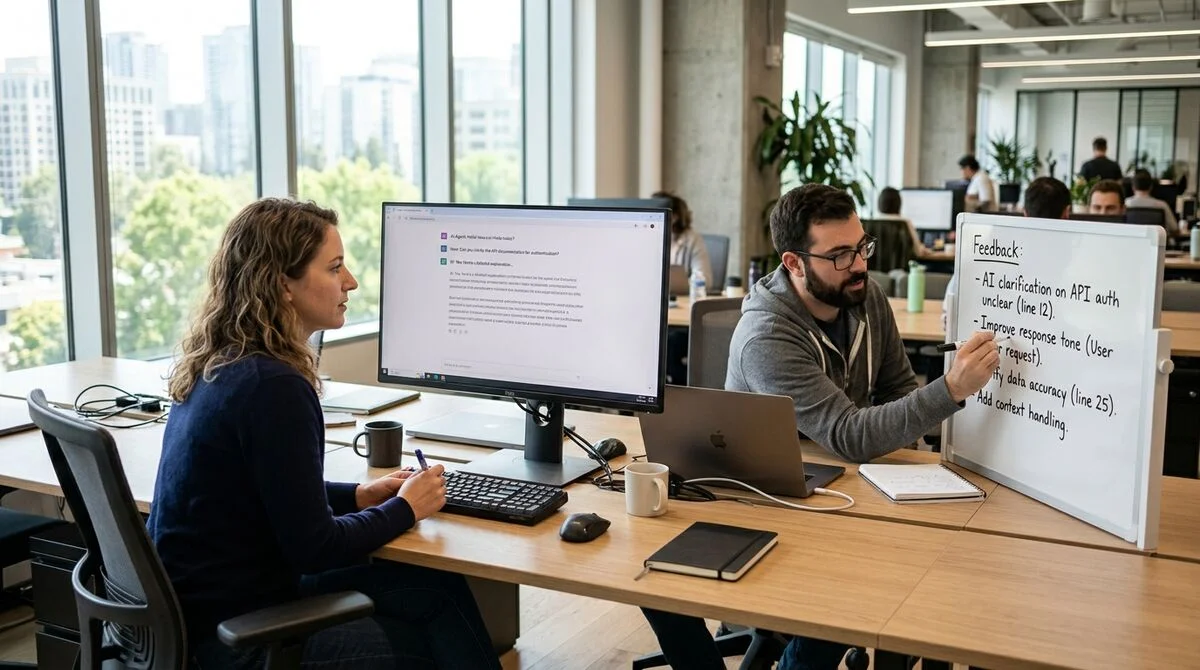
Agentes de IA funcionam melhor quando refletem o conhecimento e o julgamento reais da sua equipe. Parte disso está documentada e disponível de imediato. Mas a maioria das organizações também depende de uma experiência tácita que existe exclusivamente na cabeça das pessoas — e é justamente aí que a maioria dos agentes de IA emperra.
Dois tipos de conhecimento em uma organização
Toda empresa tem dois tipos fundamentalmente diferentes de expertise corporativa.
Conhecimento institucional é o que está documentado: regulamentos, checklists, bases de conhecimento, SOPs. Ele se automatiza bem. Basta adicionar os documentos ao contexto do agente ou montar um sistema de RAG, e o agente encontra o procedimento certo e o aplica. As empresas costumam resolver essa parte rapidamente.
Conhecimento tácito é outra história. É aquilo que um funcionário experiente sabe, mas nunca formulou em voz alta. A intuição de um gerente de vendas que, pelo tom de um e-mail, sente que o cliente está perto de desistir. A decisão de um engenheiro de pular uma etapa formal de verificação porque o contexto torna isso óbvio. A habilidade de um diretor de relacionamento com clientes de escolher exatamente as palavras que esta situação exige, e não uma parecida. Nada disso está escrito em lugar nenhum. Vive na cabeça das pessoas, e as melhores equipes se sustentam nisso.
Por que os agentes travam sem esse conhecimento
É no conhecimento tácito que a maioria dos agentes de IA tropeça. O agente segue as regras formais, mas não entende quando e por que deve se afastar delas. Ele age como um funcionário novo sem mentor: tecnicamente correto, mas sem nuances e sem faro.
Sintomas típicos dessa lacuna:
- Respostas formalmente corretas, mas inadequadas no contexto específico
- Incapacidade de lidar com situações fora do padrão que um funcionário experiente resolve na hora
- Perda de orientação quando não há uma regra inequívoca
- Desconsideração do contexto de um cliente ou de uma solicitação específica
Nenhuma dessas falhas é um bug do modelo nem uma questão de tamanho. Elas vêm da falta de um conhecimento que só as pessoas da sua equipe têm.
Como incorporar o julgamento ao ciclo de melhoria
A solução não é adicionar mais um documento ao RAG nem reescrever o prompt de sistema. É transformar as pessoas em fonte de feedback, e não apenas em operadores que aprovam cada passo. O objetivo é converter gradualmente o conhecimento tácito em conhecimento explícito que o agente possa usar.
Na prática, é um ciclo de três etapas:
- Monitoramento: registrar todas as sessões do agente e destacar os casos em que ele errou ou entregou um resultado abaixo do ideal
- Anotação: pedir a especialistas da equipe que analisem os casos problemáticos e expliquem o que estava certo e por quê, não de forma formal, mas do ponto de vista do julgamento real
- Atualização: usar esses dados para fazer o ajuste fino do modelo, corrigir prompts ou adicionar novas instruções
Ferramentas como o LangSmith permitem reunir essas etapas em um único processo: registro de sessões, identificação de casos problemáticos, coleta de feedback da equipe e acompanhamento do progresso, tudo em um só lugar.
A principal diferença em relação a auditorias pontuais é a continuidade. O agente trabalha o tempo todo e enfrenta situações novas o tempo todo, então o ciclo de melhoria precisa estar vivo. O feedback coletado hoje melhora o agente já na semana seguinte.
O que isso significa
A distância entre "o agente funciona" e "o agente funciona como nosso melhor funcionário" é uma lacuna de conhecimento. Um único prompt bem-feito não resolve isso. É preciso um trabalho sistemático: transformar a expertise da equipe em sinais de treinamento e incorporar o feedback a um ciclo regular de melhoria do agente.
As empresas que montarem esse ciclo agora terão agentes que realmente resolvem problemas de negócio, e não apenas impressionam em demos.
Perguntas frequentes sobre a notícia
O que se sabe sobre Dois tipos de conhecimento em uma organização?
Toda empresa tem dois tipos fundamentalmente diferentes de expertise corporativa. Conhecimento institucional é o que está documentado: regulamentos, checklists, bases de conhecimento, SOPs. Ele se automatiza bem. Basta adicionar os documentos ao contexto do agente ou montar um sistema de RAG, e o agente encontra o procedimento certo e o aplica. As empresas costumam resolver essa parte rapidamente. Conhecimento tácito é outra história. É aquilo que um funcionário experiente sabe, mas nunca formulou em voz alta. A intuição de um gerente de vendas que, pelo tom de um e-mail, s
Por que os agentes travam sem esse conhecimento?
É no conhecimento tácito que a maioria dos agentes de IA tropeça. O agente segue as regras formais, mas não entende quando e por que deve se afastar delas. Ele age como um funcionário novo sem mentor: tecnicamente correto, mas sem nuances e sem faro. Sintomas típicos dessa lacuna: Respostas formalmente corretas, mas inadequadas no contexto específico Incapacidade de lidar com situações fora do padrão que um funcionário experiente resolve na hora Perda de orientação quando não há uma regra inequívoca Desconsideração do contexto de um cliente ou de uma solicitação específica
Como incorporar o julgamento ao ciclo de melhoria?
A solução não é adicionar mais um documento ao RAG nem reescrever o prompt de sistema. É transformar as pessoas em fonte de feedback, e não apenas em operadores que aprovam cada passo. O objetivo é converter gradualmente o conhecimento tácito em conhecimento explícito que o agente possa usar. Na prática, é um ciclo de três etapas: Monitoramento: registrar todas as sessões do agente e destacar os casos em que ele errou ou entregou um resultado abaixo do ideal Anotação: pedir a especialistas da equipe que analisem os casos problemáticos e expliquem o que estava certo e por qu
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.