AMD e Intel aprovam instruções ACE: aceleradores de IA chegarão aos futuros processadores x86
AMD e Intel aprovaram em conjunto o ACE (AI Compute Extensions), um conjunto de instruções para os futuros processadores x86. Elas adicionam aos núcleos da CPU unidades especializadas de multiplicação de matrizes com suporte a pesos quantizados, operação-chave para a inferência de IA local. As duas empresas trabalham na especificação desde o outono de 2024 no Grupo Consultivo do Ecossistema x86, para não perder terreno para as arquiteturas Arm e RISC-V.
Processado por IA de 3DNews AI; editado por Hamidun News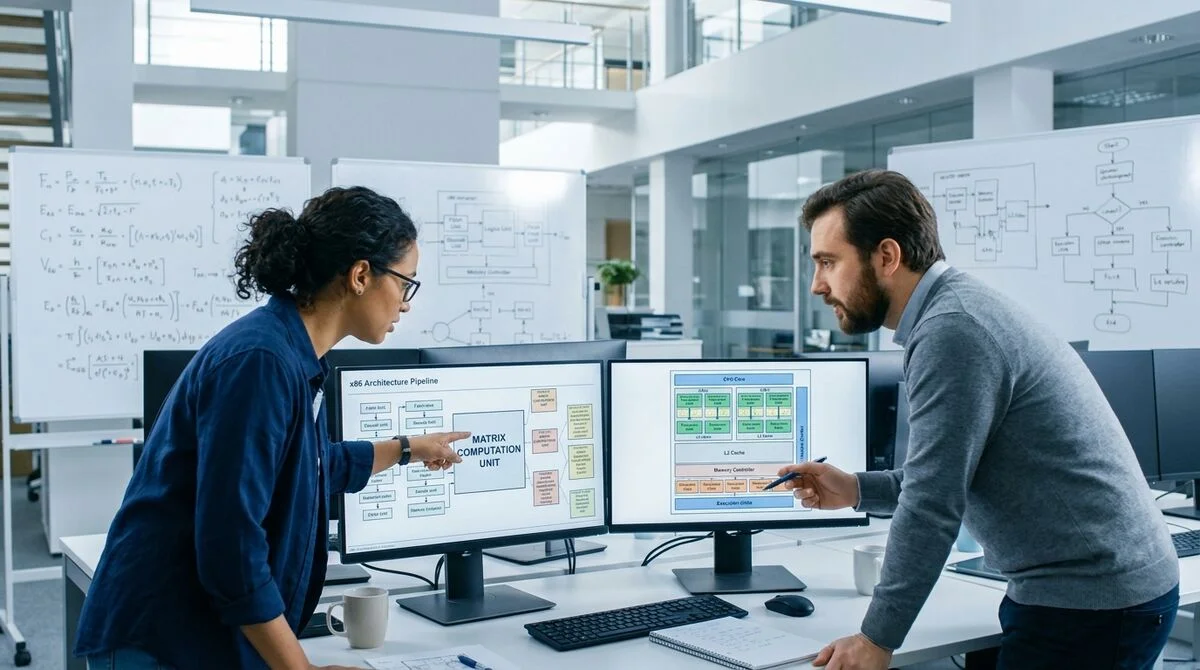
AMD e Intel publicaram uma especificação conjunta, AI Compute Extensions (ACE): um conjunto de novas instruções para os futuros processadores x86 que adicionam unidades de cálculo especializadas para acelerar tarefas de inteligência artificial diretamente nos núcleos da CPU.
Por que o ACE foi necessário
Desde o outono de 2024, AMD e Intel trabalham juntas no Grupo Consultivo do Ecossistema x86. O objetivo principal é proteger a posição da arquitetura clássica diante da concorrência crescente de Arm e RISC-V, que avançam com força em servidores, notebooks e sistemas embarcados.
Há poucos anos, o x86 era o padrão incontestável para PCs e servidores. Hoje isso já não é tão claro: o Apple Silicon, baseado em Arm, mostrou desempenho profissional em notebooks, o Qualcomm Snapdragon X Elite chegou aos dispositivos com Windows, e os servidores Arm da Ampere e da AWS Graviton ocupam uma fatia cada vez maior dos data centers em nuvem.
Nesse contexto, a especificação conjunta ACE é a resposta dos dois fabricantes a uma ameaça comum. Um padrão único permite que desenvolvedores de software implementem o suporte ao ACE uma só vez e ganhem aceleração tanto em chips da AMD quanto da Intel, sem otimizar separadamente para cada fabricante.
O que o ACE faz
O ACE se baseia na multiplicação de matrizes, a operação matemática básica das redes neurais. É ela que consome a maior parte do tempo de processamento ao executar modelos de linguagem, sistemas de reconhecimento de imagem e outras aplicações de IA.
A especificação foca principalmente a inferência de IA, ou seja, a execução de modelos já treinados em ambiente de produção, e não o treinamento. Nesse cenário, o suporte a pesos quantizados é especialmente importante: os formatos INT4, INT8, FP8 e afins permitem manter na memória modelos maiores com exigências de recursos bem menores.
Principais recursos previstos na especificação:
- Unidades especializadas de multiplicação de matrizes dentro dos núcleos da CPU
- Suporte a formatos de dados quantizados (INT4, INT8, FP8)
- Otimização para inferência de IA, não para treinamento
- Uma especificação única para processadores AMD e Intel
- Compatibilidade com o ecossistema x86 existente
Vale destacar que o ACE descreve o nível ISA, o conjunto de instruções, e não a implementação microarquitetural. Cada fabricante construirá suas unidades de hardware à sua maneira, mas o código escrito para ACE funcionará tanto em AMD quanto em Intel.
A concorrência empurra para a aliança
AMD e Intel são rivais históricas, com décadas de disputa. Um projeto técnico público e conjunto entre as duas é raro e revelador por si só: mostra o tamanho da pressão sobre o ecossistema x86.
A Arm já provou que consegue competir com o x86 em desempenho. O RISC-V, embora ainda menos maduro, vem ampliando o suporte nos meios acadêmico e industrial. Se o x86 não oferecer um padrão de IA competitivo, os desenvolvedores correm o risco de passar a otimizar para plataformas Arm, que já têm extensões consolidadas, como NEON, SME2 e outras.
Além disso, os responsáveis pelos grandes frameworks de IA, como PyTorch, ONNX Runtime e TensorFlow Lite, têm interesse em padrões estáveis. Uma especificação única reduz o custo de suportar o x86 e torna a plataforma mais atraente para aplicar otimizações.
O que isso significa
O ACE é o primeiro grande padrão técnico conjunto em muito tempo entre os dois principais players do mercado x86. Se a especificação for amplamente adotada, a próxima geração de sistemas x86 poderá executar modelos de IA locais com mais eficiência, sem NPU ou GPU adicional. Para o segmento corporativo, isso significa mais flexibilidade na implantação de aplicações de IA; para dispositivos de consumo, melhor desempenho sem aumento de custo.
- 2 de nov. de 2026TensorFold 1.2.0 aumenta em 44,2% a vazão do Qwen3.8-27B no M3 Ultra com 16 fluxos
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 29 de out. de 2026Claude Code edita vídeo a partir da transcrição: como funciona o video-use, com 30 000 estrelas
- 29 de out. de 2026Ferramenta de IA de Stanford verificou parte do código do Signal em meio dia e com US$ 500, em vez de 5 meses
Perguntas frequentes sobre a notícia
Por que o ACE foi necessário?
Desde o outono de 2024, AMD e Intel trabalham juntas no Grupo Consultivo do Ecossistema x86. O objetivo principal é proteger a posição da arquitetura clássica diante da concorrência crescente de Arm e RISC-V, que avançam com força em servidores, notebooks e sistemas embarcados. Há poucos anos, o x86 era o padrão incontestável para PCs e servidores.
O que o ACE faz?
O ACE se baseia na multiplicação de matrizes, a operação matemática básica das redes neurais. É ela que consome a maior parte do tempo de processamento ao executar modelos de linguagem, sistemas de reconhecimento de imagem e outras aplicações de IA. A especificação foca principalmente a inferência de IA, ou seja, a execução de modelos já treinados em ambiente de produção, e não o treinamento.
O que se sabe sobre A concorrência empurra para a aliança?
AMD e Intel são rivais históricas, com décadas de disputa. Um projeto técnico público e conjunto entre as duas é raro e revelador por si só: mostra o tamanho da pressão sobre o ecossistema x86. A Arm já provou que consegue competir com o x86 em desempenho. O RISC-V, embora ainda menos maduro, vem ampliando o suporte nos meios acadêmico e industrial.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.