AWS mostra como o data mesh vira a base para IA agêntica em produção
A AWS publicou um guia para construir um data mesh em sua plataforma como base confiável para IA agêntica em produção. A ideia: agentes não conseguem operar de forma estável sem acesso governado aos dados. A AWS propõe um stack serverless com S3, Glue, Lake Formation e Athena, com acesso por papéis no nível do domínio, auditoria completa e contratos de dados para cada agente de IA.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News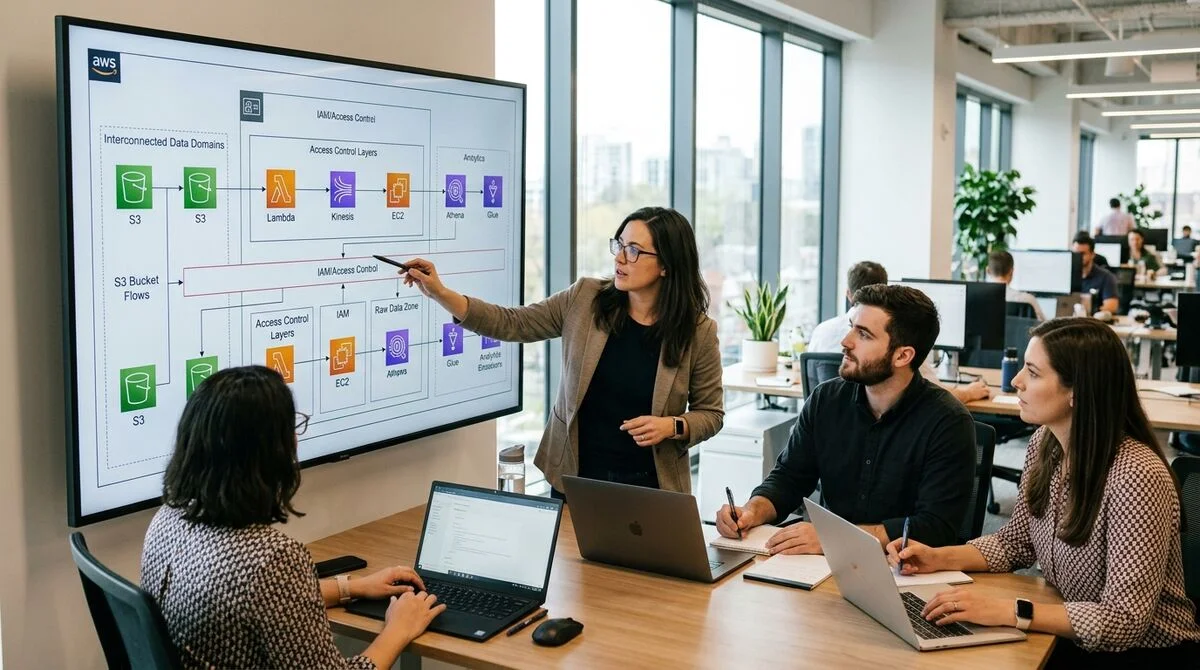
A AWS publicou um guia técnico detalhado para criar um data mesh serverless governado, uma arquitetura que dá à IA agêntica uma base confiável, segura e escalável para operar em produção.
Por que agentes precisam de um data mesh
A IA agêntica é fundamentalmente diferente dos chatbots: ela monta sozinha cadeias de ações, recorre a ferramentas e toma decisões sem participação humana. Para fazer isso com confiabilidade, o agente precisa receber dados corporativos atualizados em tempo real, sempre dentro das políticas de segurança.
O problema é que os dados corporativos costumam estar espalhados por dezenas de sistemas, times e formatos. Data warehouses e data lakes centralizados resolvem parte das necessidades, mas criam um gargalo: os dados ficam desatualizados, os esquemas divergem e uma única equipe de engenheiros não dá conta dos pedidos de todos os departamentos.
O data mesh propõe outra abordagem: cada domínio (finanças, marketing, logística) é dono dos seus dados e os publica como um "produto", com documentação, esquemas claros e contratos de acesso. O agente de IA se conecta diretamente a esse produto, sem intermediários.
Arquitetura na AWS
A AWS oferece um stack serverless que permite implementar um data mesh sem gerenciar servidores:
- Amazon S3: armazenamento descentralizado; cada domínio mantém seus dados em buckets separados
- AWS Glue Data Catalog: catálogo único de esquemas e metadados para todos os domínios
- AWS Lake Formation: gerenciamento de permissões de acesso no nível de tabela, coluna e linha
- Amazon Athena: consultas SQL serverless sobre dados no S3, sem pipelines ETL adicionais
- AWS IAM: modelo baseado em papéis; cada agente recebe as permissões mínimas necessárias
O ponto central: o agente não precisa saber onde os dados estão fisicamente. Ele acessa um produto lógico pelo catálogo do Glue, e não diretamente os buckets do S3. Isso permite que os times movam e reestruturem os dados sem alterar a interface para os agentes.
Na prática, o ciclo funciona assim: o agente recebe um papel do IAM, o Lake Formation verifica as permissões a cada consulta, o Athena executa o SQL e o resultado volta ao agente. Tudo é serverless e todas as ações são auditáveis.
Segurança e controle
A IA agêntica é imprevisível: ela pode gerar uma consulta que sobrecarregue o sistema ou tentar ler dados fora do seu domínio. A AWS trata isso em várias camadas.
As políticas do Lake Formation bloqueiam qualquer consulta fora da área permitida, mesmo que o agente tenha acesso técnico ao S3. O CloudTrail mantém um log de auditoria completo de cada ação. As cotas do Athena limitam o volume de dados escaneados por consulta, o que protege contra sobrecargas acidentais ou intencionais.
Outro detalhe importante é a semântica dos dados. O Glue Data Catalog guarda não só os esquemas, mas também as descrições dos campos: o agente entende o significado do que lê, em vez de receber apenas um conjunto de bytes sem contexto. O versionamento de esquemas garante que uma mudança de estrutura em um domínio não quebre os agentes que trabalham com aquele produto.
O que isso significa
O data mesh deixa de ser um conceito teórico e passa a ser um requisito prático para quem constrói IA em produção. Empresas sem acesso governado aos dados terão agentes pouco confiáveis ou inseguros, e com mais frequência as duas coisas ao mesmo tempo.
A AWS oferece um stack serverless pronto, que cobre a maioria das tarefas logo de saída.
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
- 30 de out. de 2026AWS dá a agentes de código uma prévia ao vivo do site direto da sessão isolada
- 30 de out. de 2026MoEngage abre 400 APIs privadas a agentes de IA via AgentCore Gateway, sem servidores MCP próprios
- 29 de out. de 2026NVIDIA Nemotron 3.5 Super VL: 120 bilhões de parâmetros, 12 bilhões ativos, com implantação na AWS
Perguntas frequentes sobre a notícia
Por que agentes precisam de um data mesh?
A IA agêntica é fundamentalmente diferente dos chatbots: ela monta sozinha cadeias de ações, recorre a ferramentas e toma decisões sem participação humana. Para fazer isso com confiabilidade, o agente precisa receber dados corporativos atualizados em tempo real, sempre dentro das políticas de segurança. O problema é que os dados corporativos costumam estar espalhados por dezenas de sistemas, times e formatos. Data warehouses e data lakes centralizados resolvem parte das necessidades, mas criam um gargalo: os dados ficam desatualizados, os esquemas divergem e uma única equip
O que se sabe sobre Arquitetura na AWS?
A AWS oferece um stack serverless que permite implementar um data mesh sem gerenciar servidores: Amazon S3: armazenamento descentralizado; cada domínio mantém seus dados em buckets separados AWS Glue Data Catalog: catálogo único de esquemas e metadados para todos os domínios AWS Lake Formation: gerenciamento de permissões de acesso no nível de tabela, coluna e linha Amazon Athena: consultas SQL serverless sobre dados no S3, sem pipelines ETL adicionais AWS IAM: modelo baseado em papéis; cada agente recebe as permissões mínimas necessárias O ponto central: o agente não preci
O que se sabe sobre Segurança e controle?
A IA agêntica é imprevisível: ela pode gerar uma consulta que sobrecarregue o sistema ou tentar ler dados fora do seu domínio. A AWS trata isso em várias camadas. As políticas do Lake Formation bloqueiam qualquer consulta fora da área permitida, mesmo que o agente tenha acesso técnico ao S3. O CloudTrail mantém um log de auditoria completo de cada ação. As cotas do Athena limitam o volume de dados escaneados por consulta, o que protege contra sobrecargas acidentais ou intencionais. Outro detalhe importante é a semântica dos dados. O Glue Data Catalog guarda não só os esquem
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.