AWS mostra como o data mesh se torna a base da IA agêntica em produção
A AWS publicou um guia para construir um data mesh em sua plataforma como base confiável para IA agêntica em produção. A ideia: os agentes não conseguem operar de forma estável sem acesso governado aos dados. A AWS propõe uma stack serverless — S3, Glue, Lake Formation, Athena — com acesso baseado em papéis no nível de domínio, auditoria completa e contratos de dados para cada agente de IA.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News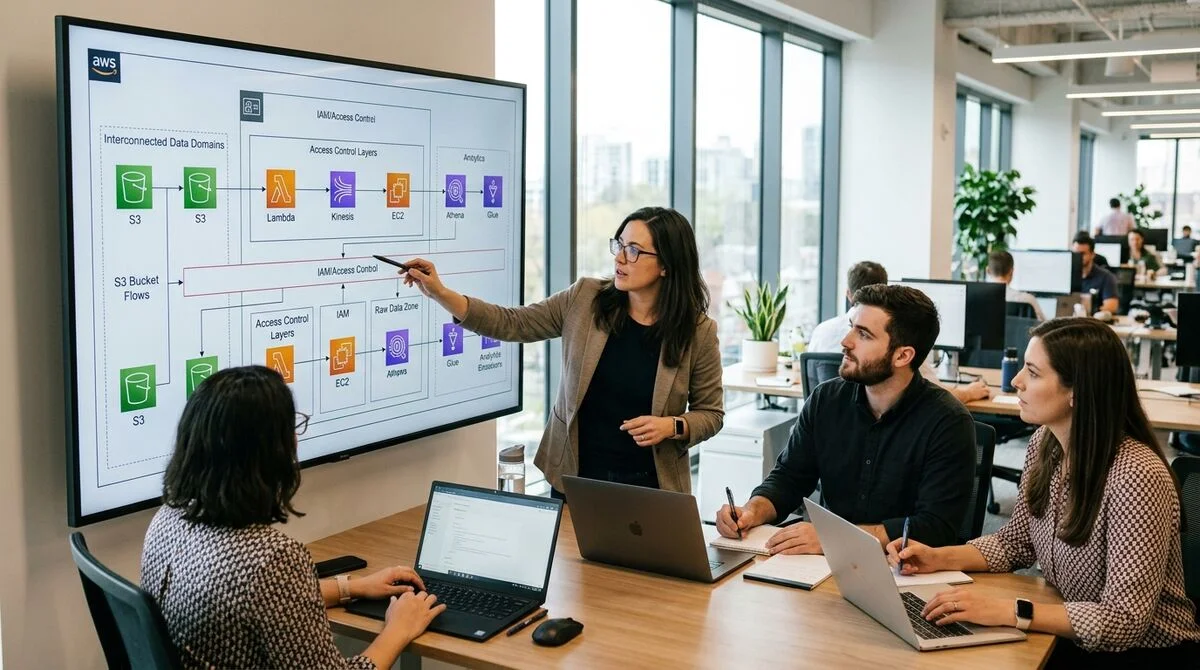
A AWS publicou um guia técnico detalhado sobre como construir um data mesh serverless gerenciado — uma arquitetura que fornece ao AI agentic uma base confiável, segura e escalável para trabalhar em produção.
Por que agentes precisam de data mesh
AI agentic é fundamentalmente diferente de chatbots: ele forma independentemente cadeias de ações, acessa ferramentas e toma decisões sem envolvimento humano. Para fazer isso de forma confiável, um agente deve receber dados corporativos atuais em tempo real — e fazer isso estritamente dentro das políticas de segurança. O problema é que os dados corporativos são tradicionalmente espalhados por dezenas de sistemas, equipes e formatos.
Data warehouses centralizados e data lakes resolvem parte do problema, mas criam um gargalo: os dados ficam obsoletos, os esquemas divergem e uma única equipe de engenheiros não consegue lidar com solicitações de todos os departamentos. O data mesh propõe uma abordagem diferente: cada domínio (finanças, marketing, logística) possui seus próprios dados e os publica como um "produto" — com documentação, esquemas claros e contratos de acesso. Um agente de AI se conecta diretamente a esse produto sem intermediários.
Arquitetura na AWS
A AWS oferece uma pilha serverless que permite implementar data mesh sem gerenciamento de servidores:
- Amazon S3 — armazenamento descentralizado: cada domínio mantém dados em buckets separados
- AWS Glue Data Catalog — catálogo unificado de esquemas e metadados para todos os domínios
- AWS Lake Formation — gerenciamento de direitos de acesso em nível de tabela, coluna e linha
- Amazon Athena — consultas SQL serverless contra dados em S3 sem pipelines ETL adicionais
- AWS IAM — modelo baseado em papéis: cada agente recebe as permissões mínimas necessárias
O ponto-chave: agentes não precisam saber a localização física dos dados. Eles acessam o produto lógico através do catálogo Glue, não diretamente aos buckets S3. Isso permite que as equipes movam e reestruturem dados sem alterar a interface para agentes. Na prática, o ciclo funciona assim: o agente recebe uma função IAM, o Lake Formation verifica as permissões a cada consulta, o Athena executa SQL, o resultado retorna ao agente. Tudo é serverless, todas as ações são auditáveis.
Segurança e controle
AI agentic é imprevisível: pode formular uma consulta que sobrecarregue o sistema ou tentar ler dados fora de seu domínio. A AWS aborda isso em múltiplos níveis. As políticas do Lake Formation bloqueiam qualquer consulta fora do escopo permitido — mesmo se o agente tecnicamente tiver acesso ao S3.
O CloudTrail mantém um registro de auditoria completo de cada ação. As cotas do Athena limitam o volume de dados verificados por consulta, protegendo contra sobrecargas acidentais ou intencionais. Outro detalhe importante é a semântica dos dados.
O Glue Data Catalog armazena não apenas esquemas, mas também descrições de campos: o agente entende o significado do que lê, não apenas um conjunto de bytes sem contexto. O versionamento de esquemas garante que mudanças de estrutura em um domínio não quebrem agentes trabalhando com esse produto.
O que isso significa
Data mesh deixa de ser um conceito teórico e se torna um requisito prático para quem constrói AI em produção. Empresas sem acesso gerenciado a dados terão agentes que são não confiáveis ou inseguros — ou mais frequentemente ambos. A AWS oferece uma pilha serverless pronta que cobre a maioria das tarefas já incluídas.
- 24 de out. de 2026Lovable lança pacote corporativo com deploy em AWS e Azure do cliente, inferência na UE e políticas de governança
- 24 de out. de 2026Vercel leva o Python à GA e lança Daemons para workers em segundo plano
- 24 de out. de 2026Vercel Sandbox resiste a ataques: 1285 relatórios, US$ 242 000 e uma falha no kernel do Linux
- 24 de out. de 2026Anthropic abre quinto escritório na APAC: Singapura fica em 2º lugar entre 121 países no uso do Claude
Perguntas frequentes sobre a notícia
Por que agentes precisam de data mesh?
AI agentic é fundamentalmente diferente de chatbots: ele forma independentemente cadeias de ações, acessa ferramentas e toma decisões sem envolvimento humano. Para fazer isso de forma confiável, um agente deve receber dados corporativos atuais em tempo real — e fazer isso estritamente dentro das políticas de segurança. O problema é que os dados corporativos são tradicionalmente espalhados por dezenas de sistemas, equipes e formatos. Data warehouses centralizados e data lakes resolvem parte do problema, mas criam um gargalo: os dados ficam obsoletos, os esquemas divergem e u
O que se sabe sobre Arquitetura na AWS?
A AWS oferece uma pilha serverless que permite implementar data mesh sem gerenciamento de servidores: Amazon S3 — armazenamento descentralizado: cada domínio mantém dados em buckets separados AWS Glue Data Catalog — catálogo unificado de esquemas e metadados para todos os domínios AWS Lake Formation — gerenciamento de direitos de acesso em nível de tabela, coluna e linha Amazon Athena — consultas SQL serverless contra dados em S3 sem pipelines ETL adicionais AWS IAM — modelo baseado em papéis: cada agente recebe as permissões mínimas necessárias O ponto-chave: agentes não p
O que se sabe sobre Segurança e controle?
AI agentic é imprevisível: pode formular uma consulta que sobrecarregue o sistema ou tentar ler dados fora de seu domínio. A AWS aborda isso em múltiplos níveis. As políticas do Lake Formation bloqueiam qualquer consulta fora do escopo permitido — mesmo se o agente tecnicamente tiver acesso ao S3. O CloudTrail mantém um registro de auditoria completo de cada ação. As cotas do Athena limitam o volume de dados verificados por consulta, protegendo contra sobrecargas acidentais ou intencionais. Outro detalhe importante é a semântica dos dados. O Glue Data Catalog armazena não a
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.