Datalab lança lift, modelo de 9 bilhões de parâmetros com pesos abertos para extrair JSON de PDFs
A Datalab lançou o lift, um modelo visual aberto de 9 bilhões de parâmetros que extrai JSON estruturado de PDFs e imagens conforme um esquema definido. O modelo usa decodificação restrita pelo esquema e retorna null em vez de alucinar quando faltam dados. Em um benchmark de 225 documentos, a precisão por campo chegou a 90,2%.
Processado por IA de MarkTechPost; editado por Hamidun News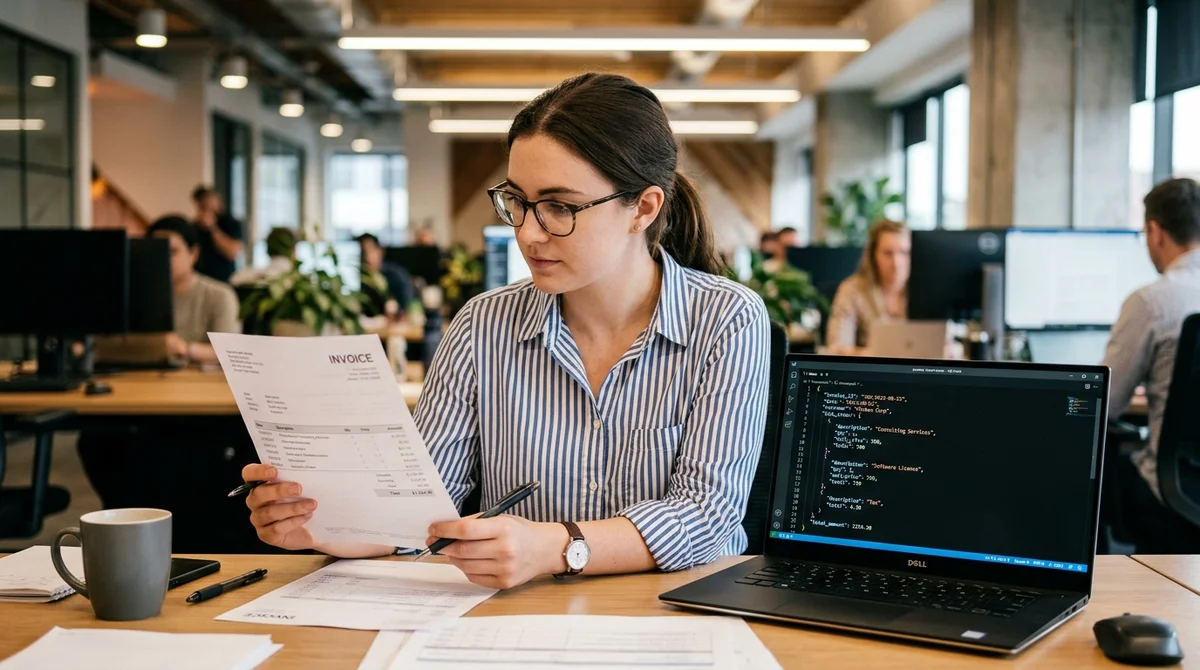
Datalab lançou lift — um modelo visual aberto com 9 bilhões de parâmetros que transforma documentos PDF e imagens em JSON estruturado de acordo com um esquema fornecido. Em um conjunto de 225 documentos reais, o modelo alcançou uma precisão de campo de 90,2% — uma das principais métricas em tarefas de análise automática de documentos.
Como o lift Funciona
O princípio de operação é direto: o modelo recebe duas entradas — um documento (PDF ou imagem) e um esquema JSON descrevendo a estrutura de dados necessária. A saída é um objeto JSON cujos campos são preenchidos com valores extraídos do documento.
A característica técnica-chave é a decodificação com restrição de esquema (schema-constrained decoding). Em cada etapa da geração de tokens, as variantes permitidas são restritas apenas àquelas que estão em conformidade com o esquema fornecido. O JSON resultante é sempre sintaticamente válido e corresponde aos tipos esperados: sem colchetes perdidos, strings em vez de números, ou arrays onde se esperam objetos.
A segunda característica importante é a abstenção treinada (trained abstention). Se um campo do esquema está ausente no documento, o modelo retorna explicitamente null em vez de inventar um valor. Isso resolve diretamente o problema de alucinações: modelos generativos frequentemente "preenchem" campos vazios com dados plausíveis mas ficcionais. Um null explícito é mais confiável — o sistema downstream pode lidar corretamente com a ausência de um campo em vez de receber um erro silencioso.
O Que o Benchmark Mostrou
Datalab testou lift em um conjunto de 225 documentos reais de vários tipos. A métrica principal é a precisão de campo: a proporção de campos que o modelo preencheu corretamente em relação às anotações de verdade.
O resultado final — 90,2% — é um indicador significativo para document intelligence. É importante entender o contexto: o mesmo tipo de documento (por exemplo, uma fatura) pode existir em dezenas de formatos de diferentes fornecedores, ter diferentes layouts de tabelas, anotações manuscritas e qualidade ruim de digitalização. Alta precisão em um conjunto heterogêneo é um sinal de verdadeira capacidade de generalização.
Características principais do modelo:
- Pesos abertos — implantação sem dependência de APIs de nuvem de terceiros
- 9 bilhões de parâmetros — cabe em um único GPU de servidor (A100, H100) ou em uma placa consumer poderosa
- Esquemas JSON arbitrários — se adapta a qualquer tipo de documento sem ajuste fino
- Retorna null em vez de alucinações — comportamento previsível quando dados estão ausentes da fonte
- Processamento nativo de PDF e imagens sem uma etapa OCR separada na entrada
Por Que Isto Importa para o Negócio
A análise de documentos não estruturados é um problema crônico nos processos corporativos. Faturas de fornecedores, contratos, registros médicos, declarações alfandegárias, extratos bancários, apólices de seguro — tudo chega em formatos diferentes e requer entrada manual de dados ou automação cara.
A abordagem tradicional envolve um pipeline de múltiplas etapas: OCR para reconhecimento de texto, normalização, extração de entidades nomeadas via NLP, pós-processamento e verificação manual de campos questionáveis. Cada etapa é um ponto separado de falha e um item de linha separado nos custos de desenvolvimento e manutenção.
lift encurta este caminho: você descreve a estrutura necessária como um esquema JSON, passa o documento — obtém JSON pronto. Pesos abertos permitem que você implante o modelo em sua própria infraestrutura e, se necessário, ajuste-o finamente em documentos corporativos sem enviar dados para serviços externos. Para organizações financeiras, instituições médicas e firmas de advocacia com requisitos estritos de confidencialidade, isso é fundamentalmente importante.
Datalab já é conhecida na comunidade pela ferramenta Marker — um conversor de PDF para Markdown de alta qualidade. lift continua esta linha, adicionando saída estruturada e tipagem rigorosa de dados.
O Que Isto Significa
Modelos abertos especializados para document intelligence reduzem a barreira de entrada para automação de documentos. Se lift manter sua precisão reivindicada em dados corporativos reais, torna-se uma alternativa séria para plataformas em nuvem como Amazon Textract ou Azure Form Recognizer — sem lock-in de fornecedor e com a capacidade de ajustar finamente para seus próprios tipos de documentos.
Perguntas frequentes sobre a notícia
Como o lift Funciona?
O princípio de operação é direto: o modelo recebe duas entradas — um documento (PDF ou imagem) e um esquema JSON descrevendo a estrutura de dados necessária. A saída é um objeto JSON cujos campos são preenchidos com valores extraídos do documento. A característica técnica-chave é a decodificação com restrição de esquema (schema-constrained decoding). Em cada etapa da geração de tokens, as variantes permitidas são restritas apenas àquelas que estão em conformidade com o esquema fornecido. O JSON resultante é sempre sintaticamente válido e corresponde aos tipos esperados: sem
O Que o Benchmark Mostrou?
Datalab testou lift em um conjunto de 225 documentos reais de vários tipos. A métrica principal é a precisão de campo: a proporção de campos que o modelo preencheu corretamente em relação às anotações de verdade. O resultado final — 90,2% — é um indicador significativo para document intelligence. É importante entender o contexto: o mesmo tipo de documento (por exemplo, uma fatura) pode existir em dezenas de formatos de diferentes fornecedores, ter diferentes layouts de tabelas, anotações manuscritas e qualidade ruim de digitalização. Alta precisão em um conjunto heterogêneo
Por Que Isto Importa para o Negócio?
A análise de documentos não estruturados é um problema crônico nos processos corporativos. Faturas de fornecedores, contratos, registros médicos, declarações alfandegárias, extratos bancários, apólices de seguro — tudo chega em formatos diferentes e requer entrada manual de dados ou automação cara. A abordagem tradicional envolve um pipeline de múltiplas etapas: OCR para reconhecimento de texto, normalização, extração de entidades nomeadas via NLP, pós-processamento e verificação manual de campos questionáveis. Cada etapa é um ponto separado de falha e um item de linha sepa
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.