VLMs ensinam robôs a ler emoções humanas, mas confiança vale mais que gentileza
Pesquisadores da Universidade de Melbourne treinaram um robô para ler emoções com um modelo de visão e linguagem (VLM) que analisa a cena inteira, não apenas a expressão facial. O VLM atingiu precisão de 0,86, contra 0,77 de um algoritmo clássico. Dos 40 participantes, 31 preferiram as desculpas personalizadas do robô às roteirizadas. Mas a principal conclusão é que a gentileza depois de uma falha não restaura a confiança: as pessoas querem um parceiro competente.
Processado por IA de IEEE Spectrum AI; editado por Hamidun News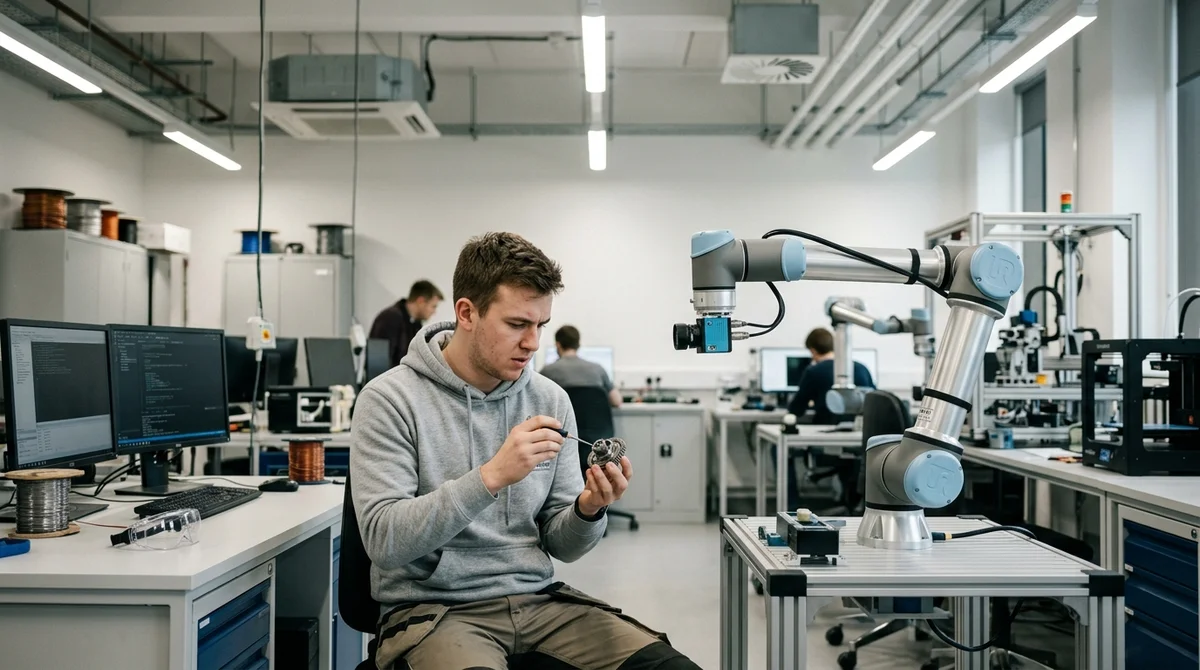
Pesquisadores da Universidade de Melbourne treinaram robôs colaborativos para ler emoções humanas com um modelo de visão e linguagem (VLM). O estudo, publicado na IEEE Robotics and Automation Letters, mostra que os robôs estão mais atentos às pessoas, mas a confiança neles continua sendo definida não pela forma de se comunicar, e sim pela capacidade de dar conta das tarefas.
Contexto em vez de expressão facial
Os sistemas padrão de interação humano-máquina se baseiam na análise da expressão facial e no rastreamento de objetos no quadro. Os pesquisadores, liderados por Seung Chan Hong, decidiram ir além e usar um VLM, uma classe de modelos que processa texto e dados visuais ao mesmo tempo.
Para treinar o modelo, voluntários assistiram a vídeos em que robôs entregavam objetos a pessoas com diferentes graus de sucesso e descreveram as emoções dos participantes da cena. O ponto essencial é que os avaliadores levaram em conta todo o contexto: a testa franzida de uma pessoa que tamborila os dedos na mesa indica irritação; a mesma testa franzida em alguém concentrado numa tarefa indica apenas concentração.
A comparação com o algoritmo clássico deu um resultado convincente: o VLM obteve precisão de 0,86 numa escala de 0 a 1, enquanto a abordagem tradicional ficou em 0,77. Segundo Hong, o modelo "via a cena inteira: onde a pessoa está, o que ela faz, como interage com o robô", e foi isso que lhe deu a vantagem.
Desculpas personalizadas funcionam, mas nem sempre
No segundo experimento, 40 voluntários trabalharam em conjunto com um robô programado de antemão para cometer um erro. Depois da falha, o robô reagia de uma de duas maneiras:
- Desculpa adaptativa: elaborada com base no estado emocional detectado da pessoa
- Frase padrão: uma resposta roteirizada, escrita previamente
31 dos 40 participantes preferiram a reação personalizada. Isso confirma que as pessoas valorizam sentir que o robô percebe seu estado e reage a ele de forma coerente.
Porém, os dados das pesquisas mostraram outro lado: as avaliações de confiança no robô caíram para a maioria dos participantes após o erro, independentemente do tipo de desculpa.
"A desculpa personalizada funciona como um lubrificante social, mas não restaura a confiança perdida por uma falha numa tarefa física", explica
Hong.
Onde terminam as capacidades do VLM
A análise dos dados do segundo experimento revelou uma limitação importante. Quando as estimativas de emoções do VLM foram comparadas com o que os próprios participantes relataram sobre seu estado, a precisão do modelo despencou. O modelo coincidia bem com a percepção de observadores externos, mas previa mal as vivências internas dos participantes.
"O VLM é um bom observador de sinais sociais externos, mas não sabe ler mentes", explicou Hong. Em outras palavras, o modelo percebe o mesmo que perceberia um estranho olhando de fora. Em situações em que a pessoa disfarça as emoções ou sente algo que não aparece na expressão facial e nos gestos, o sistema falha.
O que isso significa
O estudo define uma prioridade clara para os desenvolvedores: primeiro a confiabilidade e a precisão na execução das tarefas, depois a camada de interação emocional. As pessoas estão dispostas a colaborar com robôs que saibam se desculpar de maneira humana, mas, acima de tudo, querem parceiros competentes que não cometam erros.
À medida que as abordagens baseadas em VLM evoluírem, a distância em relação aos sistemas tradicionais de reconhecimento de emoções tende a aumentar, mas isso não eliminará a questão fundamental da confiança.
Perguntas frequentes sobre a notícia
O que se sabe sobre Contexto em vez de expressão facial?
Os sistemas padrão de interação humano-máquina se baseiam na análise da expressão facial e no rastreamento de objetos no quadro. Os pesquisadores, liderados por Seung Chan Hong, decidiram ir além e usar um VLM, uma classe de modelos que processa texto e dados visuais ao mesmo tempo. Para treinar o modelo, voluntários assistiram a vídeos em que robôs entregavam objetos a pessoas com diferentes graus de sucesso e descreveram as emoções dos participantes da cena. O ponto essencial é que os avaliadores levaram em conta todo o contexto: a testa franzida de uma pessoa que tambori
O que se sabe sobre Desculpas personalizadas funcionam, mas nem sempre?
No segundo experimento, 40 voluntários trabalharam em conjunto com um robô programado de antemão para cometer um erro. Depois da falha, o robô reagia de uma de duas maneiras: Desculpa adaptativa: elaborada com base no estado emocional detectado da pessoa Frase padrão: uma resposta roteirizada, escrita previamente 31 dos 40 participantes preferiram a reação personalizada. Isso confirma que as pessoas valorizam sentir que o robô percebe seu estado e reage a ele de forma coerente. Porém, os dados das pesquisas mostraram outro lado: as avaliações de confiança no robô caíram par
Onde terminam as capacidades do VLM?
A análise dos dados do segundo experimento revelou uma limitação importante. Quando as estimativas de emoções do VLM foram comparadas com o que os próprios participantes relataram sobre seu estado, a precisão do modelo despencou. O modelo coincidia bem com a percepção de observadores externos, mas previa mal as vivências internas dos participantes. "O VLM é um bom observador de sinais sociais externos, mas não sabe ler mentes", explicou Hong. Em outras palavras, o modelo percebe o mesmo que perceberia um estranho olhando de fora. Em situações em que a pessoa disfarça as emo
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.