Robôs treinados com VLM para ler emoções humanas — mas confiança importa mais que polidez
Cientistas da Universidade de Melbourne treinaram um robô para ler emoções usando um modelo de visão-linguagem — ele analisa toda a cena, não apenas expressões faciais. O VLM alcançou precisão de 0,86 contra 0,77 do algoritmo clássico. De 40 participantes, 31 preferiram as desculpas personalizadas do robô às pré-programadas. Mas o achado principal: a polidez após uma falha não recupera confiança — as pessoas querem um parceiro competente.
Processado por IA de IEEE Spectrum AI; editado por Hamidun News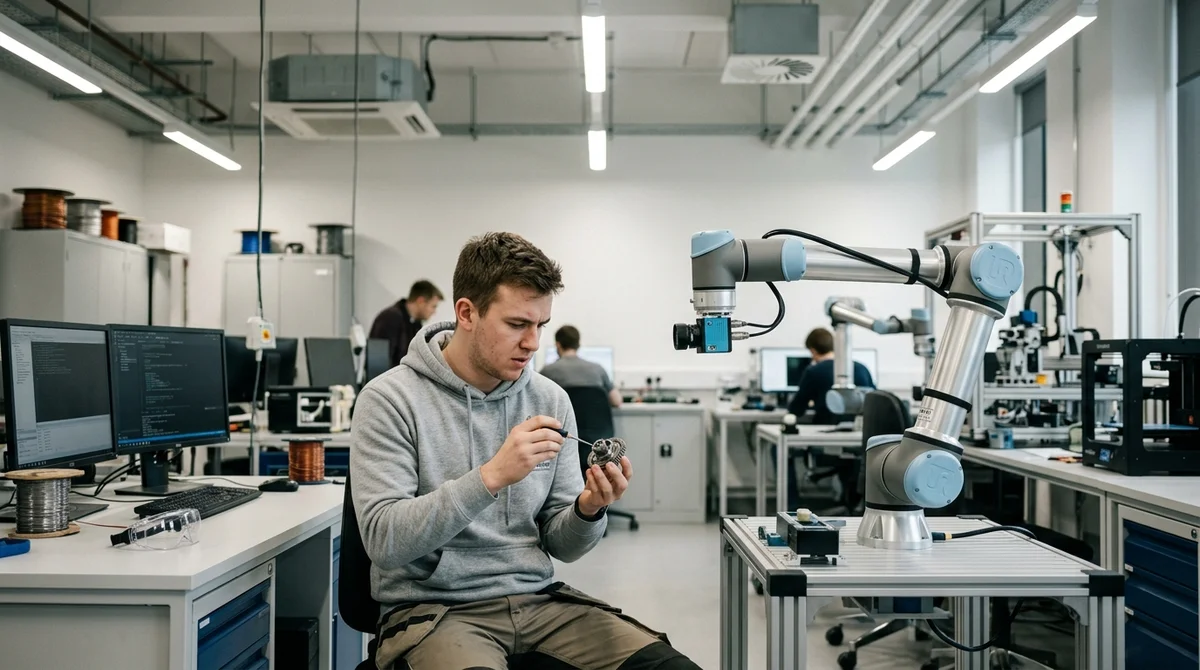
Cientistas da Universidade de Melbourne ensinaram robôs colaborativos a ler emoções humanas usando um modelo de visão-linguagem (VLM). A pesquisa publicada na IEEE Robotics and Automation Letters mostra: robôs se tornam mais atentos às pessoas, mas a confiança neles ainda é determinada não pela maneira de se comunicar, mas pela capacidade de executar tarefas.
Contexto em vez de expressões faciais
Os sistemas padrão de interação humano-máquina dependem da análise de expressões faciais e rastreamento de objetos nos quadros. Pesquisadores liderados por Sung Chan Hong decidiram ir além e usar VLM — uma classe de modelos que processam texto e dados visuais simultaneamente.
Para treinar o modelo, voluntários assistiram a gravações de vídeo onde robôs entregavam objetos a pessoas com graus variados de sucesso e descreviam as emoções dos participantes da cena. Crucialmente, os avaliadores levavam em conta todo o contexto: uma testa franzida em uma pessoa batendo os dedos na mesa significa irritação; a mesma testa franzida em uma pessoa focada em uma tarefa significa simplesmente concentração.
A comparação com um algoritmo clássico produziu resultados convincentes: o VLM alcançou uma precisão de 0,86 em uma escala de 0 a 1, enquanto a abordagem tradicional obteve 0,77. De acordo com Hong, o modelo "viu toda a cena: onde a pessoa está localizada, o que ela está fazendo, como interage com o robô" — isto é exatamente o que lhe deu a vantagem.
Desculpas Personalizadas Funcionam — Mas Nem Sempre
No segundo experimento, 40 voluntários trabalharam colaborativamente com um robô que foi programado previamente para cometer um erro. Após a falha, o robô respondeu de uma de duas maneiras:
- Desculpa adaptativa — formulada com base na leitura do estado emocional da pessoa pelo robô
- Frase padrão — uma resposta roteirizada pré-escrita
31 dos 40 participantes preferiram a resposta personalizada. Isso confirma: as pessoas se importam em sentir que o robô percebe seu estado e responde de forma significativa.
No entanto, os dados da pesquisa revelaram outro lado da história: as avaliações de confiança da maioria dos participantes no robô diminuíram após o erro, independentemente do tipo de desculpa.
"Desculpa personalizada funciona como um lubrificante social, mas não restaura a confiança perdida devido à falha em uma tarefa física", explica
Hong.
Onde terminam as capacidades da VLM
A análise dos dados do segundo experimento revelou uma limitação importante. Quando as avaliações de emoções do VLM foram comparadas com o que os próprios participantes relataram sobre seu estado emocional, a precisão do modelo caiu drasticamente. O modelo se alinhou bem com as percepções de observadores externos, mas predisse mal as experiências internas dos próprios participantes.
"VLM é um bom observador de sinais sociais externos, mas não consegue ler mentes", explicou Hong. Em outras palavras, o modelo nota o que um observador externo olhando de fora notaria. Em situações em que uma pessoa mascara suas emoções ou experimenta algo que não se reflete em suas expressões faciais e gestos, o sistema falha.
O que isso significa
A pesquisa define uma prioridade clara para os desenvolvedores: primeiro confiabilidade e precisão na execução de tarefas, depois a camada de interação emocional. As pessoas estão dispostas a colaborar com robôs que podem se desculpar de forma humana, — mas acima de tudo eles querem parceiros competentes que não cometam erros.
À medida que as abordagens baseadas em VLM se desenvolvem, a lacuna com os sistemas tradicionais de reconhecimento de emoções crescerá, mas isso não resolve a questão fundamental da confiança.
Perguntas frequentes sobre a notícia
O que se sabe sobre Contexto em vez de expressões faciais?
Os sistemas padrão de interação humano-máquina dependem da análise de expressões faciais e rastreamento de objetos nos quadros. Pesquisadores liderados por Sung Chan Hong decidiram ir além e usar VLM — uma classe de modelos que processam texto e dados visuais simultaneamente. Para treinar o modelo, voluntários assistiram a gravações de vídeo onde robôs entregavam objetos a pessoas com graus variados de sucesso e descreviam as emoções dos participantes da cena. Crucialmente, os avaliadores levavam em conta todo o contexto: uma testa franzida em uma pessoa batendo os dedos na
O que se sabe sobre Desculpas Personalizadas Funcionam — Mas Nem Sempre?
No segundo experimento, 40 voluntários trabalharam colaborativamente com um robô que foi programado previamente para cometer um erro. Após a falha, o robô respondeu de uma de duas maneiras: Desculpa adaptativa — formulada com base na leitura do estado emocional da pessoa pelo robô Frase padrão — uma resposta roteirizada pré-escrita 31 dos 40 participantes preferiram a resposta personalizada. Isso confirma: as pessoas se importam em sentir que o robô percebe seu estado e responde de forma significativa. No entanto, os dados da pesquisa revelaram outro lado da história: as av
Onde terminam as capacidades da VLM?
A análise dos dados do segundo experimento revelou uma limitação importante. Quando as avaliações de emoções do VLM foram comparadas com o que os próprios participantes relataram sobre seu estado emocional, a precisão do modelo caiu drasticamente. O modelo se alinhou bem com as percepções de observadores externos, mas predisse mal as experiências internas dos próprios participantes. "VLM é um bom observador de sinais sociais externos, mas não consegue ler mentes", explicou Hong. Em outras palavras, o modelo nota o que um observador externo olhando de fora notaria. Em situaç
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.