Quando dados antigos travam a implantação de IA: riscos e soluções
As empresas estão correndo para usar dados antigos ao implantar sistemas de IA. Arquivos que pareciam poeira de depósito viraram, de repente, ouro para treinar modelos. O problema é que ninguém verificou os riscos de segurança e as vulnerabilidades escondidos neles. O resultado: a adoção de IA emperra quando os auditores encontram problemas nos dados.
Processado por IA de ZDNet AI; editado por Hamidun News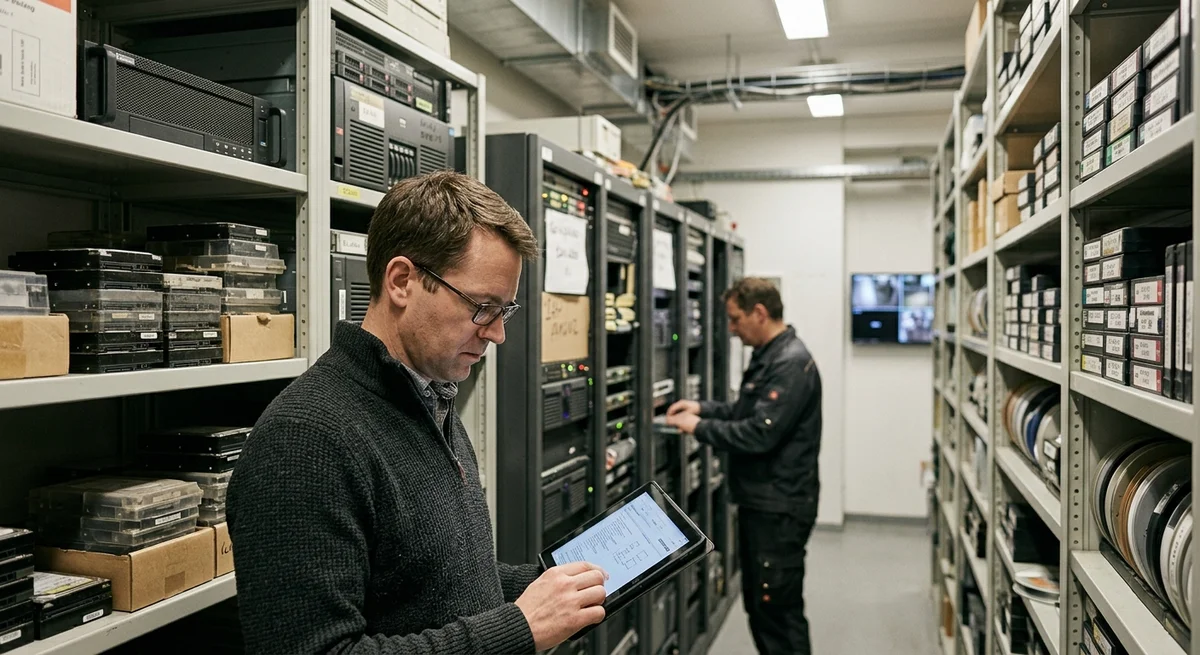
As empresas têm pressa para implantar sistemas de IA e, na correria, pegam todos os dados disponíveis para treinar seus modelos, inclusive arquivos com vários anos ou até mais. E ali há muitas surpresas desagradáveis, capazes de derrubar o projeto inteiro na reta final.
Por que os dados antigos viraram ouro de repente
Até pouco tempo atrás, as empresas guardavam dados históricos sem motivo específico, pelo princípio de "pode ser que um dia sirva". Mas, com a explosão da IA, esses arquivos viraram de repente um recurso valioso. Os modelos precisam de dados em quantidades enormes, e os arquivos já contêm milhões de registros. Por que passar anos coletando dados novos se a base histórica já está pronta?
Além disso, dados antigos costumam representar padrões de longo prazo: tendências que se repetem ano após ano e exceções que ensinam o modelo a lidar bem com edge cases. Isso reduz o tempo de desenvolvimento e o custo de coletar dados novos.
A lógica é atraente, mas dados arquivados de 5–10 anos atrás nunca foram verificados à luz dos padrões atuais de segurança e privacidade.
Riscos escondidos nos arquivos
Quando os auditores examinam com atenção os dados antigos, eles encontram:
- Nomes completos, números de documentos e números de seguro social em texto aberto
- Registros de funcionários demitidos há 5 anos, mas não excluídos da base
- Senhas, chaves de API e tokens que foram registrados em log em texto aberto
- Dados de pessoas de outros países, o que viola o GDPR e leis locais
- Dados rotulados de forma incorreta: transações classificadas erradamente e erros nos rótulos
- Registros duplicados e contraditórios, que ensinam ruído ao modelo em vez de sinal
Quando um modelo assim entra em produção, reguladores e advogados logo encontram os problemas. Todo o trabalho congela. É preciso refazer a preparação dos dados, treinar o modelo de novo e repetir as verificações. Um projeto que deveria levar 3 meses se arrasta por um ano.
Como gerenciar o risco na prática
Há um caminho simples: passar por três etapas antes de usar dados antigos.
A primeira é uma auditoria de segurança completa do arquivo. Quem criou os dados, com quais finalidades e quando? Eles contêm informações confidenciais? Atendem aos padrões atuais?
A segunda etapa é a limpeza. Remover registros de pessoas que não concordam mais com o reaproveitamento, eliminar informações sensíveis e corrigir erros de rotulagem.
A terceira etapa é a documentação: de onde vieram os dados, por quanto tempo foram coletados, quem os rotulou e quais premissas estão embutidas.
As empresas costumam pular esses três passos na correria e pagam o
preço em atrasos de meses e retrabalho.
O que isso significa
Implantar IA não é apenas uma questão de engenharia e algoritmos. É gerenciar os dados como um ativo. Dados antigos exigem o mesmo cuidado (ou mais) com segurança e qualidade que os novos. A pressa na implantação quase sempre sai mais cara do que o tempo gasto em preparação e verificação.
Perguntas frequentes sobre a notícia
Por que os dados antigos viraram ouro de repente?
Até pouco tempo atrás, as empresas guardavam dados históricos sem motivo específico, pelo princípio de "pode ser que um dia sirva". Mas, com a explosão da IA, esses arquivos viraram de repente um recurso valioso. Os modelos precisam de dados em quantidades enormes, e os arquivos já contêm milhões de registros. Por que passar anos coletando dados novos se a base histórica já está pronta? Além disso, dados antigos costumam representar padrões de longo prazo: tendências que se repetem ano após ano e exceções que ensinam o modelo a lidar bem com edge cases. Isso reduz o tempo d
O que se sabe sobre Riscos escondidos nos arquivos?
Quando os auditores examinam com atenção os dados antigos, eles encontram: Nomes completos, números de documentos e números de seguro social em texto aberto Registros de funcionários demitidos há 5 anos, mas não excluídos da base Senhas, chaves de API e tokens que foram registrados em log em texto aberto Dados de pessoas de outros países, o que viola o GDPR e leis locais Dados rotulados de forma incorreta: transações classificadas erradamente e erros nos rótulos Registros duplicados e contraditórios, que ensinam ruído ao modelo em vez de sinal Quando um modelo assim entra e
Como gerenciar o risco na prática?
Há um caminho simples: passar por três etapas antes de usar dados antigos. A primeira é uma auditoria de segurança completa do arquivo. Quem criou os dados, com quais finalidades e quando? Eles contêm informações confidenciais? Atendem aos padrões atuais? A segunda etapa é a limpeza. Remover registros de pessoas que não concordam mais com o reaproveitamento, eliminar informações sensíveis e corrigir erros de rotulagem. A terceira etapa é a documentação: de onde vieram os dados, por quanto tempo foram coletados, quem os rotulou e quais premissas estão embutidas. As empresas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.