Mistral lança Search Toolkit para busca em aplicações de AI
A Mistral AI lançou o Search Toolkit, um framework para production search em aplicações de AI. A ferramenta reúne ingestion, retrieval e evaluation sob uma interface única. O projeto é open source e roda em qualquer ambiente: cloud, on-premises e edge. A premissa é simples: hoje as equipes passam semanas integrando ferramentas em vez de melhorar a qualidade da busca.
Processado por IA de Mistral AI News; editado por Hamidun News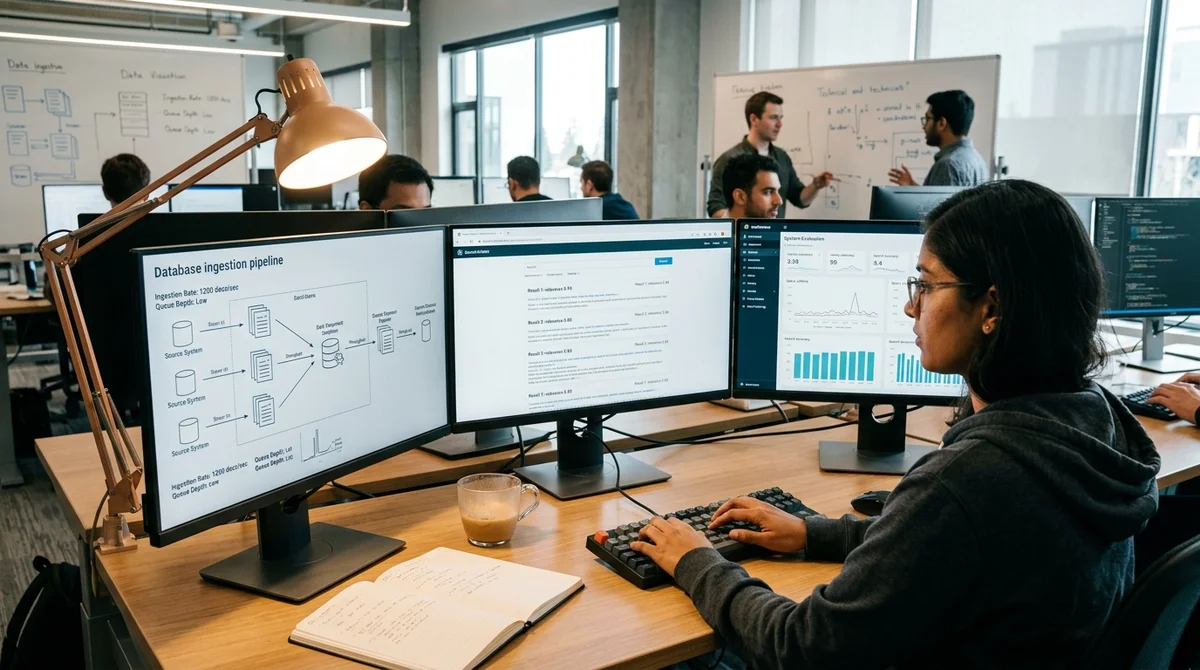
A Mistral AI lançou o Search Toolkit, um framework aberto para construir production search pipelines em aplicações de AI. A ferramenta reúne ingestion, retrieval e evaluation em uma única interface. Assim, as equipes podem se concentrar na qualidade da busca em vez de integrar serviços diferentes. O framework roda em qualquer lugar: na nuvem, on-premises e em dispositivos edge.
O problema: integração em vez de melhorias
Hoje, as equipes que constroem sistemas de busca gastam tempo demais com "encanamento". É preciso uma ferramenta para carregar os dados (ingestion), outra para a busca (retrieval) e uma terceira para avaliar os resultados (evaluation). Cada uma tem sua própria interface e suas próprias suposições sobre o formato dos dados. O resultado: as equipes passam semanas montando a integração antes mesmo de fazer a primeira busca nos próprios dados.
O problema se agrava no nível enterprise, quando uma corporação busca em uma dúzia de fontes ao mesmo tempo: wikis internas, sistemas de suporte, repositórios de documentos, file storage e bases de código. Cada fonte tem uma estrutura diferente e exige uma lógica de parsing própria. As equipes acabam construindo um pipeline separado para cada fonte ou escrevendo uma camada frágil de unificação, que vira um pesadelo de manutenção.
O Search Toolkit muda essa abordagem: um único framework com interface unificada para as três etapas.
Como funciona na prática
O framework foi desenvolvido para três casos de uso principais:
- Enterprise search — as organizações podem adicionar novas fontes sem reconstruir todo o pipeline. Os mesmos padrões de processamento e indexação funcionam para diferentes tipos de fonte.
- RAG e qualidade de retrieval — quando um sistema RAG retorna resultados ruins, não fica claro onde está o problema: no retrieval ou na geração. Normalmente, as equipes ajustam prompts e estratégias de chunking às cegas. O Search Toolkit inclui avaliação integrada para medir a qualidade do retriever independentemente do modelo.
- Busca especializada — documentos jurídicos, prontuários médicos, relatórios financeiros e bases de código exigem estratégias diferentes das usadas em web search. Retrievers off-the-shelf não dão conta de terminologia especializada e de critérios de relevância específicos. Até agora, as empresas construíam uma custom retrieval infrastructure do zero, o que é caro e difícil de manter.
Agentes e dados em tempo real
Agentes que lidam com tarefas corporativas precisam ter acesso ao contexto de toda a organização. Eles tomam decisões de busca de forma autônoma e em grande volume, então a qualidade da infraestrutura de busca por trás deles afeta cada etapa downstream.
O Search Toolkit permite que os agentes façam busca semântica nos índices, com resultados precisos e baixa latency. Ao mesmo tempo, por meio dos Connectors, os agentes podem puxar dados live diretamente das fontes.
O que isso significa
O Search Toolkit tira do caminho uma boa parte do trabalho de engenharia. Em vez de passar semanas integrando ferramentas diferentes, as equipes começam a construir sistemas de busca imediatamente.
Para empresas que estão implementando RAG e agentes de AI em sistemas internos (gestão do conhecimento, RH, finanças, suporte técnico), isso significa um go-to-production mais rápido e mais tempo para o que realmente importa: a qualidade dos resultados de busca.
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 30 de out. de 2026Mistral abre os pesos do Large 4: forte em código, mas chineses marcam 32 pontos contra 26
- 30 de out. de 2026Claude Enterprise ganha relatórios inteligentes: quem usa IA, como usa e quanto isso custa
- 30 de out. de 2026SkyRL e vLLM refinam o Mistral Large 4 com RL: AIME sobe de 64% para 75%
Perguntas frequentes sobre a notícia
O que se sabe sobre O problema: integração em vez de melhorias?
Hoje, as equipes que constroem sistemas de busca gastam tempo demais com "encanamento". É preciso uma ferramenta para carregar os dados (ingestion), outra para a busca (retrieval) e uma terceira para avaliar os resultados (evaluation). Cada uma tem sua própria interface e suas próprias suposições sobre o formato dos dados. O resultado: as equipes passam semanas montando a integração antes mesmo de fazer a primeira busca nos próprios dados. O problema se agrava no nível enterprise, quando uma corporação busca em uma dúzia de fontes ao mesmo tempo: wikis internas, sistemas de
Como funciona na prática?
O framework foi desenvolvido para três casos de uso principais: Enterprise search — as organizações podem adicionar novas fontes sem reconstruir todo o pipeline. Os mesmos padrões de processamento e indexação funcionam para diferentes tipos de fonte. RAG e qualidade de retrieval — quando um sistema RAG retorna resultados ruins, não fica claro onde está o problema: no retrieval ou na geração. Normalmente, as equipes ajustam prompts e estratégias de chunking às cegas. O Search Toolkit inclui avaliação integrada para medir a qualidade do retriever independentemente do modelo.
O que se sabe sobre Agentes e dados em tempo real?
Agentes que lidam com tarefas corporativas precisam ter acesso ao contexto de toda a organização. Eles tomam decisões de busca de forma autônoma e em grande volume, então a qualidade da infraestrutura de busca por trás deles afeta cada etapa downstream. O Search Toolkit permite que os agentes façam busca semântica nos índices, com resultados precisos e baixa latency. Ao mesmo tempo, por meio dos Connectors, os agentes podem puxar dados live diretamente das fontes.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.