LLM locales
Los LLM locales son modelos de lenguaje que se ejecutan directamente en tu propio hardware — un portátil, un PC con GPU o un servidor casero — sin nube, sin suscripciones y sin que los datos salgan de tu máquina. Ollama, llama.cpp y LM Studio, junto con las versiones GGUF cuantizadas de Llama, Qwen y Gemma, lo hacen posible incluso en una tarjeta gráfica de hace una década. Aquí está toda nuestra cobertura sobre ejecutar IA en local: guías, pruebas de hardware, cuantización y privacidad.
Soberanía de IA: ¿mito o realidad en la era de la globalización?
La aspiración por una "IA soberana" se está convirtiendo en una tendencia global. Los gobiernos de todo el mundo planean invertir aproximadamente 1,3 billones de…
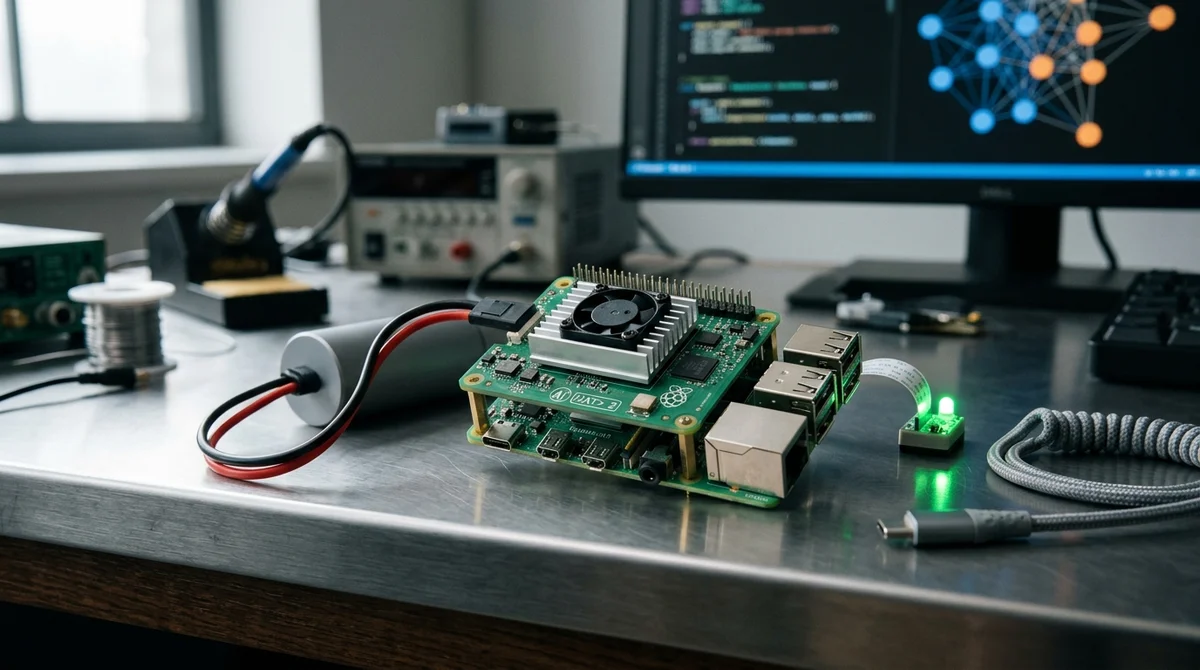
Raspberry Pi lanza una placa para ejecutar IA generativa de forma local
Raspberry Pi está apostando por la inteligencia artificial local con el lanzamiento de su nueva placa de expansión AI HAT+ 2.