MarkTechPost
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
Liquid AI lanzó un sistema para ejecutar agentes de AI totalmente en el dispositivo
Liquid AI presentó el modelo LFM2-24B-A2B y la aplicación LocalCowork, un conjunto para ejecutar flujos de trabajo complejos de agentes de AI sin una sola llamada a la nube. La privacidad pasa a ser un principio arquitec
Yuan 3.0 Ultra: un billón de parámetros con eficiencia récord
La china YuanLab AI presentó un modelo multimodal abierto con un billón de parámetros, pero que activa solo 68,8 mil millones de ellos. Una reducción de un tercio en los parámetros junto con un aumento del 49% en la efic
Alibaba lanza OpenSandbox, un entorno unificado para la operación segura de agentes de AI
Alibaba ha abierto el código de OpenSandbox, una herramienta que ofrece a los agentes de AI sandboxes aisladas para ejecutar código, navegar por la web y entrenar modelos. Es una apuesta por un estándar para toda la infr
Alibaba lanzó Qwen 3.5 Small — modelos compactos para funcionar directamente en dispositivos
La nueva serie de modelos de Alibaba, de 0,8 a 9 mil millones de parámetros, desafía la carrera por el tamaño. La filosofía de «más inteligencia, menos cómputo» podría cambiar las reglas del juego para el AI móvil.
SHAP-IQ: un nuevo estándar de AI explicable llega al uso práctico
La biblioteca SHAP-IQ permite no solo evaluar la importancia de las variables de un modelo, sino también entender cómo interactúan entre sí. Explicamos por qué esto cambia el enfoque de la interpretación del aprendizaje
Google presenta STATIC: búsqueda generativa 948 veces más rápida
Google AI desarrolló un framework basado en matrices dispersas que acelera la decodificación en sistemas de recomendación generativos casi mil veces. Esto podría cambiar el enfoque de las recomendaciones a escala industr
Alibaba presenta CoPaw — una estación de trabajo para escalar agentes de AI
El equipo de Alibaba lanzó el framework open-source CoPaw, que convierte la máquina local del desarrollador en un entorno completo para ejecutar agentes autónomos de AI con memoria y flujos de trabajo multicanal.
Unified Latents: Google DeepMind encuentra una forma de mejorar la generación por AI
El nuevo framework Unified Latents de Google DeepMind resuelve el dilema entre la calidad de la compresión de datos y la precisión de las redes neuronales.
Sakana AI aprendió a adaptar instantáneamente modelos de lenguaje sin fine-tuning
El laboratorio tokiota Sakana AI presentó dos métodos — Doc-to-LoRA y Text-to-LoRA — que permiten adaptar grandes modelos de lenguaje a nuevos datos en fracciones de segundo, sin fine-tuning clásico.
Perplexity lanza pplx-embed: modelos de embeddings que cambian las reglas de la búsqueda
Perplexity presentó la familia multilingüe de modelos de embeddings pplx-embed, basada en Qwen3 con atención bidireccional, y afirma que establece un nuevo estándar de calidad para la búsqueda a escala de internet.
Liquid AI desafía la carrera por modelos más grandes: la arquitectura híbrida de LFM2 cambia las reglas
La startup Liquid AI presentó un modelo de 24 mil millones de parámetros que combina el mecanismo de atención con convoluciones. El objetivo es resolver los problemas de escalabilidad a los que se enfrenta toda la indust
Composio libera el código de Agent Orchestrator, una herramienta para sistemas multiagente más allá de ReAct
La startup Composio ha publicado un orquestador de agentes de código abierto que aborda el principal problema de la AI en producción: la fragilidad de los ciclos simples de ReAct. El nuevo enfoque promete flujos de traba
El modo WebSocket de OpenAI cambia las reglas del juego para la AI de voz
OpenAI presentó un modo WebSocket para la Realtime API que elimina al principal enemigo de los agentes de AI de voz: la latencia. Tres etapas separadas del procesamiento de voz ahora se comprimen en un solo flujo.
Taalas desafía a las GPU: lógica cableada en lugar de flexibilidad para 17.000 tokens por segundo
La startup canadiense Taalas apuesta por lo que la industria de chips de AI consideraba una herejía: sustituir las GPU programables por chips especializados de lógica cableada. El resultado: 17.000 tokens por segundo.
TruLens: cómo dejar de confiar ciegamente en los LLMs y empezar a medir la calidad
Los modelos de lenguaje siguen siendo cajas negras para la mayoría de los desarrolladores. TruLens ofrece un conjunto de herramientas que hace que cada paso del funcionamiento de un LLM sea transparente y medible, desde
Google propone pensar con más profundidad, no durante más tiempo — y reduce a la mitad los costos de inferencia
Investigadores de Google y la Universidad de Virginia demostraron que una cadena de razonamiento larga no es necesariamente mejor. La nueva métrica Deep-Thinking Ratio permite aumentar la precisión de los LLM y recortar
Google DeepMind presentó Lyria 3 para crear música a partir de fotos
El nuevo modelo Lyria 3 de Google DeepMind supone un avance en la generación de audio. Ahora, la AI puede crear pistas completas con voz y letra usando solo fotos o descripciones de texto.
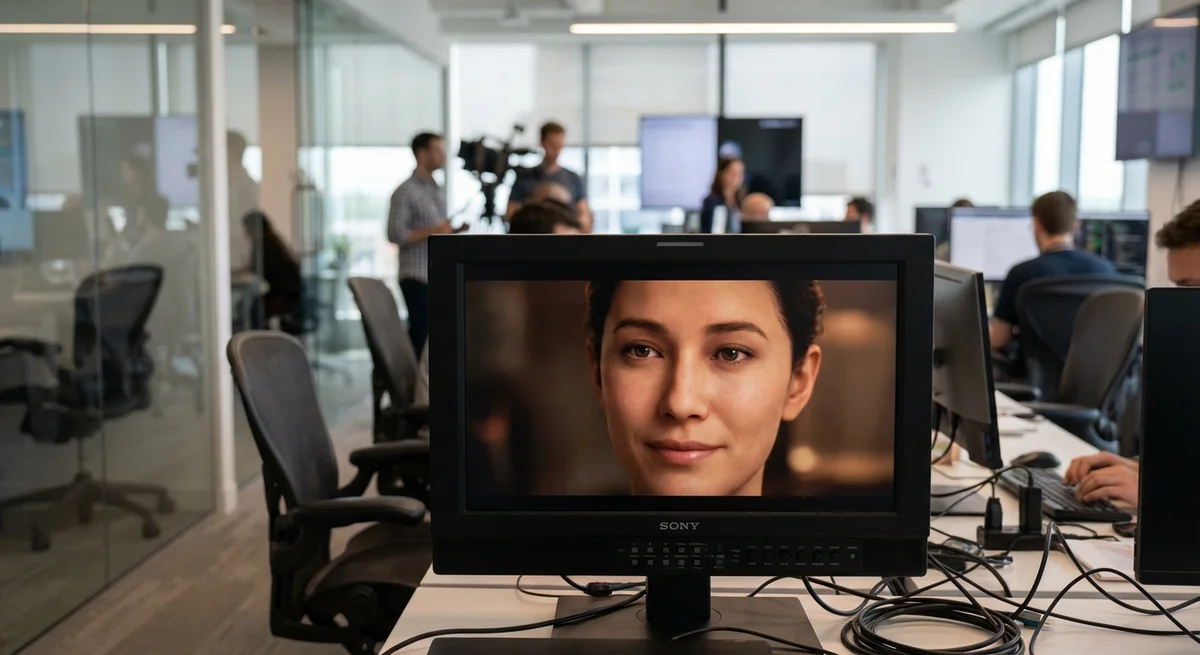
Tavus presenta Phoenix-4: avatares de video con emociones realistas y respuesta instantánea
El nuevo modelo Phoenix-4 supera el efecto del «valle inquietante» al añadir inteligencia emocional a los avatares digitales y reducir la latencia de generación a un récord de 600 milisegundos.
Anthropic presenta Claude 4.6 Sonnet con una ventana de contexto de 1 millón de tokens
Anthropic entra en la era de los modelos de razonamiento. Claude 4.6 Sonnet recibió una ventana de contexto de 1 millón de tokens y un innovador sistema de verificación de hechos mediante ejecución de código.
Google DeepMind presentó un framework para la delegación inteligente de tareas entre agentes de AI
Los investigadores desarrollaron un sistema para crear una “agentic web” segura, donde los programas autónomos podrán interactuar de forma eficiente y escalar.
Google presentó WebMCP: un nuevo estándar para la interacción de agentes de AI con la web
Google presentó el protocolo WebMCP, que permitirá a los agentes de AI interactuar con sitios web directamente a través de la estructura del código, evitando el análisis de capturas de pantalla, lento y costoso en recurs
Arquitectura de la memoria: cómo enseñar a los agentes de AI a recordar lo importante y razonar de forma lógica
Un análisis de un nuevo concepto de memoria para redes neuronales: la transición del simple almacenamiento del historial de diálogos a bases de conocimiento estructuradas para un análisis profundo de datos.
Guía para crear un pipeline de datos sintéticos con CTGAN y SDV
Descubre cómo construir un sistema confiable de generación de datos tabulares que garantice una alta precisión y preserve todos los patrones estadísticos para el entrenamiento seguro de redes neuronales.
Cómo entrenar AI con preferencias humanas: guía de DPO y QLoRA
Un nuevo tutorial muestra cómo ajustar modelos de lenguaje a las preferencias humanas de forma eficiente sin usar modelos de recompensa pesados, con una sola GPU.
Google Gemini 3 Deep Think: nuevo récord en pruebas de inteligencia general
Google presentó Gemini 3 Deep Think. El modelo obtuvo un 84,6% en la prueba ARC-AGI-2, acercando a la industria a la creación de AGI mediante mecanismos de razonamiento lógico profundo.
OpenAI presentó GPT-5.3-Codex-Spark: una revolución en la velocidad del desarrollo de software
OpenAI lanzó un modelo ultrarrápido para programación. Gracias a los chips de Cerebras, genera 1.000 tokens por segundo, 15 veces más rápido que las versiones estándar.
Cómo entrenar embeddings Matryoshka para una búsqueda de datos ultrarrápida
Descubre cómo la tecnología Matryoshka Representation Learning permite reducir el tamaño de los vectores a 64 dimensiones sin una pérdida significativa de precisión en la búsqueda.
NVIDIA presentó KVTC: una tecnología de compresión de caché de LLM que acelerará 20 veces el funcionamiento de las redes neuronales
Investigadores de NVIDIA presentaron KVTC, un método innovador de compresión de KV-cache. La tecnología permite reducir el consumo de memoria 20 veces, resolviendo el principal problema de escalado de los modelos de leng
Cómo simplificar el desarrollo de redes neuronales: guía para usar Einops en cálculos con tensores
La biblioteca Einops se está convirtiendo en el estándar para trabajar con tensores en deep learning. Explicamos cómo hacer el código más limpio y evitar errores en arquitecturas de Vision y Attention.
Google presentó NAI: interfaces adaptativas basadas en Gemini para un diseño inclusivo
Google Research propone replantear la accesibilidad del software. El framework NAI utiliza agentes de AI de Gemini para adaptar al instante la interfaz a las capacidades físicas y al contexto del usuario.