Por qué GPT se equivoca al contar letras: el secreto de la tokenización
Los LLM procesan el texto como una secuencia de tokens numéricos, no como letras individuales. Eso explica una paradoja curiosa: GPT puede confundirse fácilmente al contar las letras de palabras como strawberry. Entender la tokenización es clave para escribir prompts más eficaces, anticipar con precisión el comportamiento extraño de los modelos, optimizar la ventana de contexto y trabajar con textos multilingües.
Procesado por IA desde Habr AI; editado por Hamidun News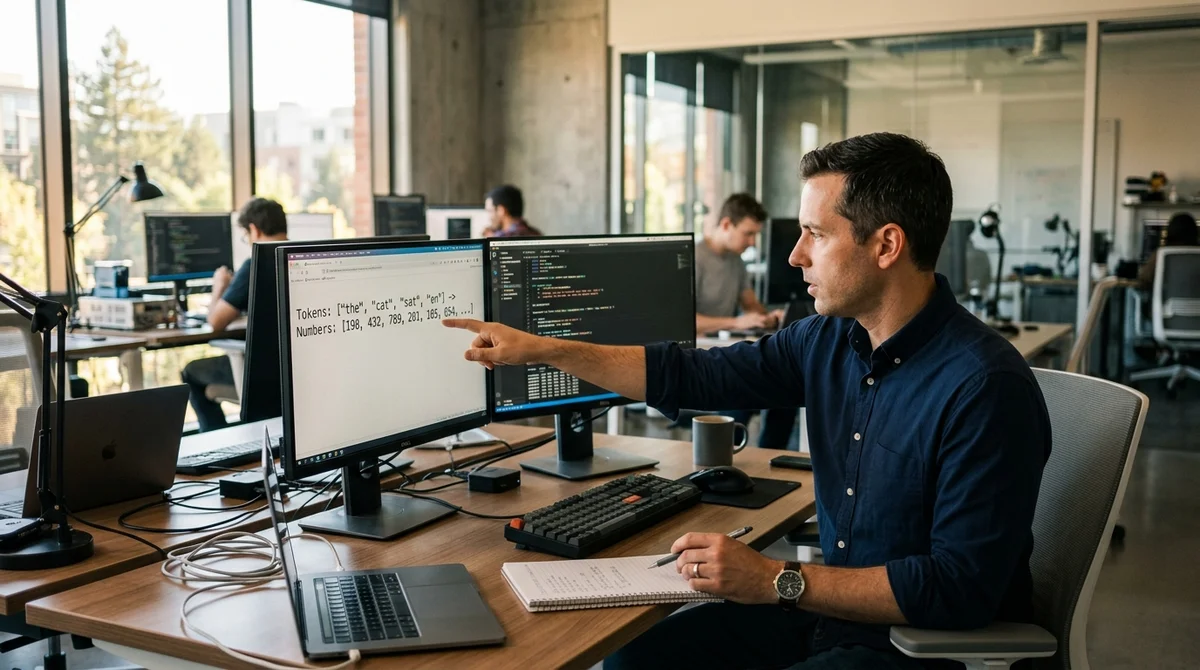
Cuando escribes un prompt en ChatGPT, ves texto normal formado por letras. Pero el modelo ve algo muy distinto: una secuencia de números llamados tokens. Esa discrepancia provoca efectos extraños. GPT puede no saber cuántas letras tiene la palabra strawberry o confundirse en un conteo sencillo.
Cómo ven el texto los LLM
Para una red neuronal, el texto no es un conjunto de letras, sino una secuencia de códigos numéricos. Cada token corresponde a un número, y el modelo trabaja solo con números, sin ver nunca la letra en sí. Es como leer un libro a través de un sistema que primero convierte las palabras en códigos; tú procesas esos códigos y después vuelven a convertirse en texto.
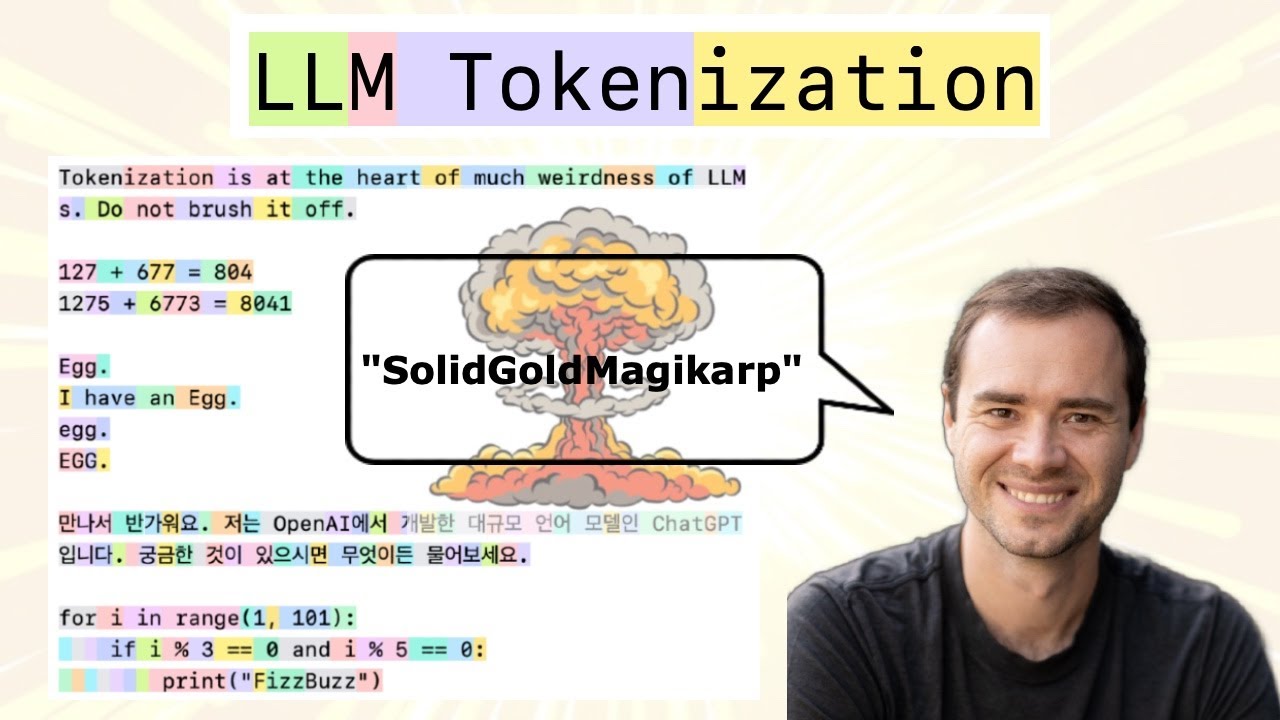
Una palabra frecuente puede ser un único token, mientras que una palabra rara se divide en varios fragmentos. Por ejemplo, «hello» se codifica con un solo número, mientras que «strawberry» puede ocupar tres o cuatro. En ruso la situación es aún más complicada: su rica morfología hace que las palabras se dividan de forma menos eficiente.
Por qué esto genera problemas
La diferencia entre cómo ven el texto las personas y cómo lo ve el modelo provoca toda una serie de inconvenientes:
- Errores al contar: GPT no puede contar letras sin más, porque trabaja con números y no con caracteres
- Ilegibilidad de las palabras raras: las combinaciones de letras poco comunes se dividen en varios tokens y el modelo las ve como fragmentos separados
- Asimetría entre idiomas: el inglés se tokeniza de forma más eficiente que el ruso, el chino o el árabe
- Consumo de contexto: si una palabra se divide en 3 tokens en lugar de 1, tu prompt ocupa más espacio en la ventana de contexto
- Comportamiento impredecible: el modelo puede comportarse de forma extraña con números, códigos y nombres poco comunes, porque están troceados
El algoritmo entre bastidores
Detrás de la tokenización está el algoritmo Byte Pair Encoding (BPE). Funciona así: primero, el texto se divide de modo que cada carácter sea un token independiente. Después, el algoritmo busca qué pares de caracteres aparecen con más frecuencia y los fusiona en un nuevo token. A continuación busca los pares más frecuentes entre los tokens resultantes y vuelve a fusionarlos. El proceso se repite miles de veces.
Como resultado, el vocabulario de GPT contiene unos 50 mil tokens. Las palabras y fragmentos de palabras frecuentes son tokens propios; las combinaciones de letras raras quedan fragmentadas. No es perfecto, pero resulta más eficiente que codificar cada letra por separado.
Qué significa esto
Entender la tokenización cambia la forma de trabajar con los LLM. Si sabes que el modelo se confundirá al contar letras, puedes pedirle que lo haga de otra manera: por ejemplo, que primero escriba las letras por separado y luego las cuente. No es una panacea, pero ayuda a escribir prompts más fiables.
Conocer la tokenización también resulta útil para optimizar prompts largos: puedes prever dónde el modelo «desperdiciará» tokens. Es importante para cualquiera que trabaje a fondo con LLM, desde los ingenieros de prompts hasta los desarrolladores de aplicaciones basadas en redes neuronales.
- 12 nov 2026Jensen Huang deja el cargo de CEO de Nvidia: la empresa pierde 1,4 billones de dólares en dos semanas
- 12 nov 2026El sindicato de Oakland logra reciclaje profesional en lugar de despidos por la IA: 94,1 % a favor de la huelga
- 12 nov 2026Ocho países, OpenAI y Anthropic prometen un «interruptor de emergencia» para los modelos de IA, pero sin plazos ni sanciones
- 12 nov 2026OpenAI y ModRetro lanzan una consola de 200 dólares para juegos creados en Codex
Preguntas frecuentes sobre la noticia
Cómo ven el texto los LLM?
Para una red neuronal, el texto no es un conjunto de letras, sino una secuencia de códigos numéricos. Cada token corresponde a un número, y el modelo trabaja solo con números, sin ver nunca la letra en sí. Es como leer un libro a través de un sistema que primero convierte las palabras en códigos; tú procesas esos códigos y después vuelven a convertirse en texto. Una palabra frecuente puede ser un único token, mientras que una palabra rara se divide en varios fragmentos.
¿Qué se sabe sobre Por qué esto genera problemas?
La diferencia entre cómo ven el texto las personas y cómo lo ve el modelo provoca toda una serie de inconvenientes: Errores al contar: GPT no puede contar letras sin más, porque trabaja con números y no con caracteres Ilegibilidad de las palabras raras: las combinaciones de letras poco comunes se dividen en varios tokens y el modelo las ve como fragmentos separados Asimetría entre idiomas: el inglés se tokeniza de forma más eficiente que el ruso, el chino o el árabe Consumo de contexto: si una…
¿Qué se sabe sobre El algoritmo entre bastidores?
Detrás de la tokenización está el algoritmo Byte Pair Encoding (BPE). Funciona así: primero, el texto se divide de modo que cada carácter sea un token independiente. Después, el algoritmo busca qué pares de caracteres aparecen con más frecuencia y los fusiona en un nuevo token. A continuación busca los pares más frecuentes entre los tokens resultantes y vuelve a fusionarlos. El proceso se repite miles de veces. Como resultado, el vocabulario de GPT contiene unos 50 mil tokens.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.